
在折叠屏手机市场,三星和谷歌的旗舰产品各有拥趸,但一次海滩度假让我彻底想明白了:**为什么下一部折叠屏我会选 Pixel 11 Pro Fold,而不是 Galaxy Z Fold 8**。 ## 度假中的意外发现 当时我正在海滩享受假期,却面临一个尴尬的选择:带哪部手机?三星 Galaxy Z Fold 8 虽然坚固,但它的**防尘等级仅为 IP48**,意味着只能抵御大于 1 毫米的固体颗粒。海滩上的细沙显然不在保护范围之内。YouTube 上不乏用户抱怨,带着 Z Fold 8 去海滩后,铰链里进了沙子,发出“嘎吱”声,虽然未必立即损坏,但足以让人提心吊胆。 于是我临时换用了 Pixel 10 Pro XL,它的 **IP68 防尘防水等级**让我彻底安心。这次经历让我意识到,**防尘能力对于折叠屏手机来说,可能比想象中更重要**。 ## 折叠屏的“阿喀琉斯之踵” 折叠屏手机的结构决定了它比传统直板机更脆弱,铰链和屏幕之间的缝隙是灰尘和沙粒的天然入口。三星虽然为 Z Fold 8 加入了钛合金铰链和更坚固的内屏,却忽略了防尘这一关键细节。相比之下,谷歌的 Pixel 折叠屏系列一直坚持 IP68 等级,虽然机身偏厚重,但在可靠性上更胜一筹。 ## 我的选择 当然,Pixel 11 Pro Fold 并非完美,它的尺寸和重量仍是短板。但对我来说,**可靠性优先于便携性**。在真实使用场景中,你永远不知道下一秒会不会遇到沙尘环境,而 IP68 带来的安心感,是任何参数都无法替代的。 如果你也经常出入海滩、沙漠或工地,那么 Pixel 11 Pro Fold 或许比 Z Fold 8 更适合你。毕竟,手机是拿来用的,不是拿来供着的。
随着太空发射资源日益紧张,轨道数据中心初创公司Starcloud宣布完成2.5亿美元的A轮融资扩展,公司估值达到23亿美元。这笔资金将用于扩大制造设施,并推进其最大的轨道数据中心航天器Starcloud-3的研发,该航天器计划搭载SpaceX的星舰火箭发射。 Starcloud首席执行官Philip Johnston表示,公司正积极锁定发射能力,因为SpaceX的猎鹰9号火箭计划于2028年退役,而星舰火箭尚未完全成熟,其他竞争对手的火箭也尚未进入稳定飞行阶段。Starcloud已向美国联邦通信委员会申请运营8.8万颗卫星,并计划在2027年通过拼车飞行发射两颗新一代8千瓦计算卫星(Starcloud-2),为美国政府机构提供轨道推理服务。 Johnston对星舰火箭的快速复用能力充满信心,但SpaceX近期宣布将推迟星舰回收尝试,这给卫星运营商的发射计划带来了更多不确定性。轨道数据中心的概念旨在利用太空环境(如太阳能、散热优势)提供AI推理服务,以补充地面数据中心。然而,高昂的发射成本和火箭可靠性问题仍是行业面临的主要挑战,甚至有初创公司选择自研火箭。 Starcloud的融资和市场布局反映了太空计算领域的竞争加剧,企业纷纷寻求确保发射能力,以抢占太空计算先机。
近日,美国司法部(DOJ)对知名风险投资公司 Andreessen Horowitz(a16z)展开调查,起因是该公司两位合伙人分别担任了相互竞争的公司董事:Ben Horowitz 在 Databricks,Martin Casado 在 Fivetran。表面上看,这似乎只是普通的董事会席位重叠,但司法部已依据一部 112 年前的反垄断法对此调查了近一年,这部法律极少被用于风险投资领域。 董事会冲突并非新鲜事,这些公司最初获得 a16z 投资时也并非直接竞争对手。然而,随着投资组合公司不断拓展业务边界,进入彼此的市场,司法部的关注引发了一个更广泛的问题:当投资组合公司的竞争边界不断移动时,风险投资公司应如何管理董事会席位? 在 TechCrunch 的 Equity 播客中,Kirsten Korosec、Anthony Ha 和 Sean O Kane 深入探讨了 a16z 调查案,分析了其对风险投资行业的潜在影响,并讨论了本周其他重要新闻:Stripe 以 75 亿美元收购 AI 模型路由器 OpenRouter 的原因;OpenAI、Anthropic 和 Nvidia 拉开差距后,夹在中间的 AI 公司何去何从;Rivian 分拆公司 Also 融资 1.5 亿美元押注自动驾驶;Uber 与无人机公司 Zipline 的合作及其对依赖 Uber 的自动驾驶初创公司的影响;以及 AI 转录应用 Wispr 以 20 亿美元估值融资 2.8 亿美元,是否意味着该领域估值已达顶峰。
几年前,我不慎摔倒导致左手腕骨折,无法正常打字,转而尝试使用 Windows 自带的语音输入工具,但效果并不理想。如今,我发现了 Wispr Flow,这款支持 Windows、macOS、iOS 和 Android 的 AI 语音转文字工具,让我眼前一亮。它免费版就足够好用,识别精准,操作流畅,彻底改变了我对语音输入的印象。 ## 为什么 Wispr Flow 能脱颖而出? 相比系统自带的语音输入,Wispr Flow 的优势在于 **AI 驱动的智能处理**。它不仅能准确转写语音,还能自动添加标点、纠正语法错误,甚至根据上下文调整措辞,让口述内容直接变成书面化文本。 ## 实际体验:从怀疑到依赖 刚开始,我以为它和普通语音输入差不多,但实际使用后发现,**Wispr Flow 的响应速度和准确率远超预期**。对着麦克风说话,几乎零延迟地看到文字出现在屏幕上,而且错误极少。无论是写邮件、记笔记,还是撰写长文,它都能轻松应对。 ## 免费与付费:够用就好 Wispr Flow 提供免费版和付费版。免费版已经覆盖了核心功能,对于日常使用完全足够。付费版则解锁更多高级功能,比如自定义词汇、更多语言支持和云端同步等。对于大多数用户,**免费版就能带来显著的生产力提升**。 ## 适用场景与建议 - **办公效率**:开会时快速记录要点,回复邮件不再费时。 - **创作写作**:口述灵感,让思路流畅输出。 - **无障碍辅助**:为手部受伤或行动不便的用户提供便利。 如果你也苦于打字慢或语音输入不准确,不妨试试 Wispr Flow。它或许不能完全替代键盘,但在很多场景下,确实能成为你的得力助手。
近日,包括 Matti Haapoja 和 Sam "Kold" Kolder 在内的多位知名影视内容创作者,发布了一系列展示 AI 平台 Higgsfield 功能的视频,重点介绍了其新增的 Seedance 2.5 功能,并将这些技术描述为视频制作的未来。然而,这些视频未标注为广告,且创作者未回应是否收费的疑问,引发粉丝不满。随后,其他创作者曝光了 Higgsfield 公关公司发出的合作邀请截图,进一步证实了付费推广的猜测。粉丝纷纷指责 Haapoja 和 Kolder 与 Higgsfield 合作,认为他们为了利益牺牲了内容独立性。Haapoja 的视频类似电视购物广告,展示了 Higgsfield 制作的电影《Cully Hill Boys》及 AI 换脸效果;Kolder 的视频则名为《AI 正在取代我》,以虚构故事形式呈现 AI 对视频制作的影响。尽管 Higgsfield 公关经理事后承认创作者获得了金钱和积分补偿,但这场风波已对创作者的公信力造成损害。此事反映了 AI 技术在内容创作领域的快速渗透,以及创作者在商业合作与观众信任之间的艰难平衡。随着 AI 工具日益普及,如何透明化赞助内容、避免误导观众,成为行业亟待解决的问题。
随着AI深度伪造技术日益成熟,仅凭视听验证身份已不再可靠。专家建议,回归传统验证方法,如使用共享秘密或预先约定的口令,可能是更有效的防御策略。本文探讨了AI克隆带来的新型安全威胁,并介绍了低科技验证手段在防范高价值交易欺诈中的关键作用。
随着Meta AI眼镜销量暴涨,公共场合被悄悄录像的担忧也随之升温。一款名为Zuckoff的免费应用应运而生,专门用于检测Meta AI眼镜,帮助人们避免在不知情的情况下被拍摄。Ars Technica的最新报道聚焦了这一现象,揭示了技术进步与隐私保护之间的新矛盾。 ## 当AI眼镜成为“隐形摄像头” Meta Ray-Ban智能眼镜自推出以来,凭借其时尚外观和AI功能迅速走红。然而,其内置的摄像头也让一些人感到不安——它太小,难以被察觉,旁人可能完全不知道自己正在被录制。这种“隐形拍摄”能力引发了公众对隐私的强烈关注,尤其是在更衣室、洗手间等敏感场所。 ## Zuckoff:一款“反侦察”工具 Zuckoff的名字取自Meta CEO马克·扎克伯格(Mark Zuckerberg)的姓氏,带有明显的戏谑意味。这款应用利用无线信号检测技术,扫描周围是否存在Meta眼镜发出的特定蓝牙或Wi-Fi信号,从而提醒用户附近可能有人佩戴该设备。尽管它无法直接阻止录制,但至少能提供预警,让用户有机会采取防范措施。 ## 隐私与便利的博弈 这一现象折射出AI硬件普及过程中的典型困境:功能强大的设备往往伴随着隐私风险。Meta眼镜的AI功能——如实时翻译、物体识别、语音助手——为用户带来极大便利,但同时也让“被监视感”成为社会焦虑的新来源。类似地,此前Google Glass因隐私争议而折戟,如今Meta眼镜似乎正在重蹈覆辙,尽管其市场表现更为强劲。 ## 行业与监管的回应 目前,Meta尚未对Zuckoff的检测方法发表评论,但业内人士指出,这类检测工具的兴起可能促使硬件厂商调整信号设计,以规避检测,形成“猫鼠游戏”。与此同时,多国立法机构开始关注智能穿戴设备的隐私合规问题,例如欧盟《人工智能法案》对生物识别数据收集的严格限制,可能在未来对AI眼镜的销售和使用产生深远影响。 ## 小结 Zuckoff的走红并非偶然,它代表了公众对AI技术边界的一种自发监督。在技术快速迭代的当下,如何在创新与隐私之间找到平衡,不仅是企业需要回答的问题,也是整个社会面临的挑战。对于普通用户而言,保持警惕、了解自身权利,或许是应对AI时代隐私风险的第一步。
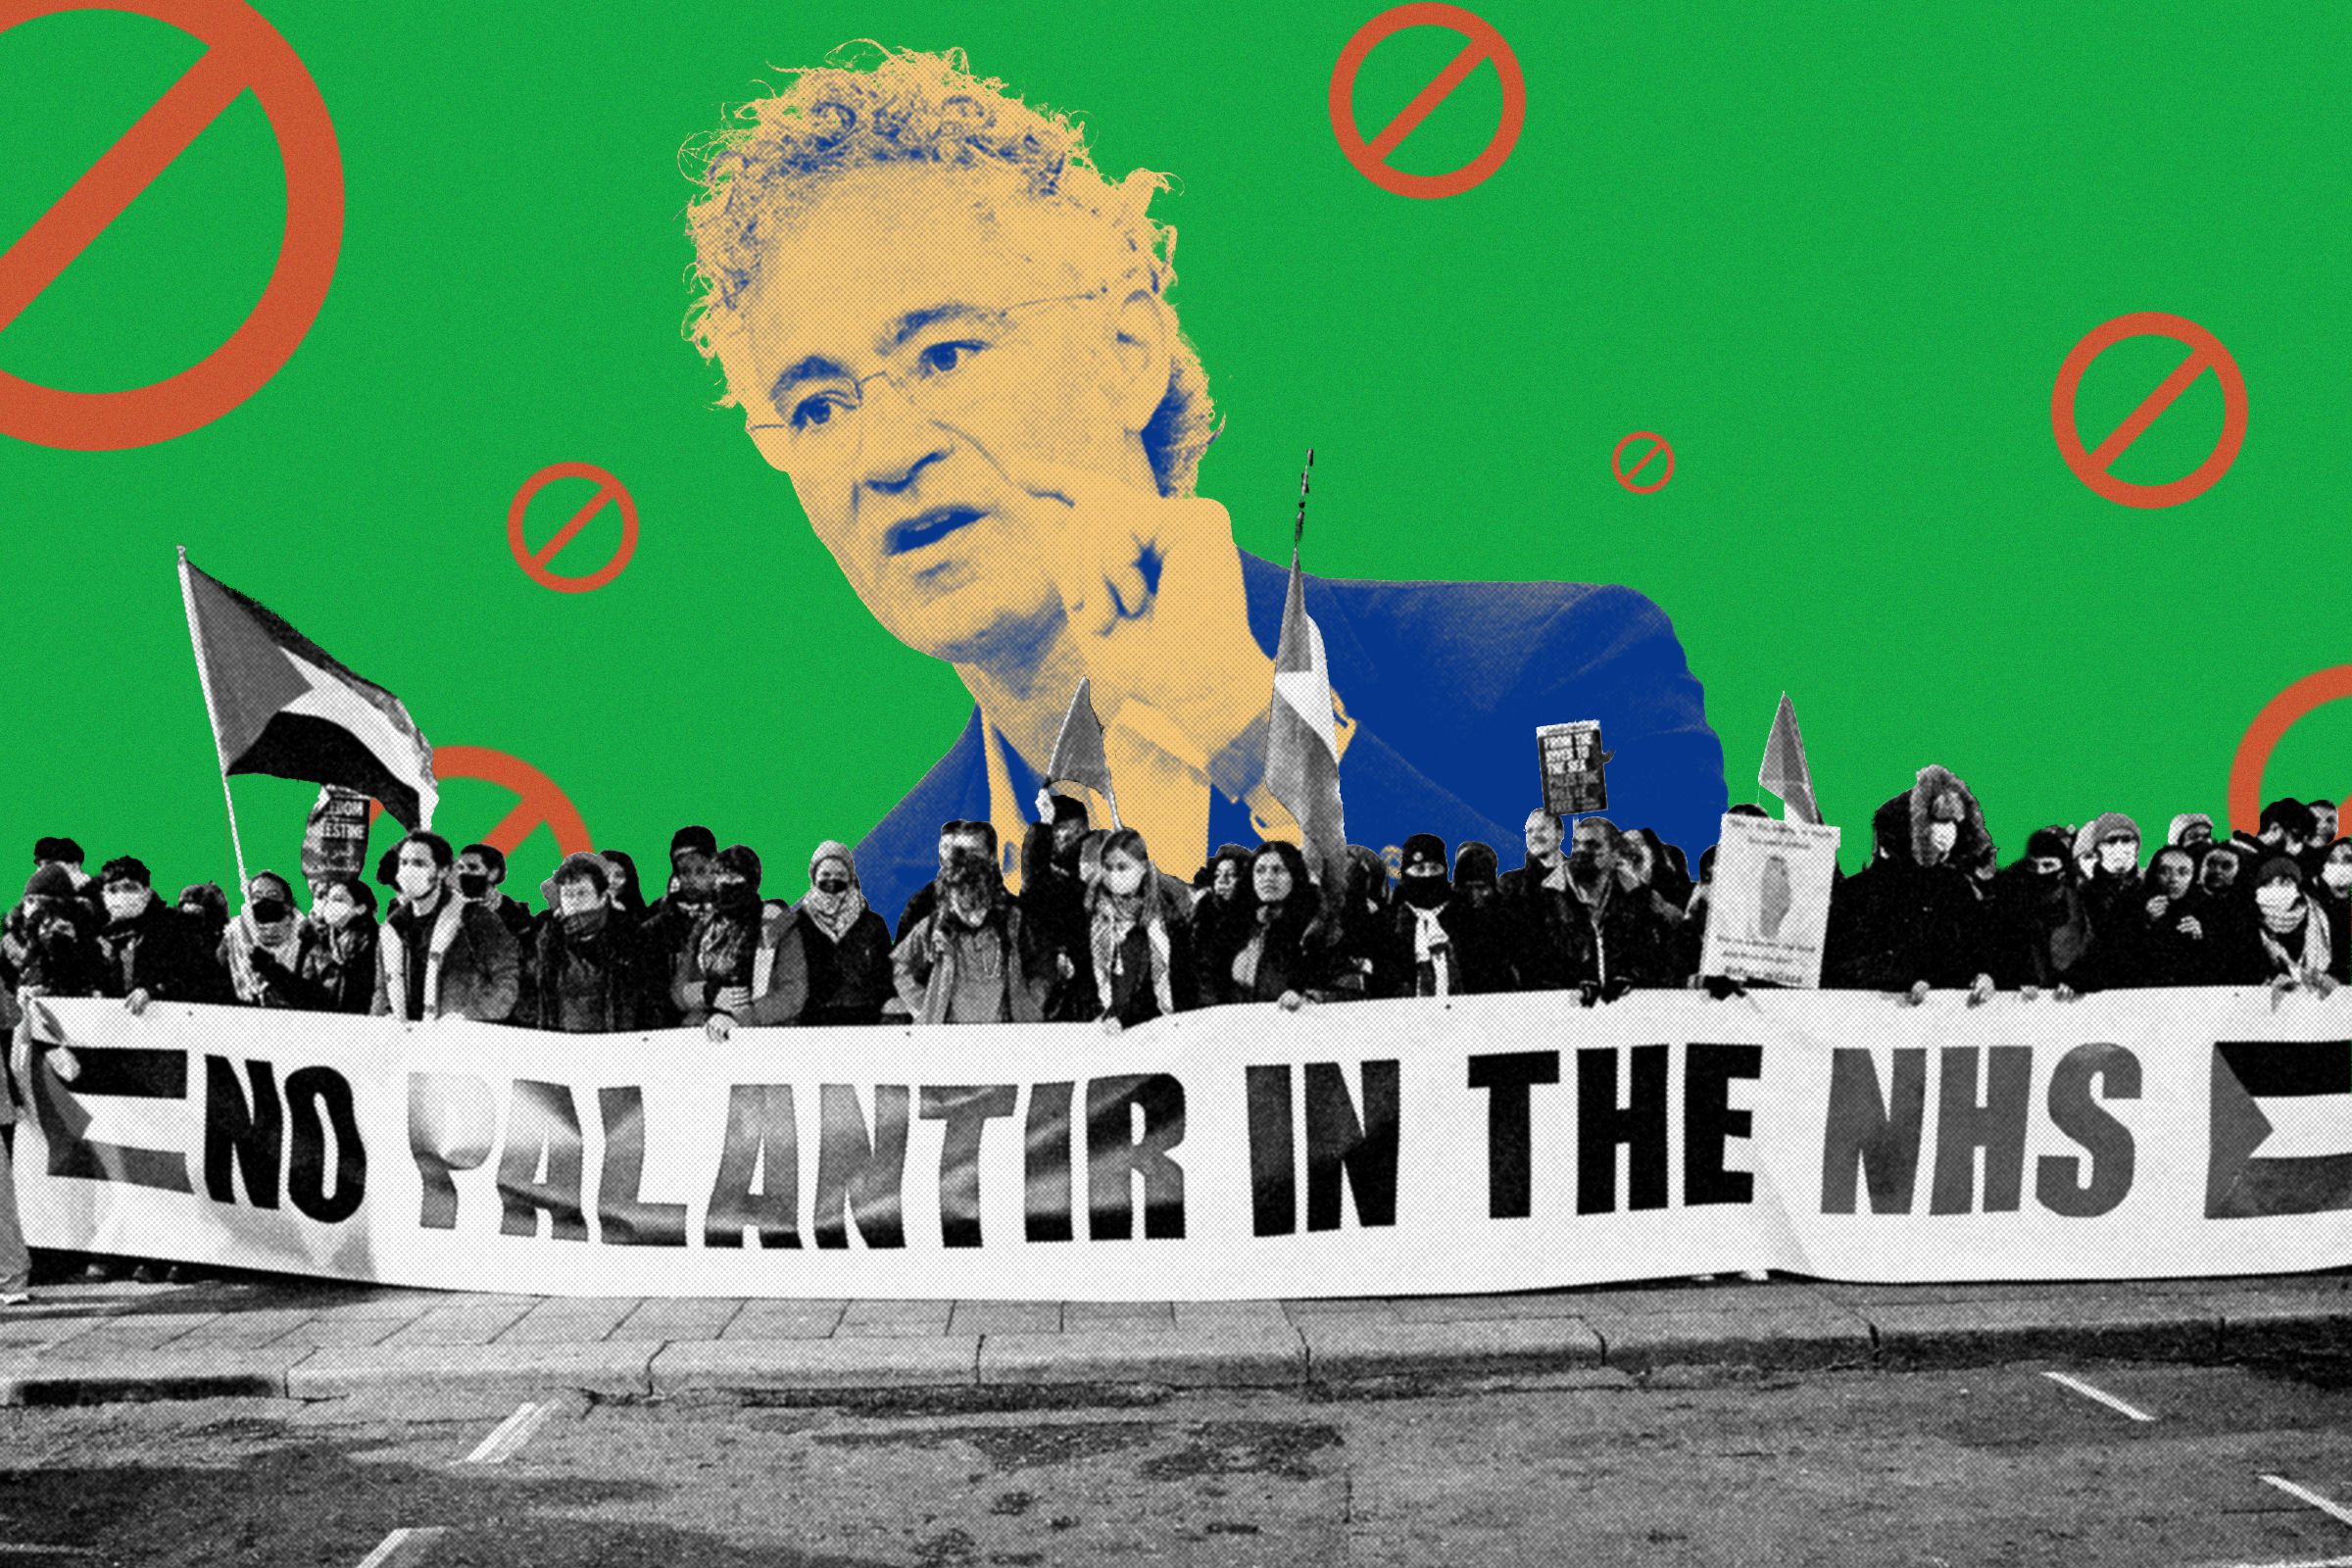
英国政府正面临取消与Palantir签订的庞大医疗合同呼声,而大曼彻斯特地区坚持认为其自研平台更优。 ## 背景:Palantir与NHS的争议合同 英国政府与美军工科技公司Palantir签署了一份价值超过4亿美元的合同,旨在为国民健康服务体系(NHS)开发“联邦数据平台”(FDP),整合全国医疗数据。Palantir和NHS声称,新系统已缩短候诊时间、减少住院时长,并优化手术室使用。然而,随着Palantir技术被用于战争和移民执法,这一合同在英国引发抗议、请愿和议会调查,部分NHS员工甚至表示反抗。 ## 大曼彻斯特的拒绝:自研平台的优势 在此背景下,英格兰的大曼彻斯特地区多次拒绝采用Palantir的FDP,坚持使用本地开发了近十年的平台。NHS大曼彻斯特首席数据与分析官Matt Hennessey表示,即使技术再强大,如果临床医生、数据控制者或公众不信任,平台也难以发挥价值。他认为,全面采用FDP将是“倒退的一步”。 ## 争议与未来抉择 Palantir及其支持者对此提出异议,但大曼彻斯特的立场已引发全国辩论:政府是否应在明年2月提前终止NHS合同,而不是等到2031年?多年来,NHS员工依靠数字系统、电子表格、纸张和白板记录患者信息,跨机构共享不畅时有发生,甚至导致致命后果。缺乏有效信息共享,NHS管理者难以做出合理的资金和资源分配决策。 大曼彻斯特的案例表明,本土化解决方案可能在信任和适应性上更具优势,但也有人质疑其功能是否真的优于Palantir。这场博弈不仅关乎技术选择,更涉及数据主权、公共信任和对美技术依赖等深层问题。随着其他欧洲国家重新评估与Palantir的关系,英国的选择或将成为风向标。
空中客车公司携手法国国家信息与自动化研究所(INRIA)等机构,在最新研究中提出了一种基于监督式机器学习模型的直升机起飞重量估算方法,并展示了其在传统航电计算机上的可行部署。该成果已提交至2026年5月举行的垂直飞行协会(VFS)第82届年度论坛与技术展示会,相关论文以预印本形式发布于arXiv平台。 ## 研究背景与核心思路 直升机起飞重量是飞行安全的关键参数,直接影响性能计算、载荷配置和告警触发。传统估算依赖物理模型和飞行员经验,难以适应复杂工况。研究团队利用空客全球在役机队的海量运行数据,训练了一个长短期记忆(LSTM)递归神经网络,以端到端方式学习重量与飞行参数间的非线性关系。 ## 适航合规与学习保证 航空安全对机载软件有严苛要求。该研究严格遵循欧洲航空安全局(EASA)关于机器学习应用的概念文件,并与正在制定中的EUROCAE ED-324标准对齐。论文提出了一套完整的机器学习需求(MLR)、模型描述(MLMD)及实现验证流程,覆盖从数据管理、模型训练到部署验证的全生命周期,确保可解释性和可追溯性。 ## 关键发现与行业意义 实验表明,该LSTM模型能在传统航电计算机(如老旧型号的飞行管理计算机)上高效运行,推理延迟满足实时性要求,具备用于机载告警等关键功能的潜力。这意味着无需更换硬件,即可通过软件升级引入智能估算能力,大幅降低部署成本。 从行业视角看,这一进展标志着机器学习正从地面数据分析走向机载实时决策。空客此前已在飞行预测维护中应用AI,此次将AI嵌入安全关键路径,对适航认证体系提出了新挑战。EUROCAE ED-324的推进,正是为这类应用提供标准化框架。 ## 局限与展望 尽管结果积极,但论文也承认,当前验证主要基于仿真和地面测试,实际飞行环境下的鲁棒性仍需进一步验证。此外,模型对数据分布的依赖意味着,极端气象或异常载荷场景下的表现可能需额外训练。未来工作将聚焦于多机型泛化、模型压缩以及与现有告警系统的深度融合。 这项研究为AI在航空安全关键领域的落地提供了可参考的范本,预示着机载智能将从辅助功能逐步迈向核心控制环节。
在复杂系统的决策过程中,信息往往带有模糊性与不确定性,三角模糊数(TFN)因此成为常用的建模工具。然而,当面对量纲或尺度各异的属性时,传统距离度量通常需要先做归一化处理,这既增加了流程复杂度,也可能引入偏差。近期,一篇发表于 arXiv 的论文提出了一种名为 **三角模糊重缩放距离(d_TR)** 的新度量,巧妙地将线性重缩放(LRE)嵌入距离计算本身,从而在比较模糊数的同时完成归一化,为异构模糊数据的分析提供了更简洁、稳健的解决方案。 ## 核心思想:让归一化融入距离计算 传统做法中,距离度量通常假设数据处于同一尺度,因此面对异构属性时,需要预先进行标准化。而 d_TR 的设计理念是:在进行距离计算时,直接对每个维度应用线性重缩放,使得最终的距离值天然不受原始尺度影响。这意味着,无论是温度、价格还是评分,只要它们以三角模糊数表示,d_TR 都能在统一框架下进行公平比较,无需额外的预处理步骤。 ## 理论性质:严格数学证明的可靠性 论文不仅提出了概念,更给出了严谨的数学证明。作者证明了 d_TR 满足度量空间的所有基本性质: - **非负性**:任意两个模糊数之间的距离始终大于等于零; - **同一性**:两个相同的模糊数距离为零; - **对称性**:距离不依赖于比较方向; - **三角不等式**:满足直递性,确保距离的合理性。 此外,d_TR 还具备**有界性**、**尺度不变性**和**原点不变性**。这些性质使得 d_TR 在数学上成为可靠的度量工具,为后续应用奠定了坚实基础。 ## 应用前景:从合成指标到机器学习 论文指出,d_TR 特别适用于涉及异构模糊数据的场景。例如,在构建合成指标时,需要综合多个不同量纲的指标,d_TR 的尺度不变性可以避免人为设定权重或归一化带来的主观性。在基于距离的机器学习算法(如 k近邻、聚类)中,d_TR 可以直接处理模糊特征,简化数据预处理流程。此外,在多准则决策辅助(MCDA)中,决策者可以利用 d_TR 结合权重向量,优先考虑某些维度,从而更灵活地评估备选方案。 ## 局限与展望 尽管 d_TR 在理论上表现优异,但论文并未提供大规模实证对比,其在实际数据集上的性能优势仍需进一步验证。此外,线性重缩放假设数据范围已知,对于动态数据或异常值敏感的场景,可能需要更鲁棒的缩放策略。未来的研究可以探索 d_TR 与其他模糊距离度量的混合使用,或将其扩展到更广泛的模糊数类型。 总而言之,三角模糊重缩放距离为模糊数据分析提供了一种新思路,其理论上的优雅与简洁可能为相关领域带来新的工具选择。感兴趣的读者可以通过 arXiv 获取完整论文进行深入研读。
多模态大语言模型(MLLMs)在医学图像解读和短时信号分析上已展现惊人能力,然而在动态心电图(ECG)这一关键领域,它们却面临严峻挑战。长时程心电数据不仅包含复杂的时间依赖模式,还要求模型具备精准的病理定位与诊断报告生成能力。近日,一支研究团队发布了 **Holtercare-Bench**,一个专门用于评估长时动态心电图分析能力的多模态基准,并配套推出了大规模数据集 **Holtercare-23K**,为这一领域的研究提供了全新标尺。 ## 数据与基准:从788份临床记录中构建 Holtercare-23K 数据集包含 **22,980 个问答对**,源自 **788 份临床 Holter 记录**,并创新性地引入了**信号-视频-文本三模态对齐**机制。这种设计突破了以往静态图像或短时信号的局限,让模型能够同时理解心电波形、动态影像与临床文本描述,更贴近真实临床场景。 基于该数据集,Holtercare-Bench 从三个维度评估模型能力:**时间定位**(temporal localization)、**临床诊断**(clinical diagnosis)和**全局总结**(global summarization)。这意味着模型不仅要识别异常心拍,还要能定位异常发生的时间段,并生成完整的诊断报告。 ## 零样本测试:主流MLLM暴露短板 研究团队对当前领先的 MLLMs 进行了零样本评估,结果令人警醒:在超长病理序列的处理上,现有模型普遍表现不佳,性能差距显著。这暴露出当前多模态模型在电生理学领域的深层缺陷——它们大多擅长静态图像或短时信号,面对长达数小时的心电数据,难以捕捉细微的时间依赖和病理演变。 ## 微调带来显著提升 然而,研究并非止步于暴露问题。通过对代表性模型进行微调,模型的性能获得了**大幅提升**,证明 Holtercare-23K 数据集不仅可用于评测,更能作为训练语料,赋能模型掌握长时动态心电分析能力。这一结果也为后续研究指明方向:基于高质量临床数据的专项微调,是提升医疗 MLLM 实际应用价值的有效路径。 ## 意义与展望 Holtercare-Bench 的发布填补了长时动态心电基准的空白,为医疗多模态大模型提供了基础性测试平台。未来,随着更多模型在此基准上迭代优化,我们有望看到 AI 在心律失常检测、心肌缺血预警等场景中发挥更可靠的作用,真正助力临床决策。 项目代码与数据已公开,研究者可访问项目主页获取详情。
肺癌是全球癌症死亡的主要原因之一,低剂量胸部CT筛查虽能降低死亡率,但受限于筛查率、依从性和管理挑战。血液中的游离DNA(cfDNA)生物标志物作为一种补充手段,因其非侵入性和潜在的高灵敏度而备受关注。然而,肺癌的异质性以及分子信号的高维非线性特性,使得早期检测依然困难重重。 来自克利夫兰诊所等机构的研究人员,在最新提交至arXiv的论文中,探索了量子-经典混合机器学习方法在基于cfDNA的肺癌检测中的应用。该研究被CIBB 2026会议接收,展示了量子内核方法在生物信息学领域的潜在价值。 ## 研究方法:量子内核与特征编码 研究团队利用DNA片段组学和DNA甲基化数据,通过特征选择提取了20个和40个特征子集。他们采用角度和密集角度特征映射,结合多种纠缠策略,将特征编码到量子希尔伯特空间。基于保真度的量子内核通过精确态矢量模拟计算,并与预计算内核的支持向量机(SVM)和内核主成分分析逻辑回归相结合,与基于原始特征的经典SVM模型进行对比。 这一框架系统评估了编码和纠缠设计对分类性能的影响。 ## 结果:竞争性能与特定优势 在重复的保留集评估中,量子内核模型在两个数据集上均取得了有竞争力的表现。对于片段组学数据,多个20特征配置的AUC优于经典SVM基线,表明量子内核能有效捕获cfDNA片段化的非线性结构。对于甲基化数据,经典SVM的AUC最高,但部分量子模型仍具竞争力,并在某些情况下提高了特异性。 值得注意的是,将特征从20增加到40并未持续提升性能,反而增加了变异性。 ## 行业背景与展望 量子机器学习在医疗健康领域的应用尚处于早期阶段,但这项研究为量子内核方法在生物标志物检测中的可行性提供了证据。尽管量子计算硬件尚不成熟,但经典模拟下的量子内核设计思路,为处理高维复杂生物数据提供了新视角。未来,随着量子硬件的发展,这类方法有望在实际临床筛查中发挥更大作用。 不过,研究也存在局限性,如基于模拟的量子计算与真实硬件的差异,以及数据集的规模限制。研究人员建议,未来的工作应探索更高效的量子特征映射和更大的临床队列验证。
**黑盒大语言模型**(LLM)在现实世界中的安全部署高度依赖**不确定性量化**(Uncertainty Quantification, UQ)。然而,现有方法多采用零样本(zero-shot)策略,在无需标注数据的情况下生成置信度分数,但实际应用中,部署前仍需在目标数据集上评估其性能。最新研究提出,通过利用这一数据集,可以显著提升UQ的表现,且几乎不增加计算开销。 该研究由Sokhna Diarra Mbacke、Mouloud Belbahri和Gabriel Loaiza-Ganem共同完成,论文发表于arXiv(编号2608.19323)。研究者发现,现有UQ方法(如口头化置信度、多次生成法等)虽各有优势,但往往未能充分利用部署时可得的数据资源。为此,他们提出构建一个简单的**分类器**,将现有UQ分数与相似查询的正确性作为特征,预测LLM响应的正确性。这一方法在多个基准测试上**持续优于**现有分数,且额外计算量极小。 **核心思路**在于:当面对一个新查询时,分类器会参考历史数据中相似查询的结果,结合当前UQ分数,做出更精准的置信度判断。这种“数据驱动”的增强方式,使得UQ不再局限于模型自身的输出,而是融入了经验证据,从而提高了可靠性。 **实际意义**上,该方法为UQ提供了一种廉价且直接的改进途径。在医疗、金融等高风险领域,准确的不确定性估计至关重要,而该研究让开发者无需复杂改造即可提升模型的可信度。不过,研究者也指出,方法依赖初始UQ分数的质量,若初始分数与正确性关联微弱,改进空间可能受限。 总体而言,这项工作揭示了**数据集利用**在UQ中的潜力,为黑盒LLM的安全应用提供了新思路。未来,结合主动学习或在线适应,或可进一步优化分类器性能,值得关注。
**机制可解释性**(Mechanistic Interpretability)旨在揭示模型内部不直接暴露的表示状态、组件效应、交互关系以及干预响应。然而,现有的测量方法——如激活修补(Patching)、梯度计算、Hessian-向量积以及子集干预——在不同的访问权限下,针对不同的目标量,缺乏统一的数学框架。最新研究提出“机制断层扫描”(Mechanistic Tomography)概念,将测量结构统一为线性模型 y = Ax + w,其中 A 描述干预,x 是目标映射,w 包含非线性响应、采样误差和基失配。这一框架提供了一套实用流程:从低成本测量开始,在预期规模上测试留出干预,校准简单失配,并在结构残差出现时扩展测量家族。控制场景成为验证该方法的理想试验场,因为估计结果若用于指导干预,其角色类似于观测器。在双隐马尔可夫模型(HMM)实验中,控制误差随观测器误差增大而上升,而目标改善可能掩盖干扰状态的运动。在仅前向访问条件下,稀疏聚合测量能以比坐标修补更少的干预次数恢复有限效应映射;在梯度访问下,有限探针改进局部归因映射;提升测量和 Hessian-向量积能恢复一阶映射遗漏的交互,而 Tracr 实验表明所需测量家族依赖于基底选择。在 GPT-2-small 的 IOI 任务中,Name Mover 与 Negative Name Mover 的交互是三个跨组对中最大的留出预测项;而在 Qwen-2.5-7B 上,有限校准使加法拒绝响应映射足够充分,留出误差不支持成对提升。该研究为可解释性测量提供了设计原则,并强调控制导向的验证对于确保解释的可靠性至关重要。
随着神经网络在安全关键领域的广泛应用,其鲁棒性验证变得愈发重要。近日,一项发表于arXiv的研究(编号2608.19351)系统性地探讨了证明共享技术在不同场景下的有效性边界,并提出了一种名为FastCert的新方法,旨在自动优化模板分配,提升验证性能。该研究由Kanak Das、Shubham Ugare等多位学者共同完成,即将在第33届静态分析研讨会(SAS 2026)上发表。 ## 背景:鲁棒性验证与证明共享 神经网络在自动驾驶、医疗诊断等领域的部署,使得对其在对抗性攻击下的鲁棒性验证成为关键需求。不完全验证技术通过抽象中间层状态来加速验证过程,而证明共享(proof sharing)则通过在不同查询间复用这些抽象状态(即模板)来进一步提升效率。然而,模板加速的效果是否稳定?在不同网络架构、属性、数据集和训练方法下,其性能表现如何?这些问题此前缺乏系统性研究。 ## 核心发现:模板加速的局限性 该研究首先对模板加速的有效性进行了全面分析。结果显示,**模板包含率(subsumption rates)在不同场景下差异显著**,在某些情况下,模板复用几乎无法带来任何速度提升。为了解释这一现象,研究者提出了一种新的度量指标——**联合稳定神经元(jointly stable neurons)**,该指标能够预测模板加速的潜在收益。当联合稳定神经元数量较少时,模板复用策略很可能失效,这为验证工具的性能优化提供了重要参考。 ## FastCert:自动化模板分配与决策 基于上述发现,论文提出了一种名为**FastCert**的新技术。FastCert能够自动决定如何在神经网络各层之间分配模板,以最大化性能收益,同时**在模板可能无效时主动放弃使用**,避免不必要的开销。实验表明,在一系列基于覆盖设计的$L_0$验证任务中,FastCert相对于现有的模板复用技术实现了**平均1.13倍的加速**。 ## 意义与展望 这项研究不仅揭示了证明共享技术的边界,也为未来鲁棒性验证工具的优化指明了方向。通过引入联合稳定神经元指标,研究者能够更准确地评估模板复用的适用场景,而FastCert则提供了一种实用的自适应策略。随着神经网络在关键领域的进一步渗透,此类性能优化技术将有助于实现更可靠的AI系统部署。 值得注意的是,该研究目前尚未经过同行评审,其结论基于特定实验设置,实际应用效果可能因场景而异。未来,研究者计划扩展FastCert到更多验证任务,并探索与其他加速技术的结合。
阿尔茨海默病(AD)的病理演变是一个连续的生物学过程,但现有的神经影像人工智能方法多局限于横断面成像的离散诊断或临床评分预测。针对这一局限,研究团队提出了一种名为**疾病连续谱定位(DCP)**的纵向贝叶斯学习框架,能够从纵向扩散张量成像(DTI)中连续估计疾病严重程度。 ## 从离散到连续:DCP 的核心思路 DCP 将疾病严重程度建模为一个低维概率潜在变量,通过联合整合纵向观测和弱临床监督,推导出**疾病连续谱评分(DCS)**。该评分不仅量化个体在 AD 连续谱上的位置,还提供相应的不确定性度量。这种方法突破了传统分类标签的束缚,为理解 AD 的渐进性提供了更细腻的工具。 ## 实验验证与临床价值 研究团队在**阿尔茨海默病神经影像学倡议(ADNI)**队列上进行了广泛实验,结果显示 DCP 在疾病进展建模上优于现有代表性方法。进一步的分析表明,DCS 能够准确刻画疾病严重程度,展现出强临床相关性,保留纵向疾病演变信息,并能预测未来疾病转化。这些发现意味着 DCS 提供了一种量化的影像学表征,可用于 AD 进展的连续评估,超越了传统的诊断标签和临床评分。 ## 意义与展望 这项研究不仅推动了神经影像 AI 从离散分类向连续建模的转变,也为精准医疗提供了新思路。未来,DCP 框架有望扩展到其他神经退行性疾病,并整合多模态数据,进一步提升预测效能。随着纵向数据的积累和模型优化,连续疾病定位有望成为临床研究和药物试验中评估疾病修饰疗法的有力工具。
近期,OpenAI 的 Codex CLI 在 Amazon Bedrock 上使用时,因缺乏显式缓存控制而引发严重成本问题,用户报告费用高达正常水平的 10 倍。该问题在 GitHub 上引发热议,获得 145 分和 61 条评论,凸显了 AI 编码工具在云环境中的成本管理挑战。 ## 问题根源 根据 GitHub 问题 #37674,Codex CLI 0.147.0 版本在调用 Bedrock Mantle 服务时,无法启用 GPT-5.6 Sol 的显式提示缓存。在代理式编码工作负载中,这导致大量缓存写入令牌,推高了成本。 用户 apexethdev 提供了生产环境数据:在 2026 年 8 月 5 日至 8 日期间,共发起 **3,656 次请求**,产生 **1.7194 亿缓存写入令牌**,估算成本 **1,182.09 美元**,占总成本约 85%。本地会话中,每次请求平均产生约 88K 缓存写入令牌,且无缓存读取。尽管 CloudWatch 指标无客户端错误,但费用依然飙升。 ## 技术原因 Codex 虽已生成会话级 `prompt_cache_key`,但 HTTP 和 WebSocket 请求均未包含 `prompt_cache_options` 或 `prompt_cache_breakpoint`。AWS Bedrock 提供的内置配置仅支持传输和认证设置,无法通过 `config.toml` 修改请求体,使用户无法自行调整缓存策略。 ## 影响与建议 此问题与 #35300 相关,但提供了原生 Bedrock 提供商的独立证据。对于依赖 Codex 进行大规模编码的团队,成本控制至关重要。建议用户密切关注 AWS 账单,并考虑在修复前使用其他模型或提供商。同时,OpenAI 和 AWS 需协作,提供明确的缓存配置选项,以避免类似成本激增。 该事件提醒我们,在采用 AI 工具时,不仅要关注功能,还需评估其云服务集成的成本效率。随着 AI 代理编码的普及,类似问题可能会更频繁出现,优化缓存策略将成为降低开销的关键。
在顶级实验室和企业对独特AI训练数据近乎无限的需求推动下,一批数据标注初创公司正迎来爆发式增长。其中,成立四年的Micro1在过去八个月内将其年度总运行率从1亿美元提升至5亿美元,净年度运行率在1.5亿至2亿美元之间。尽管仍落后于Mercor和Handshake等竞争对手,但Micro1的增长表明市场足以容纳多个玩家。随着AI数据支出有望比肩算力支出,Micro1的合同规模加速增长,利润率预期扩大,其合成数据毛利率可高达80%至90%。然而,向多个客户出售现成数据引发了争议,Micro1创始人明确表示不向中国模型制造商出售数据。
企业AI市场再起波澜。根据企业信用卡与费用管理公司Ramp发布的最新数据,OpenAI在美国企业用户中的市场份额正逐步追赶Anthropic,尽管后者自今年5月以来一直保持领先。这一动态揭示了企业AI支出的不稳定性,也为两家公司未来的IPO之路增添了变数。 ## 市场份额的微妙变化 Ramp的数据覆盖超过7万家美国企业,这些企业通过Ramp的账单支付和企业信用卡产品进行大额支出。数据显示,**截至7月,Anthropic在Ramp付费企业用户中的市场份额接近44%,而OpenAI约为40%**。值得注意的是,OpenAI曾在5月被Anthropic反超,当时Anthropic以41%对39%的份额夺走领先地位,此后OpenAI始终未能重回榜首。 不过,Ramp经济学家Ara Kharazian指出,**在第三季度迄今,OpenAI在Ramp客户中的增长速度已超过Anthropic**。尽管季度尚未结束,趋势可能随时逆转,但这一迹象表明OpenAI正在发力。 ## 企业客户为何摇摆? 企业客户在不同AI实验室之间来回切换,这一现象值得深思。Kharazian在X平台上表示,OpenAI的新模型GPT-5.6 Sol“非常出色,正日益成为开发者的选择”,而Anthropic的Fable 5“在采用率和实际应用方面令人失望,部分原因是价格及监管机构要求的数据保留期限”。 不过,这一评价可能过于简化。Fable 5作为Anthropic的高端模型,定价较高,且针对特定用例设计,而非通用聊天机器人。但Anthropic确实因要求Fable用户保留数据30天而引发争议。 ## 数据局限与行业启示 需要强调的是,Ramp的数据并非全貌。它排除了使用美国运通等供应商支出管理工具的大型企业,且Ramp作为硅谷流行的企业信用卡,其客户偏科技行业。因此,该数据更多是市场风向标,而非绝对份额。 然而,这些数据足以显示:**Anthropic并未永久锁定胜局**。企业客户愿意随着新模型的发布而切换供应商,这种波动性应当引起两家公司投资者的警惕——企业AI支出的“粘性”可能远低于预期。 ## 小结 OpenAI与Anthropic的竞争远未尘埃落定。随着双方不断推出新模型,企业市场的主导权可能持续易手。对于投资者而言,理解这一动态至关重要:在AI技术快速迭代的当下,客户忠诚度或许只是暂时的。
OpenAI 近日推出了针对 Apple Messages 的 ChatGPT 插件,允许用户将消息收件箱与聊天机器人连接,实现消息的排序、分析、编辑、删除、起草和发送等功能。该插件还支持 Codex 和 ChatGPT Work,适用于专业场景。然而,隐私问题随之而来。OpenAI 表示,插件在本地运行,不会创建完整索引,且需用户明确请求才能读取消息。但用户需启用完全磁盘访问权限,且关于数据保留的细节尚不明确。OpenAI 建议用户谨慎使用自动批准功能,以免失去发送前的审查机会。