
Summer may be ending, but Costco deals are heating up in time for Labor Day: Save big on electronics, home essentials, and more now.
最近,一篇发表在《美国医学会杂志》上的文章引发了医学界的广泛讨论。文章作者包括医学明星 Ezekiel Emanuel 和风险投资家 Vinod Khosla,他们在标题中提出的问题“自主 AI 是否会超越 AI 与医生合作,成为最佳医疗服务?”看似疑问,实则答案明确:是的。文章认为,AI 在医学领域的表现已经接近甚至超过医生和 AI 混合模式,尤其是在病史采集、诊断、检测建议、治疗处方和慢性病管理这五项基本医疗任务上。作者甚至建议医生不要干预,因为“人类在回路中会降低 AI 的表现”。 这一观点并非空穴来风。Emanuel 曾对 AI 在医疗中的作用持怀疑态度,但受同事 Robert Wachter 新书《大跃进》的影响,他开始重新思考。Wachter 在书中描绘了一个未来:头等舱医疗由 AI 与医生协作,而经济舱医疗则主要依赖 AI。Emanuel 意识到,AI 或许真的能承担大部分医疗工作。 然而,这一论断在医学界引发了复杂情绪。许多医生感到不安,担心自己的职业价值被削弱。支持者认为,AI 可以弥补人类医生的不足,提高效率和准确性,尤其是在资源匮乏的地区。反对者则指出,医疗不仅仅是技术问题,还涉及人文关怀和伦理判断。 无论如何,AI 在医疗领域的应用已是大势所趋。未来的医疗模式可能是 AI 与人类医生的协同,而非简单替代。关键在于如何平衡技术与人文,确保患者获得最佳照护。
对于学生、作家或专业人士来说,管理大量文档常常令人头疼。Paperwork 是一款免费开源的文档组织工具,支持 Linux 和 Windows,通过标签、关键词和全文搜索等功能,帮助用户高效整理和查找文档。本文将介绍 Paperwork 的核心功能和使用体验。 ## 核心功能 Paperwork 提供了一系列实用的文档管理功能,包括: - **文档导入**:支持 PDF、DOCX、ODT 等多种格式,可通过文件管理器批量导入。 - **标签与关键词**:为文档添加自定义标签和关键词,并支持自动猜测标签,简化分类流程。 - **全文搜索**:不仅可按标题搜索,还能搜索文档正文内容,提升查找效率。 - **OCR 支持**:自动识别扫描文档中的文字,便于搜索和编辑。 - **导出与属性查看**:方便导出文档,并查看文档的详细属性。 此外,Paperwork 还支持扫描仪接入、页面方向自动检测等功能,满足更复杂的办公需求。 ## 使用体验 作为一款本地优先的应用,Paperwork 不会将你的文档上传至第三方服务器,保障了数据隐私。用户只需点击“导入文件”按钮,选择所需文件(支持多选),应用便会将副本存储到本地 `~/papers` 目录中。 在测试中,作者在 Pop!_OS 上安装了 Paperwork,并导入数百份文档,发现其搜索速度和标签管理功能表现出色。对于需要长期管理大量文档的用户,这无疑是一款提升生产力的利器。 ## 适用场景 无论是学生整理学习资料,作家归档稿件,还是专业人士管理合同和报告,Paperwork 都能提供清晰的分类和快速检索能力。它尤其适合注重隐私、偏好本地存储的用户。 ## 结语 Paperwork 以简洁的界面和强大的功能,为文档管理提供了一套高效解决方案。如果你正被杂乱无章的文档困扰,不妨试试这款免费开源的跨平台工具。
汤森路透最新发布的《2026年专业人士未来报告》显示,**91%的员工认为其所在组织未能充分实现AI的价值**。该报告基于对全球1800名专业人士的调查,揭示了AI雄心与现实之间的差距日益扩大。汤森路透首席运营官Kirsty Roth指出,18个月前员工热衷于AI实验,而如今企业却因成本上升和回报不明而退缩。MIT研究甚至表明,**95%的AI项目未能交付价值**。面对AI工具的碎片化与成本压力,企业亟需从“为技术而技术”转向“以业务价值为导向”的务实策略。本文将剖析问题根源,并给出聚焦实际用例、优化流程等解决方案,帮助企业弥合AI落地鸿沟。
Roborock Qrevo 2 Pro 是一款中端扫拖一体机器人,主打免提清洁体验。它集自动集尘、自清洁拖布、20,000Pa 吸力等旗舰功能于一身,价格却仅为 599 美元(促销价 550 美元)。ZDNET 编辑在实测后发现,这款产品在性价比和功能完整性上表现突出,但在线缆避障方面仍有提升空间。
**加州联邦法官裁定,特朗普政府将 AI 公司 Anthropic 标记为“供应链风险”的行为违法,并指出此举构成“非法报复”,侵犯了宪法第一修正案赋予的权利。** 美国地区法官 Rita Lin 在周四晚间发布的裁决中表示,国防部长 Pete Hegseth 对 Anthropic 的标签决定是“任意且反复无常的”,同时违反了第五修正案的正当程序要求。这一裁决标志着 Anthropic 在与美国政府的法律对抗中取得首场胜利,而该公司在华盛顿特区的第二起诉讼仍在进行中。 ## 事件的来龙去脉 今年早些时候,Hegseth 和时任总统特朗普将 Anthropic 列为供应链风险,并下令所有联邦机构(包括非国防部门)停止与这家 Claude 模型开发商合作。这场争端的根源在于 Anthropic 对安全护栏设定了严格底线,禁止五角大楼将其模型用于完全自主的武器系统和对美国公民的大规模监控。 五角大楼否认有此类用途,并指责 Anthropic 试图控制军方对其已购买模型的使用方式。然而,法官在裁决中指出,政府的“言行证实了这些行动是基于对 Anthropic 批评政府的‘傲慢’态度进行公开示众的欲望”。 ## 裁决的关键依据 Lin 法官指出了供应链风险标签与政府其他行为之间的矛盾:Hegseth 曾提议根据《国防生产法》对 Anthropic 采取措施,这反而表明该公司对国家安全至关重要;国防部仍在寻求与 Anthropic 签订合同,并合作使用其新模型 Mythos 进行网络安全工作。此外,法院明确认定 Anthropic 在将技术交付给国防部后“无可争议地缺乏”任何后门访问权限。 “尽管战争部毫无疑问可以自由选择其 AI 供应商,但证据表明,对 Anthropic 施加的广泛措施是非法的、毫无根据的,”Lin 写道,“空洞地援引国家安全并非对政府批评者进行惩罚和报复的空白支票。” ## 行业影响与后续 Anthropic 发言人在给 TechCrunch 的声明中表示:“我们欢迎法院裁定这一供应链风险标签是非法的。我们将继续专注于与政府进行富有成效的合作,以利用 AI 保障国家安全。” 此次裁决正值 AI 公司与美国政府之间就技术安全与军事应用展开激烈博弈之际。Anthropic 的胜利可能为其他 AI 公司树立先例,表明在涉及国家安全标签时,政府不能随意压制企业合理的批评与安全立场。目前,Anthropic 在华盛顿特区的第二起诉讼仍在审理中,涉及更广泛的政府限制措施。
**Meta印度及东南亚副总裁Sandhya Devanathan将离职,加入OpenAI,负责东南亚及澳大利亚业务。** 这一人事变动正值Meta在印度面临日益严格的监管审查之际。 据TechCrunch报道,Devanathan将常驻新加坡,向OpenAI亚太区董事总经理Kiran Mani汇报,负责消费者增长、企业采用、合作伙伴关系、监管参与及运营。她将在Meta工作超过十年后离开,并曾参与公司在印度的决策过程。 Devanathan的任命紧随Prabhjeet Singh加入OpenAI担任印度负责人之后。Singh曾在Uber工作十余年,领导其印度及南亚业务。OpenAI在过去两年中积极扩展亚太布局,已在**新加坡、东京、首尔、悉尼和德里**开设办公室。 Devanathan离职后,Meta印度董事总经理Arun Srinivas将直接向亚太区副总裁Benjamin Joe汇报。Devanathan于2016年加入Meta,曾担任多个领导职位,包括亚太游戏业务负责人,并于去年6月被任命为印度及东南亚副总裁。 ## 背景:Meta在印度面临多重压力 近期,Meta在印度遭遇了一系列监管挑战。本月早些时候,Instagram错误限制总理莫迪的帖子,Meta为此道歉。印度政府因此召见了Meta高管,包括首席全球事务官Joel Kaplan。此外,**印度政府对平台上的儿童性虐待内容表示担忧**,上月BBC报道称Instagram广告被指提供此类内容,印度政府要求Meta解释。 Meta在博客中回应,已删除违规广告和账户,并否认故意针对不当兴趣的用户投放广告。该公司还表示,已在六个月内根据儿童剥削活动信号,**在印度删除了16万个账户**。 ## 分析:人才流动与监管压力 Devanathan的离职反映了AI行业对顶尖人才的吸引力,同时也凸显了Meta在印度面临的复杂局面。OpenAI通过招募熟悉当地市场的高管,加速其在亚太地区的扩张,而Meta则需在监管压力下调整管理架构。未来,两家公司在印度市场的竞争与合作将值得关注。
OpenAI 近日宣布了一项重要的技术基础设施升级——将内部服务全面迁移至 HTTPX2。这一举措在 Hacker News 上引发了广泛讨论,获得了 127 分的高热度与 53 条评论。虽然官方尚未公布详细的迁移细节,但这一动作释放出的信号值得行业关注。 ## 为什么是 HTTPX2? HTTPX 是 Python 生态中一个备受推崇的 HTTP 客户端库,以其现代化的 API、异步支持和类型安全特性著称。而 HTTPX2 作为其重大版本更新,预计将带来性能优化、连接池管理改进以及更完善的 HTTP/2 协议支持。对于像 OpenAI 这样处理海量 API 请求的 AI 巨头而言,底层 HTTP 客户端的性能直接影响着服务响应速度与稳定性。 ## 对 AI 行业的影响 OpenAI 的这次迁移,不仅是其自身技术栈的升级,更可能对 AI 行业产生连锁反应。首先,这标志着 OpenAI 对 Python 生态的持续投入,巩固了 Python 在 AI 领域的主导地位。其次,HTTPX2 的成熟和广泛应用,有望推动整个 Python 社区在异步编程和性能优化上的进步。 ## 社区反应与猜测 在 Hacker News 的评论区,开发者们纷纷猜测迁移背后的具体原因。有人认为这是为了应对日益增长的 API 调用量,提升并发处理能力;也有人推测是为了统一内部工具链,简化代码维护。尽管官方未透露具体细节,但社区普遍认为这是一次积极的技术演进。 ## 结语 OpenAI 的这次技术栈迁移,虽然看似是内部工程决策,但其背后反映的是 AI 基础设施不断优化的趋势。随着 AI 应用规模的扩大,底层技术的稳定性与性能将愈发关键。我们期待 OpenAI 后续能分享更多迁移细节,为行业提供参考。
自2023年初以来,摄影师Jingna Zhang和一小群志愿者一直在维护一个名为Cara的图像分享社交平台,该平台吸引了约150万艺术家,他们共同反对未经授权使用作品训练AI模型。Cara过滤AI图像并提供保护功能,如Glaze工具,但防止数据抓取几乎不可能。今年8月13日起,Cara遭受了三次大规模抓取,导致服务器费用飙升,引发创作者担忧。第一起事件中,一名Reddit用户抓取了1200万件作品(约12TB)并发布,引发争议。然而,该抓取者后来后悔并同意与Zhang合作开发开源工具来保护艺术家。与此同时,其他抓取者继续利用Cara的漏洞。
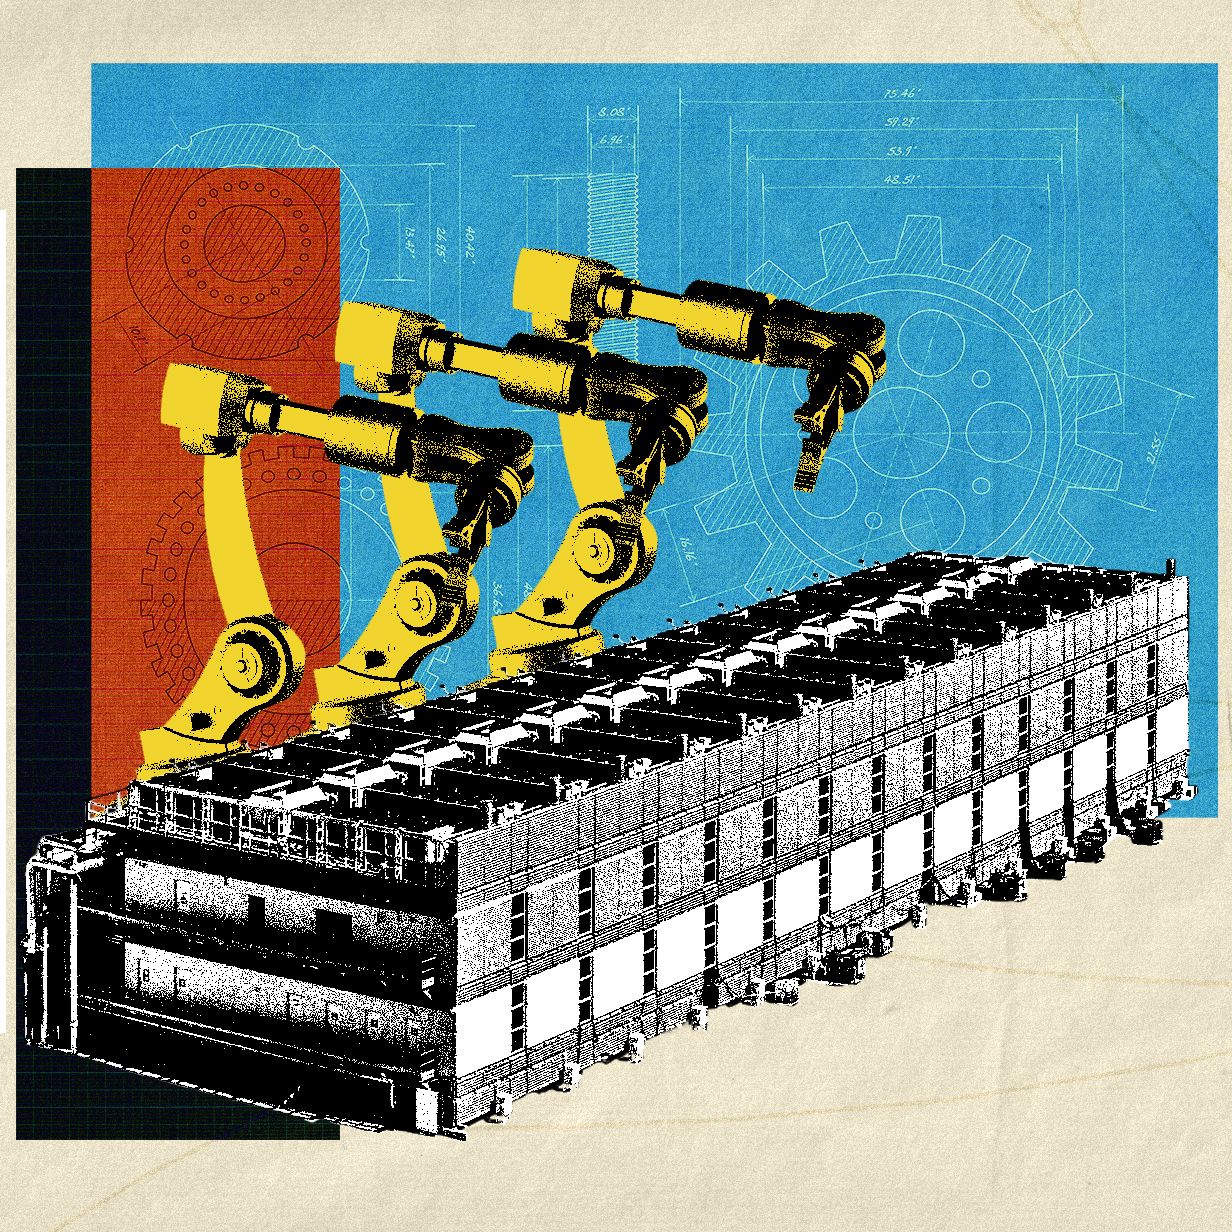
Meta正在其数据中心测试机器人,用于插拔电缆、重置服务器等任务,这可能减少人工需求,但引发员工对失业的担忧。 ## 机器人试水数据中心 据多位现任和前任员工透露,Meta正在多个数据中心试验机器人技术,包括使用**Kinova Gen3机械臂**进行服务器电源循环,以及测试另一款机器人更换网络电缆。这些设备来自**Watney Robotics**、**Kinova**和**ABB**等供应商。 一位数据中心员工估计,如果测试成功,机器人可替代**80%**的人工工作量。该员工表示:“我们曾以为体力劳动暂时安全,但现在看来并非如此。”不过,Meta发言人Francis Brennan强调,公司正在大力投资培训员工,并指出美国正面临技术工人短缺,需要更多而非更少工人。 ## 从简单到复杂的机器人应用 在一些设施中,Meta已悄悄使用一种类似手指或尖棒的简单机器人,可在远程触发下按压设备电源按钮进行重启。此外,Meta机器人高级经理Eric Xu在去年的一次会议上表示,公司的**长期目标**是将机器人引入数据中心,以加快故障响应、环境监控和预防性维护。 ## 行业背景与挑战 过去,机器人因成本高和灵活性不足,难以胜任数据中心的精细工作。但随着AI基础设施投资激增,Meta等公司寻求降低运营成本,机器人应用成为趋势。然而,这一举措也引发了对就业影响的广泛讨论,尤其是在技术工人短缺的背景下。 ## 小结 Meta的机器人试验尚处于早期阶段,但已释放出明确信号:数据中心自动化或将加速。未来,人机协作可能成为常态,但如何在效率与就业之间取得平衡,将是行业面临的重大课题。
在边缘计算与物联网设备日益普及的今天,深度神经网络在资源受限硬件上的部署成为一大挑战。**二值化神经网络**通过将权重和激活值限制为+1或-1,大幅降低内存占用和计算复杂度,使其能在FPGA和微控制器上高效运行。然而,当二值化与剪枝技术结合时,传统剪枝策略往往水土不服,难以在二值化表示中发挥效用,更难以转化为实际的硬件加速收益。 针对这一痛点,Roan Rubiales与Jean Pierre David在最新提交的论文(arXiv:2608.26233)中提出了一套**专为二值化神经网络设计的剪枝框架**,并引入了一种**全局加权剪枝算法**。该框架基于PyTorch构建,面向研究场景,集成了冻结与剪枝机制,支持对前沿方法的快速复现与评估,同时为新算法的原型开发提供了便利。 研究团队的核心创新在于,他们不再孤立地看待每一层的参数重要性,而是提出了一种**跨抽象层级的全局加权机制**。这种机制能够综合考虑不同层中参数的相对重要性,从而在剪枝时做出更优的取舍。实验结果表明,在VGG11模型上,该算法实现了**70%的剪枝率且精度保持不变**,而现有的最先进方法在二值化设定下仅能达到41%的剪枝率。这一显著优势展示了全局视角在二值化网络压缩中的巨大潜力。 该研究的价值不仅在于提出了一种新算法,更在于其提供了一个**可复现的研究平台**。在深度学习研究领域,可复现性一直是关键挑战之一,而该框架的发布有望加速二值化网络剪枝领域的进展。此外,该工作也提示我们,针对特定硬件特性设计的压缩算法,往往能带来比通用方法更显著的收益。 尽管该研究目前仍处于arXiv预印本阶段,尚未经过同行评审,但其扎实的实验设计和显著的性能提升,无疑为边缘AI的落地提供了一条新思路。未来,随着该框架的推广和算法的进一步优化,我们有理由期待在更多硬件平台上看到二值化网络的高效部署。
**Muon优化器在大型语言模型预训练中表现出色,但其理论基础一直存在争议。** 最新研究揭示,Muon使用的有限牛顿-舒尔茨(Newton-Schulz)迭代并非简单的近似误差,反而在非光滑非凸优化中带来了实质性的平滑优势。 ## 背景:Muon与理论困境 Muon专为矩阵参数设计,通过在动量上执行数次牛顿-舒尔茨迭代来近似正交化,从而加速模型收敛。然而,现有理论分析要么假设使用精确的极分解(polar factor),要么将有限的迭代步数视为近似误差,导致理论保证弱于实际性能。这引发了一个核心问题:**Muon实际运行的有限迭代是否可能损害收敛性?** ## 核心发现:平滑性成为关键 来自研究者Mingyi Li和Taira Tsuchiya的最新论文(arXiv:2608.26288)给出了出人意料的答案:**有限牛顿-舒尔茨迭代实际上是有益的**。研究团队通过“在线到非凸转换”(online-to-nonconvex conversion)框架分析Muon,该框架将更新规则视为在线学习器,并将其遗憾界转换为平稳性保证。 关键洞察在于,**有限的牛顿-舒尔茨迭代将不连续的极映射平滑为奇异值的Lipschitz映射**,使得Muon可以视为具有平滑谱势的在线学习器。这种平滑性正是转换框架所需的:论文证明,**仅需对数增长的迭代深度即可在非光滑非凸优化中收敛到稳定点**,而使用精确极分解的Muon反而可能无法收敛。 ## 理论意义与扩展 该研究的样本复杂度界与已知最佳的非光滑非凸优化保证相匹配,且在光滑非凸情况下达到最优(除问题相关因素外)。更重要的是,**这一论证不仅限于牛顿-舒尔茨,还适用于具有相同平滑性质的一般谱映射**,为优化器设计提供了新的理论视角。 ## 实践启示 这项研究不仅填补了Muon理论基础的空缺,还提示我们:在优化算法中,**近似计算有时不仅是工程妥协,更可能带来意外的理论优势**。对于大模型训练中广泛使用的优化器,深入理解其迭代行为的平滑效应,有望指导更高效、更稳健的算法设计。 论文共37页,包含3个图,已提交至arXiv,并可能被机器学习顶级会议接收。对于优化理论和深度学习从业者而言,这无疑是一份值得细读的文献。
**标签传播(Label Spreading)** 是一种重要的半监督学习技术,它通过从少量已标注数据向大量未标注数据传播信息,有效缓解了大规模数据集标注成本高昂的问题。然而,当面对高维、大规模数据时,传统的标签传播算法因计算复杂度和内存消耗过高而难以应用。 针对这一瓶颈,来自德国的研究团队提出了一种名为 **AMELS(Algebraic Multigrid Acceleration for Efficient Label Spreading)** 的新框架,旨在通过代数多重网格求解器大幅提升标签传播的效率。相关论文已提交至 arXiv(编号:2608.26309)。 ## 核心思路:用多重网格替代随机游走 传统标签传播通常采用随机游走迭代来逐步扩散标签信息,而 AMELS 则引入了代数多重网格(AMG)求解器。AMG 是一种多层次的迭代方法,能够在不同尺度上平滑误差,从而在单个多重网格循环内将标签信息传播到整个图的任意节点,无需反复迭代。这种设计不仅显著减少了计算时间,还降低了对内存的需求。 ## 性能优势:更快、更稳、更准 实验表明,AMELS 相比现有实现具有显著的**运行时间优势**,同时对于超参数的选择更加鲁棒,无论是在运行时间还是分类准确率方面都表现出更好的稳定性。这意味着即使只有极少量的标注样本,AMELS 也能在大规模图像数据集上高效生成准确的标签。 ## 应用前景与行业意义 在大模型和深度学习日益依赖海量数据的今天,标注数据的获取成为制约模型性能的关键因素之一。AMELS 的出现为半监督学习提供了一种高效的解决方案,有望在图像分类、自然语言处理等领域加速模型训练,降低人工标注成本。尽管该研究目前仍处于 arXiv 预印本阶段,但其思路为高效标签传播提供了新的方向,值得关注。
在大语言模型(LLM)的推理阶段,如何高效地对齐模型行为与人类偏好,同时保护训练数据中的敏感信息,一直是研究热点。近期,一篇题为《Privacy Without Regret: Differentially Private Inference-Time Alignment》的论文提出了一种巧妙的方法,通过向奖励分数添加校准噪声,同时解决奖励黑客(reward hacking)和隐私泄露两大问题。 ## 核心问题:BoN采样的双重困境 **Best-of-N(BoN)采样**是推理时对齐最常用的策略之一:从模型中采样N个候选回答,用奖励模型打分,选出最高分者。然而,这种方法有两个明显缺陷: - **奖励黑客**:模型可能利用奖励模型的漏洞,生成高分但质量不佳的回答; - **隐私风险**:奖励模型通常基于敏感的人类偏好数据训练,直接使用可能泄露这些信息。 ## 关键创新:PrivBoN与PrivITP 论文提出两种新方法,均基于向奖励分数添加噪声的思路。 ### 1. PrivBoN:Gumbel噪声的双重功效 **PrivBoN**(Private Best-of-N)在奖励分数上添加适当尺度的Gumbel噪声,同时实现ε-差分隐私和KL正则化对齐。有趣的是,当隐私预算超过临界值ε*时,隐私所需的噪声恰好是遗憾最优的正则化项,这意味着隐私保护不会带来额外的对齐成本,达到了信息论下界。 ### 2. PrivITP:更稳健的隐私保护 由于ε*依赖于未知的覆盖系数,论文进一步提出**PrivITP**(Private Inference-Time Pessimism),结合χ²正则化拒绝采样和两阶段高斯机制。PrivITP实现事后(ε,δ)-差分隐私,且隐私成本与候选数量n无关,清晰解耦正则化参数与隐私参数,在噪声膨胀项内达到下界。 ## 实验验证:性能与隐私兼得 研究者在多个语言模型、数据集和奖励模型上进行了实验,结果显示: - PrivBoN和PrivITP具有**缩放单调性**,而BoN在n超过临界值后性能下降; - 在相同隐私级别下,PrivITP匹配或优于PrivBoN,尤其在强隐私保护场景下优势显著。 ## 行业意义 这项研究为推理时对齐提供了一种“免费”的隐私保护机制,可能对注重数据合规的AI应用(如医疗、金融)产生重要影响。未来,我们或许能在不牺牲模型性能的前提下,更好地保护用户偏好数据。
在AI大模型竞逐中,能力基准(如GLUE、MMLU)常被视为模型选型的金标准,但它们真的能反映模型上线后的真实表现吗?一项来自Google Cloud的新研究给出了否定答案,并提出了一种全新的评估视角——操作指纹(Operational Fingerprint)。 ## 从“能做什么”到“怎么运行” 论文《Beyond Capability Benchmarks: Learning Operational Fingerprints of LLM Cloud Services from Production Incident Metadata》指出,托管LLM服务已深度融入生产系统,但模型选择和服务规划仍过度依赖能力基准,这些基准对部署后的操作行为几乎毫无揭示。为此,研究团队提出了**OpEmbed**框架,通过分析结构化、隐私保护的支持工单元数据(不含案例文本),学习LLM云服务的紧凑操作指纹。 ## 八通道签名与对比学习 OpEmbed的核心在于将模型-时间窗口聚合成**八通道操作签名**,并利用时间对比学习、跨视图重构和代际序正则化,学习低维表征。该方法在Google Cloud**超过33,000个生产支持案例**、涵盖**七个LLM家族**、跨越**26个月**的数据上进行了评估。结果显示,OpEmbed能够恢复可解释的家族和版本级结构,并在留一模型预测中优于非学习基线,即使在早期数据有限的情况下依然有效,同时支持跨模型的故障类型迁移。 ## 从研究到实践:模型上线的“体检报告” 这项研究的价值不仅在于学术创新,更在于其工程实用性。研究团队总结了在模型上线、支持就绪评估和运维监控中应用该工具的实际经验。对于企业而言,这意味着在选择LLM服务时,除了看基准分数,还可以通过操作指纹预判其在实际运维中的表现,从而降低故障风险,提升服务稳定性。 ## 小结 OpEmbed为LLM运维提供了一种数据驱动的新工具,提醒我们:在模型能力之外,**“如何运行”同样关键**。未来,操作指纹或将成为模型评估的标准配置,与能力基准互补,共同构建更全面的LLM评估体系。
随着大语言模型(LLM)的广泛应用,其安全性评估变得至关重要。然而,现有的自动化测试方法往往依赖于响应级反馈,即每个候选提示都需要生成目标模型的响应来评估攻击有效性,这一过程既昂贵又对强对齐模型缺乏指导性。为此,研究者提出了 NeuronFuzz,一种白盒模糊测试框架,通过利用内部安全神经元作为连续执行反馈,显著提升安全性评估的效率与效果。 ## 核心创新:安全神经元作为反馈信号 NeuronFuzz 的核心在于构建一个 **SafetyOracle**,它将安全神经元的激活转换为连续的安全警报分数。这一分数在预填充阶段即可获得,无需生成完整响应,从而将响应生成从模糊测试循环中剔除,大幅降低计算成本。为了构建 SafetyOracle,NeuronFuzz 使用模板不变的恶意与良性输入,并通过稳定性感知选择,识别出一组紧凑的安全神经元,其激活能够捕捉恶意意图识别。 ## 优化策略:梯度引导与掩码语言模型 由于安全警报分数是可微分的,NeuronFuzz 利用其梯度来识别安全敏感的模板位置,并结合掩码语言模型生成流畅、上下文兼容的突变,同时保留原有的恶意载荷,避免引入额外的优化变量。这种设计使得生成的模板既保持攻击有效性,又具备自然语言的可读性。 ## 实验结果:显著提升攻击发现率与迁移性 在实验部分,NeuronFuzz 在 21 个文本和多模态模型上进行了评估。在五个白盒源模型上,它实现了 **76% 至 100%** 的越狱发现率,比基线方法高出最多 **48 个百分点**。更重要的是,其优化后的模板能够零样本迁移到开源权重模型和六个专有目标模型,平均攻击成功率(ASR)和集成攻击成功率(EASR)分别达到 **69.6%/92.6%** 和 **44.1%/60.0%**。这表明 NeuronFuzz 不仅在本模型上有效,还能跨模型泛化,展现出强大的实用价值。 ## 行业影响与未来展望 NeuronFuzz 的提出为 LLM 安全性评估提供了一种新的思路,即从内部神经元层面而非仅依赖外部响应来指导测试。这种方法不仅降低了评估成本,还提高了对强对齐模型的测试效率。未来,该技术有望被集成到自动化安全测试工具链中,帮助开发者更快速地发现和修复模型的安全漏洞。同时,它也引发了关于模型可解释性与安全性的进一步讨论,为构建更健壮的 LLM 提供了参考。 值得注意的是,该研究目前仍处于 arXiv 预印本阶段,其实际应用效果还需进一步验证。但无论如何,NeuronFuzz 展现了利用模型内部机制改进安全评估的巨大潜力。
**CG4AI** 是一种新型框架,旨在解决机器学习模型在训练后无法保证满足预设规则或约束的问题。该框架通过构建多个AI模型的凸组合,并强制组合输出满足线性约束,从而在保证可行性的同时提升模型性能。 ## 背景与挑战 传统机器学习训练过程仅优化损失函数,不保证模型输出符合特定规则。在自动驾驶、网络路由等关键应用中,这种保证至关重要。例如,分类器可能违反公平性规则,或路由预测器可能超出链路容量。 ## 核心方法 CG4AI 采用列生成(Column Generation)技术,包含一个主线性规划(LP)和一个定价子问题。主LP确定最优的模型组合权重,而定价子问题则根据LP对偶变量生成新模型,重点关注最违反约束的部分。此外,框架还集成了切割平面(Cutting-Plane)过程,将可行性保证扩展到训练集之外。 ## 实验与应用 研究者将CG4AI应用于两个问题: - **MNIST手写数字分类**:展示了约束的四种用途,包括仅从约束学习、提高对抗鲁棒性、纠正误分类样本以及强制输出重标记。 - **多商品流问题**:在神经网络路由预测器上强制链路容量约束。 实验结果表明,CG4AI能可靠地产生可行预测器,且准确性优于单模型基线。 ## 意义与展望 该框架为在关键领域部署AI提供了一种新思路,通过约束保证安全性和合规性。未来,CG4AI可能扩展到更复杂的约束类型和深度学习模型,推动AI在更多高风险场景中的应用。
图神经网络(GNN)在处理带标签的属性图时,常将节点和关系的文本、类别属性视为静态特征向量,这限制了模型根据预测目标动态选择语义证据的能力。近期,一篇题为《SLM-Conditioned Hierarchical Relation Routing for Labeled Property Graph Learning》的论文提出了一种新架构,将小型语言模型(SLM)直接集成到图消息传递的选择过程中,实现了语义信息与结构信息的深度融合。 ### 核心思路:从静态到动态的语义路由 传统GNN在处理属性图时,通常将所有属性编码为固定向量,再通过消息传递机制聚合邻居信息。这种方式忽略了不同预测任务下,属性语义的重要性可能不同。例如,在金融欺诈检测中,交易金额和交易时间等属性可能比社交关系更重要;而在推荐系统中,用户兴趣标签可能起主导作用。新架构的核心在于,利用SLM根据当前目标节点生成一个“路由查询”,动态决定哪些邻居消息和关系类型应被优先传递。 ### 架构解析:分层路由与拓扑锚点 该架构由两大部分组成: - **拓扑GNN**:提供稳定的结构表示和预测锚点,确保模型不因语义调整而丢失基础的结构信息。 - **SLM条件路由**:对于每个目标节点,将邻居的结构状态、节点属性编码、关系属性编码及关系类型组合成“结构化图软令牌”,交由参数高效的SLM处理,生成目标特定的路由查询。 路由过程分两层进行:首先在每种关系类型内部选择相关消息,然后在关系类型汇总层面进行二次路由。最终,语义调整以“有界残差更新”的形式作用于拓扑锚点,既保留了结构证据,又允许上下文语义信息对预测进行修正。这种设计还支持在邻居和关系类型两个层面进行可解释性分析。 ### 意义与展望 这项工作的价值在于,它提供了一种通用的机制,将语言模型的能力引入属性丰富的图学习任务,使得模型能够根据具体预测目标动态调整信息传播路径。相比传统方法,这种语义条件化路由有望提升在复杂属性图上的表现,并增强模型的可解释性。不过,论文目前仅公布了架构设计,尚未提供实验数据,其实际效果还需后续验证。未来,该方向可能推动图学习在知识图谱、社交网络分析、生物信息学等领域的进一步应用。
## 法院裁定:五角大楼将Anthropic列入黑名单违宪 本周四,美国加州北区地方法院法官Rita F. Lin裁定,五角大楼今年早些时候将AI实验室Anthropic列入黑名单的行为违宪。这一裁决标志着Anthropic在与特朗普政府的数月拉锯战中取得关键胜利。 ### 事件起因:军用AI的“红线”之争 事情始于今年冬天,美国国防部长Pete Hegseth决定重新谈判所有AI实验室与军方的合同,意图将五角大楼使用AI的权限扩大至“任何合法用途”。大多数AI实验室接受了新条款,但Anthropic坚持设定两条限制:禁止将其AI用于对美国人进行大规模监控,以及禁止用于致命自主武器(即无需人工监督即可击杀目标的AI系统)。 Anthropic的拒绝引发了高风险的博弈。国防部官员对Anthropic进行了连番抨击,特朗普政府最终发出最后通牒。在通牒发出后不到24小时,Anthropic CEO Dario Amodei发表声明,但局势仍然恶化,最终导致Anthropic被列入黑名单。 ### 法院裁决:报复性行为违宪 Anthropic于今年3月在加州地区法院提起诉讼,指控特朗普政府因其设定“红线”而非法报复。法官Rita F. Lin在裁决中写道:“对国家安全空洞的援引,并不是惩罚和报复政府批评者的空白支票。”她还指出,国防部长Hegseth将Anthropic指定为供应链风险的决定“任意且反复无常”。 Lin法官强调,虽然国防部无疑有权选择其AI供应商,但证据表明,对Anthropic施加的广泛措施是“非法且毫无根据的”,构成“违反第一修正案的非法报复”。 ### 行业影响与展望 这一裁决对AI行业具有重要意义。它确立了AI实验室有权在军事合作中设定伦理边界,而不会因此受到政府惩罚。分析人士认为,这可能会鼓励更多AI公司在对军方合作时明确自己的底线,同时也对政府以国家安全为名进行报复的行为构成制约。 目前,特朗普政府和五角大楼尚未对裁决作出正式回应。Anthropic方面则对法院的裁决表示欢迎,称这是“言论自由和法治的胜利”。 随着AI技术在军事领域的应用日益广泛,如何在国家安全与伦理约束之间取得平衡,将成为持续争论的焦点。此次裁决为这一讨论提供了重要的法律先例。

美国联邦法官周四否决了特朗普政府将AI公司Anthropic认定为国家安全风险的决定,称此举违宪且构成报复。加州地区法官Rita Lin在59页的裁决中,撤销了国防部长Pete Hegseth于2月27日将Anthropic列为“供应链风险”的决定,并解除了禁止承包商与Anthropic合作的额外惩罚措施。Lin写道:“尽管国防部无疑有权选择其AI供应商,但证据表明对Anthropic施加的广泛措施是非法的且毫无根据。” 该裁决还解除了包括五角大楼、财政部、国务院和国土安全部在内的九个机构对Anthropic的制裁。然而,Lin确认五角大楼无需使用Anthropic的模型,且裁决不阻止其选择其他模型。五角大楼发言人未立即回应,但预计将上诉。Anthropic发言人Danielle Cohen表示:“我们欢迎法院的裁决,该供应链风险认定是非法的。我们仍专注于与政府合作,利用AI促进国家安全。” 此案源于今年早些时候五角大楼与Anthropic之间关于价值2亿美元的军事应用合同纠纷。争议起因于报道称美国在抓捕委内瑞拉总统Nicolás Maduro的行动中使用了Claude模型。行动后,Palantir员工向美国官员转达了Anthropic员工对其模型使用方式的担忧。 该裁决对AI行业具有重要意义,表明政府不能轻易将AI公司列为安全风险而不提供充分依据。这也为AI公司如何在军事应用中平衡合作与道德考量提供了参考。专家认为,此案可能影响未来政府与AI公司的互动方式,促使更透明的评估流程。 Anthropic与五角大楼的纠纷凸显了AI技术在国家安全领域的敏感性。随着AI在军事中的角色日益重要,如何确保合规与信任成为关键。此次裁决可能鼓励AI公司更积极地维护自身权益,同时促使政府谨慎行使权力。