Nstproxy Crawl
nstproxy.com
将URL转化为可用的网页内容
2个月前制作者:Nstproxy
关于 Nstproxy Crawl
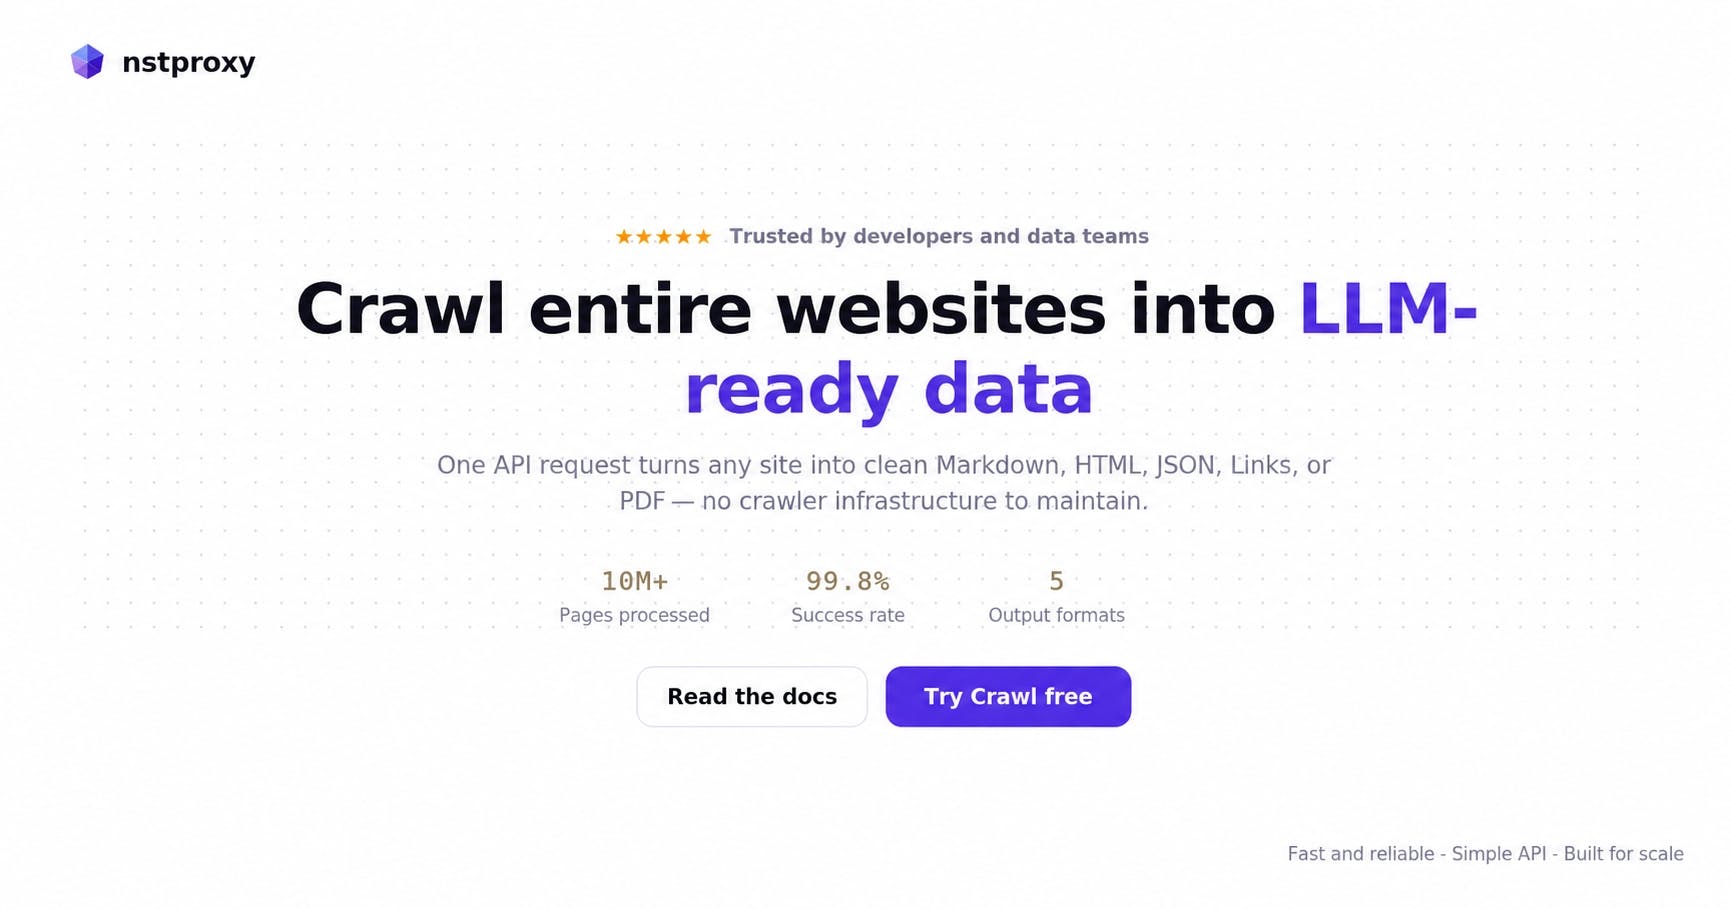
Nstproxy Crawl 是一款强大的网页内容提取工具,能够将任意 URL 或受限的网站爬取转换为 Markdown、HTML、链接、截图、PDF 或原始页面数据。它集成了智能渲染和自动重试机制,确保您轻松获取干净、结构化的数据,而无需处理复杂的反爬虫挑战。
核心功能
Nstproxy Crawl 的核心优势在于其多功能性和易用性。您只需输入目标 URL,即可快速获取多种格式的输出,满足不同场景的需求。无论是简单的页面抓取,还是复杂的整站爬取,它都能高效完成。
主要特性
- 多格式输出:支持 Markdown、HTML、链接、截图、PDF 和原始数据,灵活适配您的数据处理流程。
- 智能渲染:自动处理 JavaScript 渲染,确保动态内容也能被完整提取。
- 自动重试:内置重试机制,有效应对网络波动或临时故障,提高抓取成功率。
- 代理集成:与 Nstproxy Proxy 和 Proxy Manager 无缝协作,提供直接访问和集中式代理控制,保障抓取过程的稳定性和匿名性。
- 高效爬取:支持有界爬取,可控制爬取范围和深度,避免资源浪费。
适用场景
- 数据采集:为数据分析、市场调研等提供结构化数据源。
- 内容聚合:快速将网页内容转换为 Markdown,便于二次编辑和发布。
- 网页存档:生成 PDF 或截图,用于证据留存或离线阅读。
- SEO 分析:提取页面链接和元数据,辅助 SEO 优化。
Nstproxy Crawl 以其强大的功能和灵活的集成能力,成为开发者和数据工作者的得力助手。无论您是构建爬虫应用,还是需要快速提取网页内容,它都能显著提升效率,让数据获取变得简单可靠。