
大型语言模型(LLM)在因果推理任务中常依赖隐式语言层面的推理,导致因果假设不透明、推理路径难以验证,尤其在无上下文(context-free)的干预问答场景中表现脆弱。针对这一痛点,研究者提出 **Causal-Audit** 框架,将因果推理过程显式建模为结构化因果图上的四个模块化阶段,而非隐式的端到端预测。 ## 核心创新:目标感知因果图构建 Causal-Audit 的关键在于 **“目标感知因果图构建策略”**(target-aware causal graph construction)。传统方法在构建因果图时容易引入无关变量和虚假因果关联,而该策略将目标变量作为图扩展的核心约束,在生成过程中主动抑制与目标无关的变量和噪声关系,从而得到更精确、更简洁的因果图结构。 ## 路径级因果证据聚合机制 仅依赖单条因果链进行推理往往不够鲁棒。Causal-Audit 引入 **路径级因果证据聚合机制**(path-level causal evidence aggregation),能够同时考虑多条因果路径,并建模路径间相互增强或抵消的效应。例如,当一条路径显示“药物A→血压降低”,另一条显示“药物A→心率升高→血压升高”时,聚合机制会综合评估净效应,而非简单叠加或只取一条路径。这使得模型在面对复杂干预时能做出更稳健的决策。 ## 实验表现与可审计性 在三个基准数据集上的实验表明,Causal-Audit 在干预问答准确率上 **持续优于现有的LLM方法**,同时提供了可解释、可审计的因果推理轨迹。每个推理步骤都可以回溯到具体的因果图节点和路径,方便人类检验和调试。 ## 行业意义 这项研究对AI安全与可信赖应用具有重要价值。当前LLM在医疗诊断、经济预测、科学发现等高风险场景中应用时,因果推理的透明性直接关系到决策的可信度。Causal-Audit 通过显式因果图结构,使得模型不再是一个“黑箱”,而是能够输出人类可理解的推理链。这为未来LLM在需要严格验证的领域落地铺平了道路。 ## 小结 Causal-Audit 提出了一种新颖的显式因果推理范式,通过目标感知图构建和路径级证据聚合,在提升准确率的同时保证了推理过程的可审计性。该工作已被 **ACL 2026** 接收,标志着因果推理与LLM结合方向的重要进展。
## 当“越大越好”遇上量子计算:为何概率扩展策略在量子程序生成中失效? 在AI领域,“缩放假说”(scaling hypothesis)占据主导地位——模型参数越多,涌现的推理能力就越强。然而,一篇被ICML 2026接收的立场论文却对此提出尖锐质疑:将这种概率范式应用于通用量子电路合成,是一个方向性错误。 ### 量子电路的语言鸿沟:语法与语义的断裂 与自然语言不同,量子电路必须严格遵守数学约束。论文作者指出,量子程序存在显著的**语法-语义差距**:模型通过训练可以学会生成“看起来像”量子电路的语法结构,却无法捕捉希尔伯特空间中的物理语义。例如,一个电路可能在语法上有效(门操作排列正确),但在物理上却毫无意义(违反酉性、纠缠限制等)。 更棘手的是,随着量子比特数增加,有效电路设计空间呈指数级衰减。这意味着,试图通过**事后过滤**来剔除无效电路在数学上是不可行的——穷举验证本身就是一个指数级难题。 ### 从“人类中心”到“验证中心”:架构层面的范式转移 论文提出了一个关键转向:放弃以人类为中心的“副驾驶”模式,转而构建**以验证器为中心的智能体**。具体方案包括: - **层次化约束**:将量子力学的层级规则(如酉性、可逆性)直接编码进生成过程。 - **拓扑掩码**:限制电路拓扑结构,确保生成路径符合物理可实现性。 - **符号代理**:使用符号推理模块替代部分概率采样,确保每一步都满足数学正确性。 这些机制的本质是**在生成过程中嵌入领域知识**,而非依赖模型在事后“纠正”错误。 ### 规模无法弥合的有效性鸿沟 核心论点非常明确:**仅靠扩大模型规模无法弥合量子程序生成中的有效性鸿沟**。即使参数达到万亿级别,如果模型学习的只是语法模式而非物理语义,生成的电路依然大概率无效。这与其他AI领域(如代码生成、自然语言)的情况形成鲜明对比——在这些领域,缩放确实提升了语法和语义的准确性,因为自然语言和通用编程语言的约束相对宽松。 ### 对AI与量子计算交叉领域的启示 这项研究对当前AI+量子计算的探索具有警示意义。许多工作试图用大模型直接生成量子电路,但往往忽略了量子信息领域特有的“规则优先”特性。论文呼吁:生成方法应**编码任务特定的量子信息规则**,而非单纯模仿人类设计的电路样本。 对于研究人员而言,这意味着需要重新思考模型架构:是否应该引入可微分验证器?是否需要在潜在空间中强制施加酉性约束?这些问题的答案,可能决定了AI能否真正成为量子程序合成的有效工具。 ### 小结 在量子计算领域,“更大”并不总是“更好”。这篇立场论文提醒我们:当目标领域存在严格的数学约束时,**有效性必须优先于概率扩展**。未来的量子程序生成,或许将走上一条融合符号推理与神经网络的“验证优先”之路。
大语言模型(LLM)正逐步渗透金融领域,但它们真的能胜任技术分析吗?一篇来自佐治亚理工学院的最新研究论文对此进行了系统评估,对比了 **GPT-4 Turbo、Claude 3 Opus、Gemini 1.5 Pro、Llama 3 70B** 以及金融专用模型 **FinGPT** 在四项任务中的表现:K线形态识别、方向信号生成(买入/卖出/持有)、信号回测和财报理解。 ### 核心发现:谁更胜一筹? 在模拟回测中,**GPT-4 Turbo** 在通用模型中取得了最高的年化收益率和夏普比率,表现亮眼。而 **FinGPT** 凭借领域微调,在风险调整后收益上展现出竞争力——两者在测试条件下均跑赢了被动标普500基准。 ### 不可忽视的“暗面” 尽管成绩不俗,研究也揭示了所有模型的 **共性缺陷**: - **数字幻觉**:模型会生成不存在的数值,这在金融交易中可能造成灾难性后果。 - **上下文窗口限制**:处理长序列历史数据时,模型容易“忘记”早期信息。 - **横盘市场表现不稳**:在趋势不明显时,模型信号一致性下降。 ### 结论:潜力与现实之间 研究指出,LLM 在 AI 交易系统中确实具备潜力,但稳健部署需要 **任务分解、严格回测和领域微调**。简单拿通用模型直接“炒股”并不可取——专业金融场景仍需针对性优化。 ### 简要小结 该研究为 LLM 在量化交易中的实用性提供了宝贵基准,既展示了头部模型的能力边界,也敲响了安全与可靠性的警钟。对于从业者而言,这意味着:**模型选型需谨慎,回测流程不可少,领域知识是关键**。
## 概述 在临床诊断中,医生往往需要逐步收集信息,在诊断准确性与资源成本之间取得平衡。现有的大语言模型(LLM)方法尽管编码了丰富的医学知识,但在成本约束下难以系统推理,容易导致过度检查。针对这一问题,来自多个机构的研究团队提出了 **GraphDx**——一种知识增强的多智能体框架,旨在实现**低成本、高准确率**的序贯诊断。 ## 核心创新 GraphDx 包含两大创新: 1. **自动化医学诊断知识图谱(MDKG)构建** - 利用 LLM 自动构建知识图谱,包含**量化典型性**、**以行动为中心的拓扑结构**以及**双重目标属性**(兼顾诊断相关性与成本敏感性)。 - 图谱中的节点代表症状、疾病与检查,边则关联诊断逻辑与成本信息。 2. **三智能体协作机制** - **感知智能体**:负责自然语言理解,从患者描述中提取关键症状。 - **推理智能体**:在 MDKG 上执行确定性证据评分与成本感知规划,是系统的“决策大脑”。 - **决策智能体**:生成最终诊断建议与下一步检查方案。 这种分工设计让 LLM 专注于语言理解与生成,而推理与成本优化则交由结构化知识图谱完成,从而弥补了纯 LLM 方法的推理短板。 ## 实验结果 研究者在 **MedQA** 和 **MIMIC-IV** 两个基准数据集上进行了测试,并使用了三种不同的 LLM 基座(DeepSeek-V3、Kimi-k2、Llama-3.3)。结果显示: - **诊断成功率**:从基线方法的 50%–68% 提升至 **79%–93%**。 - **测试成本**:相比纯 LLM 方法,**降低了 20%–54%**。 这表明 GraphDx 在显著提高诊断准确率的同时,大幅减少了不必要的检查,实现了经济高效的自动化临床诊断。 ## 行业意义 GraphDx 的提出反映了 AI 在医疗领域的一个关键转向:**从“知识存储”到“知识推理”**。LLM 虽然掌握了海量医学知识,但在实际临床场景中,缺乏成本意识和推理结构。GraphDx 通过知识图谱与多智能体协作,将成本约束显式纳入决策过程,为**可解释、可负担**的 AI 辅助诊断提供了新范式。 未来,该框架有望整合更多模态数据(如影像、实验室检查),并在真实临床环境中进一步验证其鲁棒性与实用性。
医疗领域涵盖高风险沟通、专家推理和工作流执行,但能同时覆盖这些场景的专用大语言模型仍然稀缺。近日,**actAVA AI** 团队在 arXiv 上发布了 **Cura 1T**,一个通过“人类引导的自我进化循环”训练的医疗专用 LLM,旨在统一处理患者咨询、图文临床推理、交互式诊断以及电子健康记录(EHR)工具调用等任务。 ## 核心挑战:多任务冲突 通用大模型在医疗场景中常表现出“偏科”问题:一个任务的优化可能损害另一个任务的表现。例如,强化患者咨询能力可能导致临床推理准确率下降。Cura 1T 的设计目标正是解决这种多任务间的权衡困境。 ## 创新训练方法:人类引导的自我进化 Cura 1T 的训练采用了一种名为“人类引导的自我进化循环”的机制。每一轮进化包含四个步骤: 1. **规划**:训练代理根据当前能力短板,规划下一轮要强化的目标能力。 2. **训练**:针对目标能力,使用合成数据和精选数据对模型进行训练。 3. **评估**:在多个基准轨迹上评估模型表现,识别失败模式。 4. **精炼**:根据观察到的失败,调整数据混合策略,生成更有针对性的训练样本。 这种数据驱动的循环不是简单地塞入更多医疗数据,而是通过“从失败中学习”的方式逐步提升模型在关键任务上的表现,同时保持其他能力的稳定。 ## 性能表现:多领域领先 在医疗评估套件中,**Cura 1T** 在所有前沿基线中排名第一或并列第一。更重要的是,它在 **域外推理** 和 **智能体基准测试** 上也保持了竞争力,表明其通用能力并未因医疗专业化而严重退化。这打破了“专用模型必然牺牲通用性”的传统认知。 ## 行业意义 医疗 AI 落地长期面临“高精度 vs 广覆盖”的矛盾。Cura 1T 的自我进化框架提供了一种新思路:通过精细化的数据混合和迭代优化,可以在不牺牲通用能力的前提下实现领域专用。这对于电子病历系统、临床决策支持、远程问诊等场景具有直接应用价值。 目前,Cura 1T 的模型权重、文档和代码已公开,研究者和开发者可以基于此进一步开发或定制医疗 AI 应用。
## 引言:本地优先的桌面助手新范式 尽管智能语音助手早已普及,但大多数桌面解决方案仍依赖云端管道,将原始音频发送到远程服务器,并仅提供固定的技能集。这种模式带来了隐私风险、延迟问题以及功能扩展的局限性。近日,一篇arXiv论文介绍了**AnovaX**——一个完全运行在用户本地计算机上的轻量级语音助手,将桌面本身作为其操作界面,通过多智能体架构和LLM规划实现了灵活、可恢复的自动化控制。 ## 核心架构:从语音到行动的完整链路 AnovaX的核心是一个**单进程Python系统**,它将多个组件无缝集成: - **唤醒词门控**:本地语音唤醒,无需持续联网。 - **语音流水线**:处理语音识别与合成。 - **LLM规划器(Gemini)**:接收用户指令后,生成一个结构化的**JSON工具调用计划**。 - **安全层**:基于白名单和黑名单过滤操作,确保安全性。 - **多智能体协调器**:将计划中的每个工具调用分配给专用的类型化子智能体,这些子智能体运行在**有界线程池**中,每个都有自己的超时、重试策略和共享资源锁。 - **自适应恢复循环**:当核心步骤失败时,接管控制并尝试修复。 ## 智能体类型与递归规划 AnovaX定义了**十种专用智能体类**,包括`AppAgent`(应用操作)、`TypingAgent`(模拟键盘输入)、`BrowserAgent`(浏览器控制)等。每个智能体都针对特定任务进行了优化。特别值得一提的是**递归MetaAgent**:它允许规划器将一个子目标委托回自身,最多支持**两层嵌套**,从而处理更复杂的任务分解。 恢复循环采用紧凑的**ReAct风格提示**,并在Gemini延迟期间通过**推测执行只读工具**来隐藏等待时间,提升用户体验。 ## 远程控制与实时反馈 AnovaX附带一个**Flask服务器**,通过本地WiFi暴露手机友好的远程接口。手机端可以实时镜像每个智能体的生命周期事件,并通过**MJPEG流**回传笔记本电脑屏幕画面,使用户能远程观察命令执行效果。这意味着用户可以从另一个房间完全通过手机驱动桌面操作。 ## 项目意义:轻量、可理解的本地自动化 论文作者指出,AnovaX的目标并非与Siri或Alexa竞争,而是展示一个**仅有几千行代码**的助手足以完成打开应用、输入文本、运行搜索、协调并发操作、从单步故障中恢复等任务,并且整个过程**LLM无需直接接触键盘**。这种本地优先、透明可控的设计,为桌面自动化提供了一种新的思路,尤其适合对隐私敏感或需要高度定制化的用户。 ## 小结 AnovaX通过巧妙的多智能体架构和LLM规划,实现了功能强大且完全本地的桌面语音控制。其类型化执行器、自适应恢复和远程控制能力,展示了在无需云服务的情况下,如何构建一个可靠、可扩展的自动化助手。对于AI行业而言,这代表了一种向**边缘智能**和**可解释系统**回归的趋势。
## 破解 ARC-AGI-3:编码智能体的核心能力归因研究 在人工智能领域,ARC-AGI(Abstraction and Reasoning Corpus)基准测试被视为迈向通用人工智能的重要关卡。此前,Sergey Rodionov 团队开发了一套集成**可执行世界模型、计划性简化与精确回放验证**的智能体,在 ARC-AGI-3 上取得了显著成绩。然而,这套系统究竟依赖哪项关键能力?最新预印本研究通过消融实验给出了答案。 ### 四层嵌套实验设计 研究团队构建了四个基于 Codex 的智能体变体,层层剥离核心组件: - **文本基线**:仅依赖纯文本推理,无任何世界模型或验证机制。 - **灵活接口可执行世界模型**:具备可执行世界模型,但移除回放验证。 - **含简化功能的可执行模型**:在上述基础上加入计划性简化能力。 - **固定接口验证变体**:保留简化与精确回放验证,要求完全复现记录观察。 所有变体在**gpt-5.4 和 gpt-5.5** 上以高(high)与极高(xhigh)两种推理强度进行测试,并在探索性实验中引入更强模型 **gpt-5.6-sol**。 ### 关键发现:组件效果因场景而异 最一致的结论是:**更强的模型与更高的推理强度总能带来性能提升**。但组件间的相对重要性出人意料: 1. **可执行世界模型并非万能**:在 gpt-5.5 设置下,纯文本变体反而优于带可执行世界模型的变体,表明强制要求持久化可执行产出可能带来开销。 2. **简化功能在多数场景有效**:在四种模型-强度组合中,简化功能提升了三种场景的性能,仅在最弱设置下无效。 3. **完整验证变体全面领先**:尽管消耗更多资源,验证变体在所有设置中均排名第一。 ### gpt-5.6-sol 下的饱和现象 在 gpt-5.6-sol 的探索实验中,验证变体在两种推理强度下**完全解决了所有公开游戏**,达到约 **99% 的 RHAE**,且总行动数仅为人类基线的**一半以下**。不过,由于该模型发布时间晚于这些游戏,且未见有隐藏集测试结果,这一表现应被视为**公开集饱和**,而非通用能力的证明。 ### 行业启示 该研究为构建通用推理智能体提供了重要参考: - **验证机制是关键杠杆**,尤其在高资源场景下价值显著。 - **简化与可执行模型**是辅助工具,但并非决定性因素。 - **模型能力与推理强度**仍是当前性能提升的最稳健路径。 随着 ARC-AGI 基准持续演进,如何在效率与泛化之间取得平衡,将是下一阶段的核心挑战。
## 当黑箱模型遇到医学:透明性为何如此重要? 人工智能在医疗领域的落地面临一个核心矛盾:**最先进的模型往往是“黑箱”**,其决策过程难以解释,医生和患者难以信任,且在不同数据集间难以复现。这种不透明性直接限制了AI在临床中的大规模应用。 ## 新框架:基于统计的阈值二值化 针对这一问题,一篇新论文提出了一种**基于统计的、完全可解释的分类框架**,核心思想是:**让模型简单到只需一张参考表和基础算术就能复现推理过程**。 该框架的核心组件是**伯努利朴素贝叶斯(BNB)模型**。为了让BNB能处理连续型医疗数据(如血糖、肿瘤尺寸),研究者引入了一种**监督式χ²引导的统计二值化方法**: - 对每个连续变量,自动寻找最佳切分阈值,使该变量与临床结局的关联性最大; - 将连续值转化为“高/低”或“阳性/阴性”等二元特征。 这样一来,BNB模型就能在保持其天然透明性的同时,有效处理连续数据,生成**可解释的“if-then”规则**,例如“如果血糖 > 126 mg/dL 且 年龄 > 50,则风险增加”。 ## 性能验证:不输复杂模型 研究者在三个经典医疗数据集上验证了该框架: - **Pima印第安人糖尿病数据集**:AUC = 0.800 - **威斯康星乳腺癌数据集**:AUC = 0.984 - **心力衰竭预测数据集**:AUC = 0.919 这些结果与随机森林、支持向量机等复杂模型相当,甚至更优。更重要的是,模型还通过了**泄漏安全的交叉验证校准分析**(包括Brier分数、校准截距/斜率、事后Beta校准),确保了概率输出的可靠性。 ## 透明性的极致:一张纸就能复现的推理 论文最引人注目的地方在于,作者给出了一个**完整的工作示例**:仅凭一张包含阈值和权重的参考表,加上四则运算,任何临床医生都可以手动复现模型对单个患者的预测结果——无需任何软件或专有工具。 这意味着: - **审计和验证**变得极其简单; - **监管审批**路径更清晰; - **临床采纳**的门槛大幅降低。 ## 意义与展望 这项工作的价值不仅在于提出了一个高性能的可解释模型,更在于它**重新定义了“可解释性”的实践标准**——不是提供特征重要性排名或局部解释,而是让整个决策过程完全透明、可手动复现。 对于医疗AI领域,这种“白箱”方法可能比追求更复杂的模型更有实际意义。未来,该框架有望扩展到更多临床场景,成为连接AI能力与临床信任的桥梁。
## 引言 在医学影像分析领域,紧凑型分类器往往需要在**效率**与**可解释性**之间做出权衡。传统方法通常将两者分开处理,导致模型要么轻量但缺乏透明度,要么可解释却计算开销大。近期,一篇发表于 arXiv 的论文提出了 **qZACH-ViT**,一种量化感知的视觉 Transformer 变体,旨在同时实现高效部署与内在可解释性。 ## 核心方法 qZACH-ViT 基于 **ZACH-ViT** 骨干网络进行扩展,摒弃了传统的 CLS token 和位置编码,转而通过递归方式生成**内在的块级类别证据**。其关键创新在于引入了 **递归归因稳定优化(RASO)**:该方法通过范数匹配分类梯度与归因梯度,并移除与分类目标冲突的归因分量,从而在训练过程中稳定归因图的质量。 此外,qZACH-ViT 支持**混合精度 INT8 量化**,可将模型转换为可执行的 ONNX 格式。论文在 **7 个 MedMNIST 数据集**上进行了严格评估,每个类别仅使用 50 张训练图像,通过 10 个固定随机种子完成 280 次实验,共生成 210 个检查点并全部转换为 INT8 图。 ## 实验结果 结果令人印象深刻: - **性能提升**:混合精度 INT8 的 qZACH-ViT(使用 Adam 优化器)在所有 7 个数据集上的平均主要指标比 FP32 的 ZACH-ViT 基线提高了 **0.0313**;若结合 RASO,平均增益进一步升至 **0.0368**。 - **量化保真度**:在 964,920 次源模型与 INT8 模型的对比中,预测一致率高达 **99.9751%**,主要指标的平均绝对变化仅为 **0.000133**,最大值也仅 0.004386。 - **归因稳定性**:在 3,600 组匹配的内在归因图中,平均余弦相似度为 **0.999955**,平均秩相关系数为 **0.9944**,平均 top-10% 重叠率达到 **0.9692**。 - **部署效率**:ONNX 工件比源检查点体积缩小 **70.0%**,在 CPU 上使用单线程和四线程时,端到端速度分别提升 **1.41 倍** 和 **2.39 倍**。 RASO 还显著降低了充分性误差,并提高了输入噪声稳定性,尽管并非在所有可解释 AI 指标上都占据绝对优势。 ## 结论与意义 qZACH-ViT 的成功表明,**量化感知训练与内在可解释性可以协同工作**,而无需牺牲模型性能或解释质量。该研究为在资源受限的医疗场景中部署可信赖的 AI 系统提供了实用路径——模型不仅更小更快,还能提供稳定、一致的块级证据,有助于临床决策的验证。 RASO 作为一种面向稳定性的优化方法,也为后续研究提供了新思路:通过显式约束归因梯度,可使解释更加鲁棒。未来,这一框架有望扩展到更复杂的医学影像任务,并推动边缘设备上的实时可解释诊断。
多模态大语言模型(MLLM)在自然图像和通用视觉问答上已取得显著进展,但面对工程领域的专业图纸时,其表现如何?近日,伊利诺伊大学厄巴纳-香槟分校等机构的研究人员推出了 **DrawingVQA**,这是首个专门用于评估 MLLM 在真实建筑施工图上进行多深度视觉-文本推理能力的基准。相关论文已被 **CVPR 2026 Findings** 接收。 ## 为何聚焦建筑施工图? 与自然图像或简单的楼层平面图不同,建筑施工图融合了抽象几何图形、符号标注、表格数据、注释以及领域特定文本,构成了一个高度复杂且专业的视觉-文本领域。它是建筑、土木等工程实践的核心媒介,但长期以来缺乏针对性的 AI 评估数据集。DrawingVQA 填补了这一空白。 ## 基准构成:33 张图纸与 92 个问答对 DrawingVQA 包含 **33 张“签发施工”图纸**(即实际施工使用的最终版本)和 **92 个由专家精心设计的问答对**。这些问题覆盖三个推理深度层级: - **感知理解**:识别图纸中的基本元素(如尺寸、符号); - **上下文解释**:理解元素之间的空间或逻辑关系; - **领域专家推理**:结合工程规范进行专业判断。 此外,研究团队还提出了一个**双分类框架**,从七个工程维度(如结构、机电、管道)和四个 MLLM 能力维度(如视觉定位、文本理解、多步推理)进行联合分析,首次将工程工作流映射到 AI 推理能力上。 ## 评估结果:MLLM 与专家差距明显 在对当前最先进 MLLM 的评估中,模型在感知层级表现尚可,但**在更高推理深度(上下文解释和专家推理)上,模型性能与人类专家之间存在显著差距**。这表明,尽管 MLLM 在通用场景中能力惊人,但在需要领域知识和多步推理的专业任务上,仍有很长的路要走。 ## 行业意义 DrawingVQA 的发布为 AI 在工程领域的落地提供了关键测试平台。它揭示了当前模型在处理专业图纸时的短板,也为未来开发**领域专用多模态推理系统**指明了方向。随着建筑信息模型(BIM)和智能建造的推进,让 AI 真正理解施工图纸,将能大幅提升自动化审查、施工进度监测和安全检查的效率。 不过,论文也提醒,当前基准规模有限(92 个问答对),未来需要扩展更多图纸类型和问题数量,并引入更多工程学科。 ## 小结 DrawingVQA 是一个务实且专业的基准,它让 MLLM 的“考试”从自然场景延伸到了真实的工程场景。对于关注 AI 落地和行业智能化的读者来说,这项研究提供了一个清晰的信号:**通用模型在专业领域仍需“补课”,而领域知识与多模态推理的深度融合,将是下一阶段的关键突破点。**
英伟达CEO黄仁勋刚刚结束为期两天的东京之行,此行成果覆盖日本整个科技生态:从国家级AI工厂到机器人联盟,再到芯片材料供应商的深度绑定。黄仁勋传递的讯号十分明确:AI的下一个篇章属于工厂车间、机器人和物理世界,而日本正在成为这一愿景的关键拼图。 ## 三大核心项目浮出水面 ### Noetra:日本的“主权AI”雄心 日本政府联合软银、索尼、NEC、本田等约44家本土企业,成立了Noetra联盟,目标是为机器人、汽车和工厂打造自主AI系统。东京方面承诺五年内投入最高**1万亿日元(约62亿美元)**,构建完全自主的物理AI基础模型。日本希望掌握“软件大脑”,但硬件基础设施仍依赖英伟达——后者将为其建设一座名为“**Vera Rubin AI工厂**”的超大规模数据中心,计划2028年启用,搭载13750颗Vera CPU和27500颗Rubin GPU,总功率140兆瓦。 Noetra的路线图分三个阶段:2026财年推出侧重日语能力的推理模型;2028年实现支持文本、图像、视频和音频的全模态版本;2030年发布可驱动机器人的“真实世界原生AI”,并分阶段向外部开发者开放。 ### 机器人联盟:日本工业巨头齐聚Cosmos 英伟达瞄准日本工厂车间,获得了大批顶级机器人及制造企业的支持。发那科、安川电机、川崎重工、富士通、日立、NEC、索尼、软银、久保田以及机器人组织AIRoA均已宣布,计划基于英伟达的**Cosmos模型**进行开发。Cosmos是英伟达今年5月启动的开源模型项目,旨在为机器人提供通用物理世界理解能力。 ### 芯片材料供应链深度绑定 黄仁勋还与日本多家芯片材料供应商达成协议,这些企业为英伟达下一代AI芯片提供关键材料。日本在半导体材料领域拥有深厚积累,此次合作将进一步巩固英伟达的供应链韧性。 ## 历史轮回:从Sega到“物理AI” 三十年前,世嘉(Sega)一笔500万美元的投资帮助濒临破产的英伟达渡过难关。如今,英伟达与日本工业巨头再次相互需要——这次是共同构建“物理AI时代”。黄仁勋的东京之行不仅签下订单,更在重塑日本AI产业格局:日本不愿让工厂和机器人运行在美国或中国的AI之上,而英伟达则希望日本成为其物理AI战略的全球制造基地。
苹果最近对OpenAI提起商业秘密诉讼,指控其系统性挖角苹果员工并窃取机密信息。这起诉讼恰逢OpenAI酝酿推出硬件产品(传闻中的移动智能音箱)并筹备IPO的关键时刻。在最新一期TechCrunch的Equity播客中,三位编辑就此展开辩论:诉讼是否会给OpenAI的蓝图蒙上阴影? ## 诉讼背景 苹果指控OpenAI存在“不当行为模式”,通过雇佣前苹果员工获取商业机密。OpenAI回应称“未发现任何证据表明该投诉有依据”。值得注意的是,OpenAI此前刚在与Elon Musk的诉讼中获胜,这或许会影响其应对策略。 ## 硬件计划面临不确定性 据传OpenAI正与Jony Ive合作开发硬件产品,首个设备可能是一款移动智能音箱。Sean O’Kane认为,即使法院不颁布禁令,诉讼本身也会导致项目延期——“这很可能正是苹果的目的之一。” ## 隐私与社会规范 智能音箱的“始终聆听”特性引发隐私担忧。Kirsten Korosec指出,这类设备不仅监听用户,还会影响周围人群,需要重新协商社会规范。 ## 和解还是硬扛? 面对诉讼,OpenAI可能选择快速和解以扫清障碍,但鉴于此前对Musk诉讼的胜利,它也可能选择坚持到底。Kirsten预测后者可能性更大。 诉讼走向将直接影响OpenAI的硬件发布和IPO时间表,值得持续关注。
作为 AI 音乐一贯的怀疑论者,我早已习惯对 Suno 之类的生成式 AI 作品嗤之以鼻。那些千篇一律的旋律、毫无灵魂的编曲,往往只让我感到乏味。直到我听到 1010Benja 的《Semiramis' Dream》,才不得不承认:AI 在正确的人手里,确实能产出真正动听的音乐。 ## 一首让人“破防”的 AI 歌曲 《Semiramis' Dream》以丛林打击乐开场,节奏强劲,人声穿透力十足。Benja 的嗓音明显是真实的、有血有肉的,几乎让人忘记这背后有 AI 的参与。整首歌最“AI”的部分——背景合唱——也被巧妙地隐藏在高速剪辑的 hyperpop 音效中。在现代流行音乐里,经过重度处理的人声本就常见,Benja 正是利用这种“非自然感”让 AI 的痕迹变得合理。 ## 不是“一键生成”,而是人机协作 Benja 在采访中透露了他的创作流程: * 朋友 Patrick Holder 制作了节拍 * 他本人录制了人声 * 将素材输入 Suno,生成初始版本 * 导出到 Ableton 进行编辑 * 再回输给 Suno 迭代 最终成品在 Deezer 上被标记为“AI 生成”,但 Benja 毫不掩饰:“我们不觉得羞耻。” 这种“人主导、AI 辅助”的模式,与常见的“输入提示词一键出歌”有天壤之别。Benja 写了歌词、唱了人声、与真人乐手合作,AI 只是编曲和音色设计的协作者。 ## AI 音乐的正确用法 《Semiramis' Dream》之所以成功,关键在于它没有试图用 AI 替代人类,而是让 AI 成为创意工具箱中的一件乐器。Benja 没有隐藏 AI 的存在,反而利用它的“怪异感”来增强作品风格。这提醒我们: * **AI 不是捷径**,而是需要精心调校的工具 * **人类的创意和审美**依然是核心,AI 擅长提供素材和变体 * **拥抱而非逃避 AI 的痕迹**,可以创造出独一无二的声音美学 当然,并非所有 AI 音乐都能达到这个水准。Benja 的 EP 中其他三首歌曲就明显逊色。但《Semiramis' Dream》至少证明了一件事:当 AI 被用来扩展人类的创造力,而非取代它时,结果可以令人惊喜。 ## 小结 如果你对 AI 音乐还停留在“电子垃圾”的印象,不妨听听 1010Benja 的《Semiramis' Dream》。它不会让你从此爱上所有 AI 音乐,但会让你看到可能性。正如 Benja 所说:“我们不隐藏,也不感到羞耻。”也许,这才是 AI 与艺术共存的正确态度。
奥斯卡获奖导演克里斯托弗·诺兰(Christopher Nolan)近日在宣传其新片《奥德赛》时,对人工智能发表了一番引人深思的评论。他将 AI 比作“特洛伊木马”,但强调这只木马是“透明的”,人人都知道里面藏着什么。诺兰认为,当前公众——尤其是年轻人——对 AI 的普遍怀疑态度是“非常健康的”,这有助于推动技术向更好的方向发展。 ## AI:一只透明的木马 在 YouTube 博主 HugoDécrypte 的采访中,诺兰被问及 AI 是否像特洛伊木马一样,表面是礼物,实则暗藏危险。诺兰笑着回应:“我认为 AI 是一只特洛伊木马,而且人人都知道里面藏着希腊人。”他进一步形容 AI 为“一只透明的木马,由玻璃制成”。 诺兰指出,他从未见过一项技术发展如此迅速,同时又如此被公众“彻底拒绝”。“每个人对它的怀疑都如此极端,尤其是年轻人。他们在网上看到 AI 视频时,会立刻称之为‘AI slop’(AI 垃圾),并给它贴上标签。” ## 技术怀疑主义:健康的态度 诺兰强调,这种怀疑主义是“非常健康的”,因为技术虽然能带来巨大礼物,但必须带着批判的眼光看待。“给予我们技术的人的动机也必须被审视。只有这样,我们才能从新技术中获得最好的东西,而不是盲目相信一切都会很美好。” 作为导演工会(DGA)主席,诺兰对 AI 在好莱坞的影响有着切身感受。2023 年的编剧和演员罢工中,AI 保护条款成为核心议题,而 DGA 也在最新合同中争取到了生成式 AI 的相关保护。 ## 诺兰的技术观:从“勒德分子”到“技术怀疑论者” 诺兰一直以对技术的审慎态度闻名,他曾拒绝使用智能手机,并坚持使用胶片拍摄。他的新片《奥德赛》成为首部完全使用 IMAX 胶片和摄像机拍摄的故事片。当被《纽约时报》问及是否认为自己是“技术恐惧者”时,诺兰回答:“我认为自己是技术怀疑论者。”他表示,他对胶片的热爱源于它“在呈现世界本质方面更优秀”。 ## 行业背景:AI 争议持续升温 诺兰的评论正值 AI 在影视行业引发激烈争议之际。一方面,生成式 AI 技术(如视频生成模型)正在改变内容创作方式;另一方面,创作者对版权、就业和伦理问题的担忧日益加剧。特斯拉 CEO 埃隆·马斯克(Elon Musk)近期也因《奥德赛》的非白人及跨性别演员阵容而发表激烈言论,折射出科技与娱乐领域的复杂交织。 诺兰的观点为这场讨论提供了一个独特的视角:与其恐惧 AI 本身,不如警惕那些推动技术的人及其动机。在技术快速迭代的时代,保持清醒的怀疑或许是最理性的选择。
一家名为 **Current AI** 的非营利组织正在构建开放、公共的 AI 基础设施,目标是让 AI 惠及每一种文化和语言,就像万维网一样免费向所有人开放。该组织由 Martin Tisne 于 2025 年 2 月创立,CEO Ayah Bdeir 此前曾领导 Mozilla 的 AI 战略,并创办了教育科技公司 littleBits。 ### 从印度乡村的离线设备到开源聊天机器人 在 2 月的印度 AI 峰会上,Current AI 与印度政府 AI 语言部门 Bhashini 合作,推出了 **Suno Sutra**(印地语意为“聆听编年史”)。这是一款口袋大小的离线设备,无需互联网即可运行 22 种印度语言的 AI 模型。印度有数百种语言和方言,而当前的 AI 系统并未充分代表它们。Bdeir 表示,该设备已开源,开发者社区可以在此基础上进行二次开发。 上个月,该组织向四个项目拨款 **320 万美元**;上周,它在日内瓦的“AI 造福人类”峰会上发布了一款开源 AI 聊天机器人。 ### 资金与使命:公共替代方案 Current AI 采用公私合作模式,汇集政府、企业和慈善机构的资金。法国政府率先投入 **1 亿美元**,福特基金会、麦克阿瑟基金会、DeepMind 和 Salesforce 等机构加入,总承诺资金已达 **4 亿美元**。Bdeir 强调:“他们不是投资者,而是资助者。” 该组织的核心目标直指当前 AI 格局的痛点:从 OpenAI 到 Google 再到 Anthropic,每一个主流 AI 系统都属于私营公司。Bdeir 认为,如果 AI 是真正的变革性技术,它将改变每个人生活的方方面面,那么必须有一个公共替代方案——就像万维网一样,任何人都可以免费使用。 ### 语言与文化:AI 不能只属于英语 全球有一半的口头语言面临灭绝风险。而英语驱动着最大的语言模型和 AI 系统,这意味着大量语言、文化及社区被抛在后面。当被问及科技巨头的多语言布局时,Bdeir 指出:大型科技公司构建多语言模型是为了扩大市场,往往不顾及社区的同意或背景。例如,对于土著语言,传教士的圣经翻译常常成为训练数据,这带来了文化挪用和语境错位的问题。 ### 行动与展望 Current AI 的进展速度令人瞩目:从成立到推出硬件和软件产品仅用了短短几个月。其开源策略和公共资助模式为 AI 的民主化提供了一条不同于商业巨头的路径。未来,该组织计划继续拓展语言支持范围,并推动更多政府和企业加入其公共 AI 生态系统。Bdeir 总结道:“我们正在建设 AI 的公共广场——一个不属于任何单一公司,而是属于全人类的数字基础设施。”
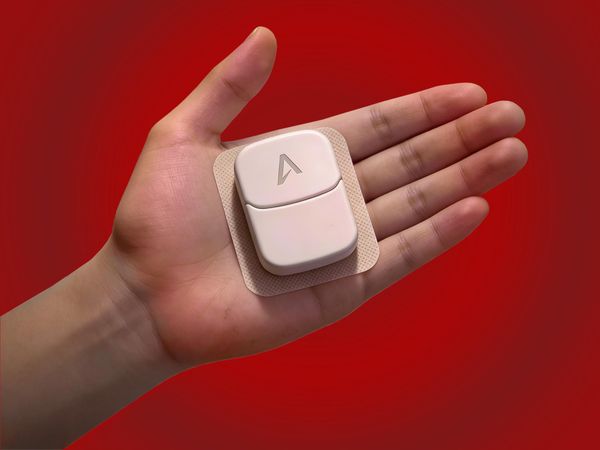
可穿戴设备的下一个前沿,可能是实时监测压力激素皮质醇。一款基于DNA传感器的贴片原型,由生物技术公司Adaptyx Biosciences开发,能够每分钟读取一次皮质醇水平,为压力管理、心理健康和疾病诊断带来全新可能。 ## 从汗水到激素:可穿戴的新维度 当前主流可穿戴设备主要追踪心率、步数、睡眠等基础生理指标,但激素层面的实时监测一直是个空白。皮质醇作为人体主要的压力激素,其昼夜节律波动与焦虑、抑郁、代谢疾病乃至免疫功能密切相关。传统皮质醇检测需通过血液、唾液或尿液样本,在实验室完成,无法实现连续动态监测。 Adaptyx的最新原型贴片,采用DNA传感器技术,通过分析汗液中的皮质醇分子,实现**分钟级别的连续读数**。传感器利用特定DNA序列与皮质醇结合时产生的构象变化,转化为电信号,从而实时输出浓度数据。这种设计不仅灵敏度高,还具备良好的生物相容性,适合长时间佩戴。 ## 技术突破与行业意义 将激素检测微型化、可穿戴化,是生物传感领域长期追求的目标。与葡萄糖监测(CGM)类似,皮质醇贴片有望打开一个巨大的健康管理市场——从职场压力预警到运动员恢复状态评估,从精神科用药调整到内分泌疾病早期筛查。 Adaptyx的DNA传感器路径具有一定优势:DNA分子可针对不同目标分子进行编程,理论上可扩展至其他激素(如雌激素、睾酮)甚至细胞因子。这意味着一个贴片未来可能实现**多激素同时监测**,提供更全面的内分泌画像。 ## 挑战与展望 不过,从原型到消费级产品仍有距离。首要挑战是**校准与稳定性**:汗液成分复杂,pH值、离子浓度变化可能干扰传感器读数;长期佩戴下传感器表面污染也会影响精度。此外,如何将数据转化为用户可理解的行动建议——比如“当前皮质醇过高,建议深呼吸5分钟”——需要算法与临床研究的深度结合。 目前该技术尚处于早期验证阶段,Adaptyx未公布具体上市时间。但可以预见,一旦突破,可穿戴设备将从“运动手环”进化为“健康管家”,而皮质醇监测正是这一进化中的关键一环。
你可能认为基本的局域网(LAN)设置已经足够安全,但网络中可能潜藏着需要设备隔离才能解决的安全隐患。本文将深入探讨虚拟局域网(VLAN)如何通过逻辑分割网络来提升安全性,并提供最佳实践指南。 ## 为什么需要VLAN? 在传统家庭网络中,所有设备(电脑、手机、智能家居摄像头、IoT设备等)通常处于同一个广播域。这意味着一旦某个设备被入侵,攻击者可以轻松横向移动,威胁其他设备。例如,一个存在漏洞的智能灯泡可能成为黑客进入你家庭网络的跳板。VLAN通过将网络划分为多个逻辑子网,实现设备隔离,从而限制攻击范围。 ## VLAN如何工作? VLAN(虚拟局域网)允许你在同一物理网络基础设施上创建多个独立的广播域。每个VLAN就像一个独立的网络,设备只能与同一VLAN内的设备通信。跨VLAN通信需要路由器或三层交换机的支持,并可通过访问控制列表(ACL)进一步精细控制。 ## 家庭网络中的典型VLAN划分 - **主设备VLAN**:用于个人电脑、手机、平板等受信任设备。 - **IoT设备VLAN**:用于智能家居设备(如摄像头、智能音箱、灯泡),这些设备通常安全性较低。 - **访客VLAN**:为访客提供网络访问,但隔离内部资源。 - **管理VLAN**:用于网络设备(如路由器、交换机)的管理接口,避免暴露在普通网络中。 ## 最佳入门方案 对于家庭用户,最实用的入门方式是使用支持VLAN的**路由器/交换机**(如Ubiquiti UniFi、TP-Link Omada系列或消费级产品如华硕Merlin固件路由器)。以下是基本步骤: 1. **确定需求**:列出需要隔离的设备类型。 2. **配置VLAN**:在路由器管理界面创建VLAN ID(如VLAN 10、20、30),并分配子网。 3. **设置SSID映射**:对于无线网络,可为每个VLAN创建独立的Wi-Fi SSID(例如“Home-IoT”、“Home-Guest”)。 4. **配置防火墙规则**:设置ACL,允许必要通信(如从主设备VLAN访问IoT设备,但反之禁止)。 5. **测试与调整**:验证设备是否能按预期通信,并逐步完善规则。 ## 注意事项 - **兼容性**:并非所有消费级设备都支持VLAN,购买前需确认。 - **性能影响**:VLAN转发依赖硬件,一般不影响性能,但大量跨VLAN路由可能增加CPU负载。 - **维护成本**:VLAN配置较复杂,初学者可能需要学习网络基础知识。 ## 小结 VLAN是提升家庭网络安全性的有效手段,尤其适合拥有大量IoT设备的用户。通过合理的网络分割,你可以显著降低攻击面,保护敏感数据。虽然初始设置有一定学习曲线,但长期来看,它带来的安全收益远超投入。对于追求更高安全性的用户,VLAN是值得投资的技术。
据 Hacker News 用户反馈,OpenAI 近期悄然调整了其 Codex 模型的上下文窗口大小,从原先的 **372k tokens** 缩减至 **272k tokens**,降幅约 **27%**。这一变化在开发者社区引发广泛讨论,目前已有 **150 分** 热度与 **67 条评论**。 ### 变化细节与影响 上下文窗口决定了模型在一次推理中可处理的文本长度,直接影响代码补全、多文件分析等能力。此前 Codex 以 372k 的容量支持大型代码库理解,而新版 272k 虽仍属行业较高水平,但对依赖长上下文的开发者而言,意味着需要更频繁地截断代码或调整工作流。 ### 背后可能的原因 目前 OpenAI 尚未发布官方说明,但社区推测原因包括: - **成本优化**:更小的上下文可减少计算资源消耗,降低运营成本 - **性能平衡**:过长上下文可能导致注意力分散,缩短后或提升响应质量 - **产品策略**:区分 Codex 与其他模型(如 GPT-4 Turbo 的 128k)的定位 ### 开发者反应 部分用户表示担忧,尤其是从事大型项目重构或代码审查的开发者,认为这会影响工具实用性。但也有观点认为,272k 仍能满足多数场景,且模型对关键信息的提取能力可能因聚焦而增强。 ### 行业背景 上下文大小一直是 AI 模型竞争的关键指标。2023 年以来,Claude 2 推出 100k,GPT-4 Turbo 支持 128k,而 Codex 曾以 372k 领先。此次缩减或反映 OpenAI 在实用性与成本之间重新权衡,也可能为后续模型迭代腾出空间。 ### 小结 Codex 上下文缩减虽未引发大规模负面反响,但提醒开发者关注模型更新对工作流的潜在影响。建议用户检查自身使用场景,必要时调整代码处理策略。OpenAI 若未进一步解释,社区可能需要通过实际测试评估新限制的具体影响。
在搜索引擎优化(SEO)领域,Ahrefs 和 SEMrush 等工具凭借强大的数据洞察能力占据主导地位,但其高昂的订阅费用让许多个人站长和中小企业望而却步。如今,一款名为 **OpenSEO** 的开源工具正试图打破这一局面——它被社区称为“开源版 Ahrefs”,旨在提供核心 SEO 分析功能,且完全免费。 ## 核心功能一览 OpenSEO 并非单纯复制 Ahrefs 的界面,而是聚焦于 SEO 工作流中最关键的几个模块: - **关键词研究**:支持批量关键词查询,展示搜索量、竞争度及趋势数据。 - **反向链接分析**:抓取并分析目标域名的外链质量,包括锚文本分布与来源域名权重。 - **页面审计**:检测页面技术 SEO 问题,如元标签缺失、加载速度、移动端适配等。 - **排名追踪**:监控目标关键词在搜索引擎结果页(SERP)中的位置变化。 所有数据均通过公开 API 或自建爬虫获取,用户可自行部署到本地服务器,确保数据隐私与定制灵活性。 ## 开源的价值与挑战 OpenSEO 的出现契合了 SEO 社区对“工具民主化”的长期呼声。传统商业工具的高价格(Ahrefs 最便宜套餐月费 99 美元)使得小团队难以获得高质量的数据支持,而 OpenSEO 通过开源许可(通常为 AGPL 或 MIT)允许用户自由使用、修改甚至商用。 但挑战同样明显:商业工具的壁垒在于数据积累与算法精度。Ahrefs 拥有庞大的历史数据库和实时爬虫网络,这是个人或小团队难以复制的。OpenSEO 目前依赖第三方免费 API 或小型爬虫集群,数据覆盖率和更新频率可能无法与商业工具匹敌。此外,用户体验和售后支持也是开源项目常见短板。 ## 适用场景与建议 对于预算有限的初创公司、自由职业者或学习 SEO 的学生群体,OpenSEO 是一个绝佳的入门选择。它可以帮助用户理解 SEO 的核心概念,完成基础分析工作。而对于追求极致数据准确性和大规模并发查询的企业,商业工具仍是更稳妥的方案。 值得注意的是,OpenSEO 的社区正在快速增长,GitHub 上已有多位贡献者提交代码改进爬虫效率与数据可视化。若项目能在数据源稳定性上取得突破(例如集成 Common Crawl 或自有爬虫网络),其完全有可能成为 SEO 工具生态中的一匹黑马。 ## 小结 OpenSEO 以开源精神向垄断的 SEO 工具市场发起了一次有力冲击。它或许无法在短期内取代 Ahrefs,但至少为中小从业者提供了一个“够用且可定制”的替代方案。对于关注数据主权与成本控制的用户,不妨将其纳入工具链——毕竟,免费的强大工具,谁不爱呢?
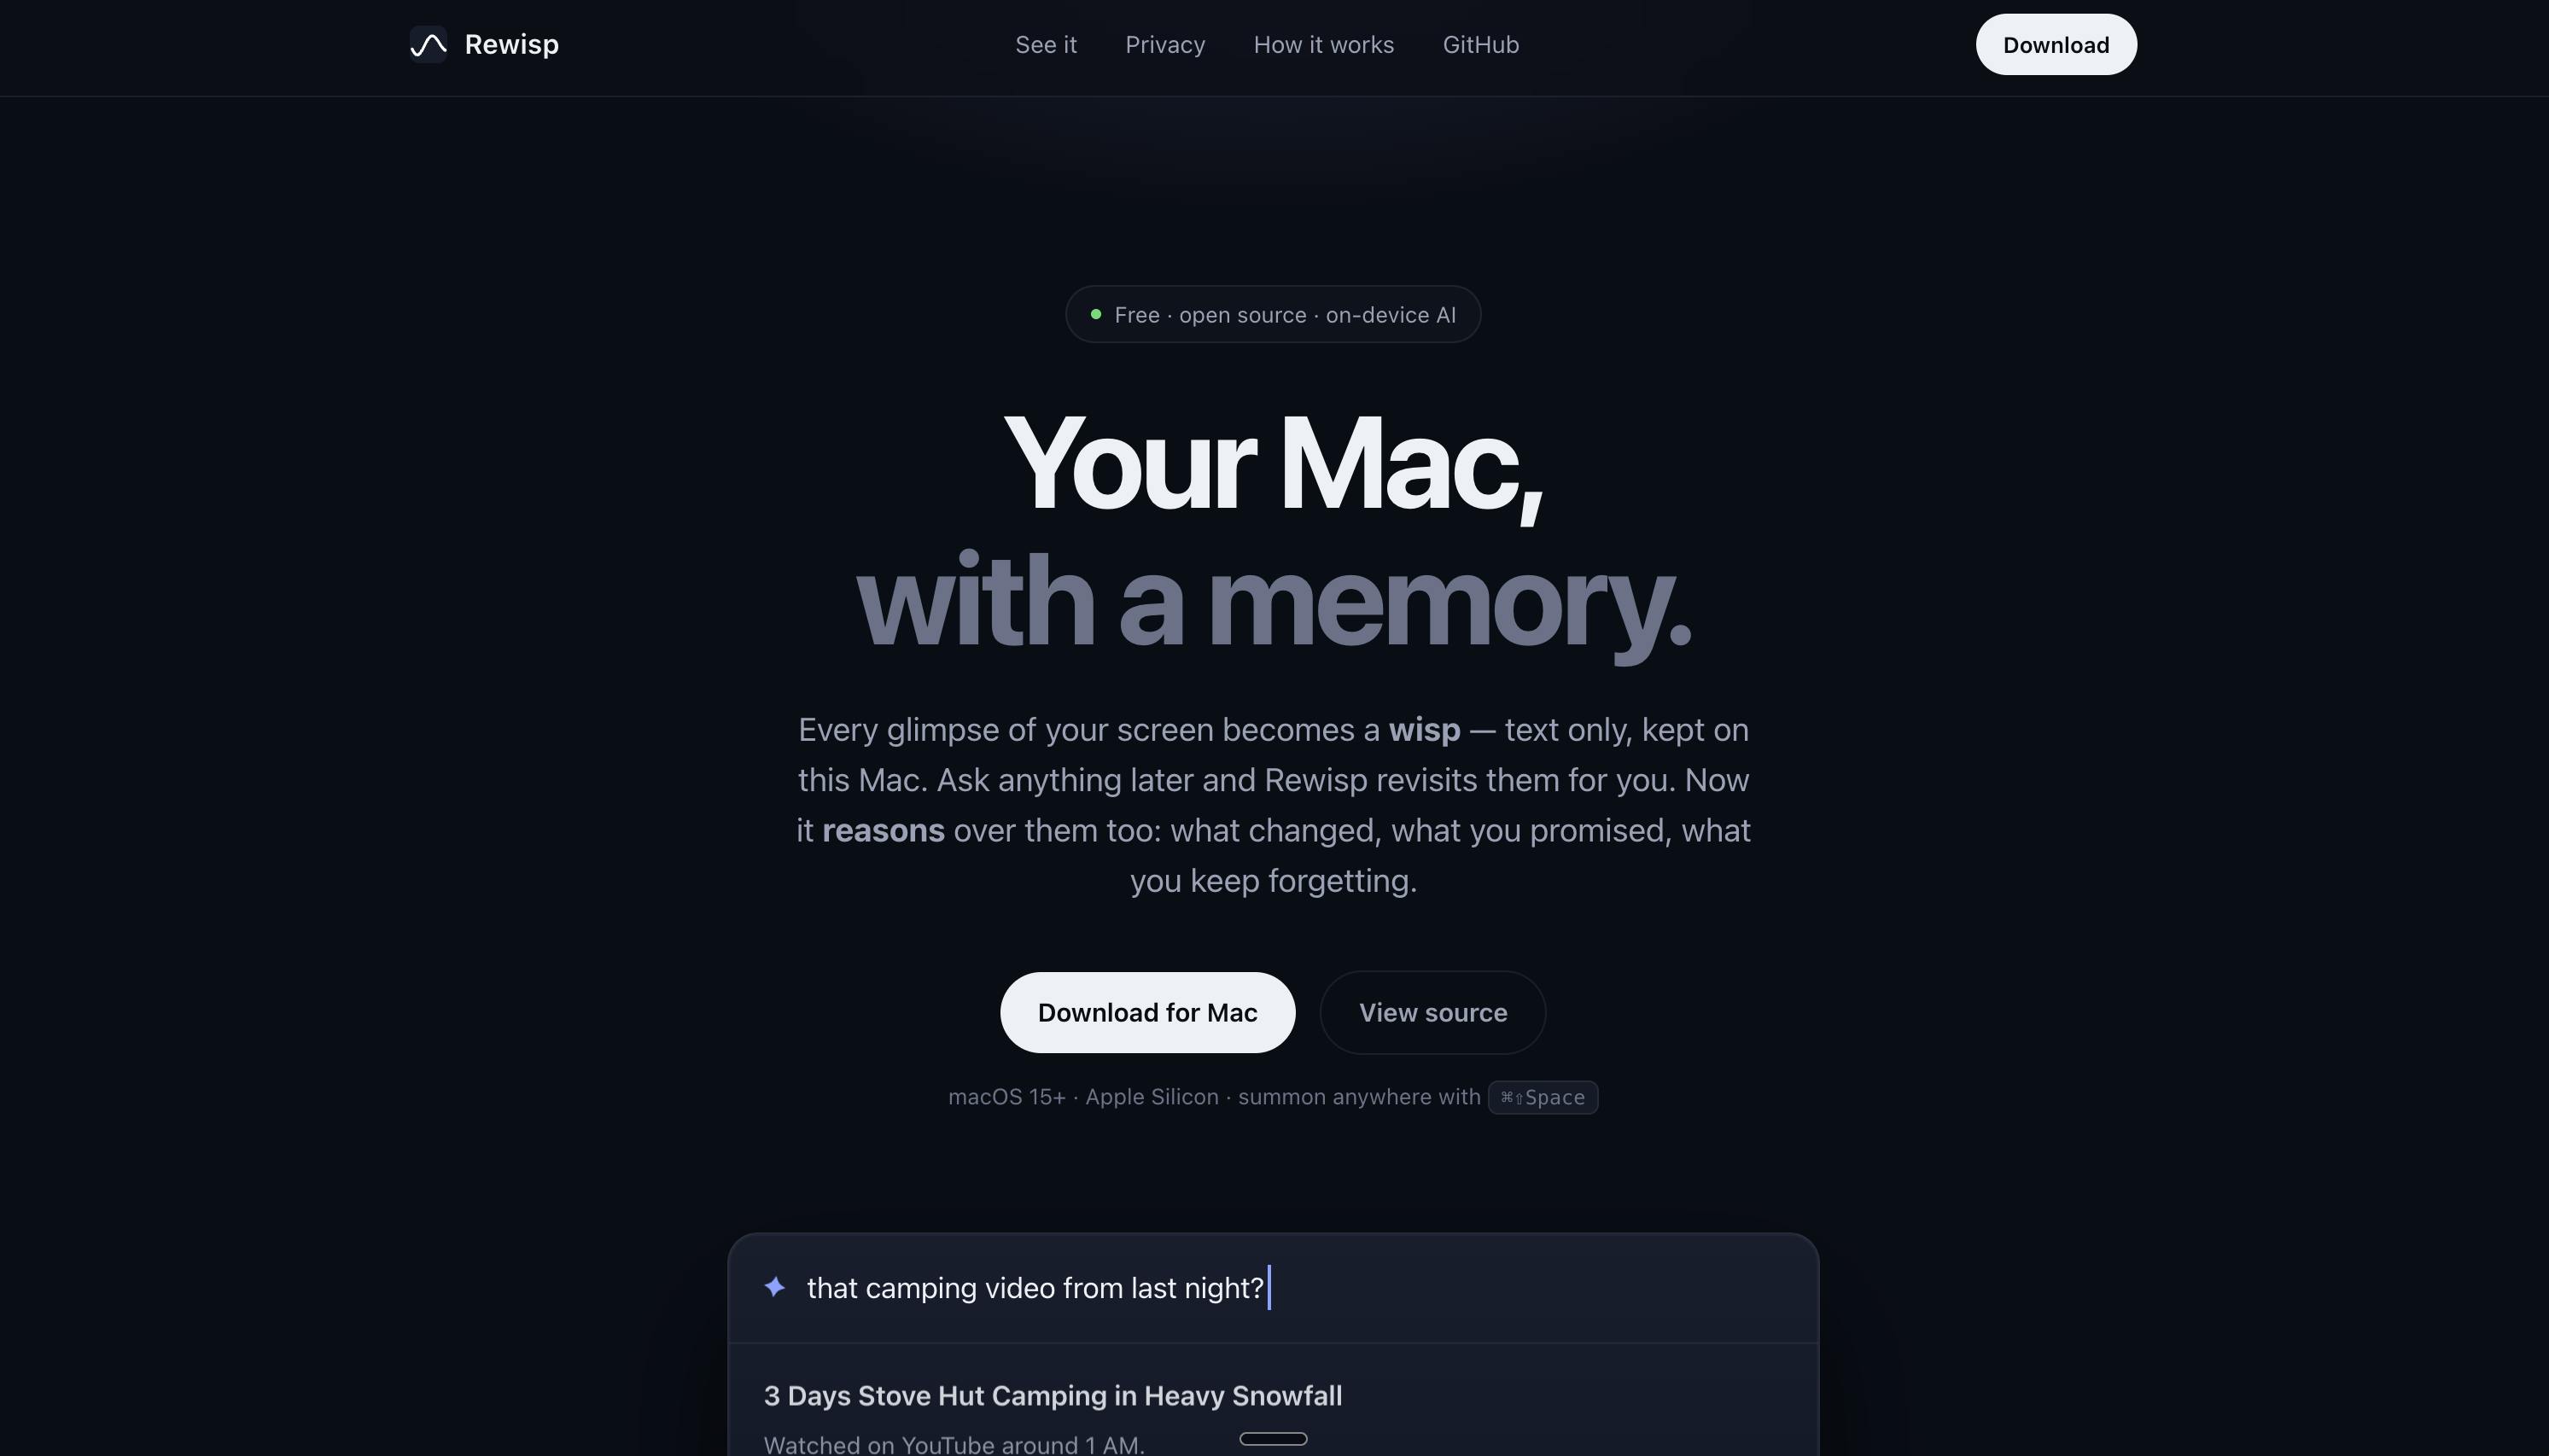
Rewisp 是一款专为 Mac 设计的“环境记忆”工具,旨在帮助用户轻松记录和回顾屏幕上出现过的任何信息。其核心理念是“看过一次,随时可问”——无需手动保存或截图,Rewisp 会在后台默默记录你浏览过的内容,并通过智能搜索让你随时调取。 ### 如何工作? Rewisp 运行在菜单栏中,持续捕捉屏幕上的文本和图像信息(如网页、文档、聊天记录等),并建立本地索引。当你需要回忆某条信息时,只需通过快捷键或菜单栏搜索框输入关键词,Rewisp 就会快速呈现相关结果。所有数据都存储在本地,保障隐私安全。 ### 适用场景 - **临时信息**:比如网页上的验证码、临时地址、会议链接等,无需手动记录。 - **深度研究**:浏览多篇文章后,快速定位某个观点或数据。 - **工作流整合**:与截图工具、笔记应用配合,形成“捕捉-索引-检索”闭环。 ### 与同类工具的差异 相比传统的笔记应用(如 Notion、Obsidian),Rewisp 更强调“无感记录”——用户无需主动整理,工具自动完成记忆。而相较于 macOS 自带的 Spotlight,Rewisp 能覆盖更广泛的内容类型(包括图像中的文字),且检索更智能。 ### 隐私与性能 Rewisp 采用本地处理,所有数据不上传云端。在性能方面,它优化了资源占用,不会明显拖慢系统。支持 macOS 12 及以上系统。 ### 总结 Rewisp 定位精准,适合那些经常在屏幕前处理大量信息、又不想花时间整理的用户。它填补了“临时记忆”与“永久笔记”之间的空白,让信息管理更自然。