
## 让黑箱偏好模型“开口说话”:语言驱动的偏好解释与编辑 随着机器学习在人类偏好建模中的广泛应用,一个根本性挑战日益凸显:当选择项在多个维度上存在差异时,究竟哪些因素驱动了决策?传统方法往往给出一个“黑箱”评分,用户无法检查、质疑或纠正模型。对此,麻省理工学院等机构的研究者提出了一种名为 **“weights to words”(权重到文字)** 的新方法,旨在将模型内部的数值推理转化为可读、可编辑的自然语言描述。 ### 核心思路:自动发现偏好维度 该方法的核心是:给定一组选择数据(例如用户对道德困境、电影或红酒的偏好),算法自动发现一组与领域相关的**偏好维度**,每个维度都用自然语言标签(如“道德重要性”“电影剧情深度”)表示,并对应模型表征空间中的一个向量。这些维度不仅解决了**欠确定性**(将归因集中在少数有意义因素上),还通过**外化**模型推理,让用户能够实时检查和编辑。 ### 实验验证:提升预测准确性与用户满意度 研究者在四个领域进行了定性展示:道德困境、电影、红酒和自由形式的大语言模型(LLM)响应。随后,他们开展了两个预注册的受试者实验: - **道德困境实验(N=450)**:参与者面对一系列道德两难选择。使用“权重到文字”方法提取的偏好维度(如“伤害避免”“公平性”),将模型向该基正则化后,在留出数据上的预测准确率**显著提升**。进一步,允许参与者编辑这些维度(例如调整“公平性”的权重),准确率再次提高。 - **电影选择实验(N=449)**:类似流程,参与者偏好电影类型、演员等维度。与基线模型相比,参与者更偏好该方法生成的偏好画像,并认为其预测更准确。 ### 意义与展望 这项工作的价值在于**将偏好建模从纯粹统计推断扩展为可交互的认知工具**。它使非专家用户能够理解模型为何推荐某个选项,并在发现错误时进行修正——例如,当模型错误地将“动作场面”归因于用户偏好时,用户可以直接降低该维度的权重。这种可解释性对于高风险领域(如医疗、法律、推荐系统)尤为重要。未来,该方法有望与LLM结合,实现更动态的偏好学习。 论文发表于arXiv(arXiv:2607.16232),并提供了42页的完整附录,包括22张图和14张表。
最新研究揭示,大语言模型(LLM)在面对不确定性时,会表现出系统性的、一致的风险态度——就像人类一样,有的模型天生“激进”,有的则偏向“保守”。 来自佛罗里达大学等机构的研究团队在预印本平台 arXiv 上发布了一篇论文,首次系统地检验了 LLM 在不确定性下的风险行为。他们设计了一个跨领域框架,将“上下文风险信念”与“分类决策”解耦,并测试了六款代表性 LLM(如 GPT-4、Claude 等)以及 100 名人类参与者在**空间导航、临床分诊和金融分配**三类任务中的表现。 ## 关键发现:风险态度是 LLM 的稳定特质 通过回归模型提取每个智能体的“信念-决策映射”,研究量化了风险敏感度和风险态度偏差。核心结论有三: 1. **任务内一致性**:在同一个任务领域内,LLM 从上下文信念到风险决策的映射关系非常稳定,不会因提示措辞的细微变化而摇摆。 2. **跨领域排序稳定性**:如果一个模型在金融任务中偏向激进,它在空间导航和临床分诊任务中也会表现出相对激进的风险偏好——风险态度的“排序”在不同领域间保持一致。 3. **向狭窄风险态度分布收敛**:与人类参与者相比,LLM 的风险态度分布范围更窄。换句话说,AI 的风险偏好更“保守”或更“集中”,不像人类那样极端多样。 ## 为什么这很重要? 长期以来,AI 对齐研究主要关注模型的能力(如推理、知识)和安全性(如避免有害输出),但**风险态度**这一维度一直被忽视。这项研究首次将风险态度确立为 LLM 行为的一个稳定、可测量的特质,为评估和校准 AI 在开放式决策中的表现奠定了基础。 ## 潜在影响:从自动驾驶到医疗决策 想象一下,如果自动驾驶 AI 在面临“急转弯避让”时过于激进,或者医疗 AI 在分诊时过度保守,后果可能截然不同。理解并控制模型的风险态度,对于部署在**金融交易、医疗诊断、军事指挥**等高赌注场景中的 AI 系统至关重要。 ## 未来方向 论文指出,仍需进一步探索这些内在行为倾向的起源——是来自训练数据中的风险偏好模式,还是模型架构本身导致的?此外,如何通过微调或提示工程来调整模型的风险态度,也是一个开放问题。 总之,这项研究提醒我们:AI 不仅会“思考”,还会“感受”风险。对齐工作的下一个前沿,或许就是校准它们的“性格”。
大型语言模型(LLM)正被广泛应用于医疗、金融、教育等安全关键系统,但其“无法遗忘”的特性带来了严重的网络安全、隐私与合规风险。近期一份由多所高校研究者联合发表的综述(arXiv:2607.16227)系统梳理了LLM遗忘技术(LLM Unlearning)在网络安全防御中的现状、挑战与新兴威胁,指出当前方法可能只是“抑制表达”而非“真正删除知识”。 ## 核心痛点:模型为何需要“遗忘”? LLM在训练过程中会记忆大量敏感信息——个人隐私数据、受版权保护的文本、危险领域知识等。这些信息在模型部署后仍编码在数十亿参数中,极易被提取攻击(Extraction Attacks)、越狱提示(Jailbreak)或成员推断(Membership Inference)所利用。实际案例已屡见不鲜:聊天机器人意外泄露用户隐私,或模型生成虚假法律引用导致真实财务损失。 传统解决方案如重新训练模型需要消耗巨大算力,且知识在参数中高度纠缠,无法精准定位。因此,**LLM遗忘技术**应运而生,旨在不重新训练的前提下,移除或抑制模型中特定知识,同时保持其余能力的完整性。 ## 方法之争:梯度方法主导,但有效性存疑 综述聚焦于**基于梯度的方法(Gradient-based Methods)**,这类方法因与现有训练管线兼容、可扩展至千亿参数模型而成为主流。其核心思路是通过反向传播调整参数,使模型在特定输入上“忘记”目标知识。 然而,研究提出了一个关键问题:**当前方法真的实现了“遗忘”,还是仅仅让模型在常规提示下不再输出那些信息?** 如果攻击者采用对抗性提示或模型逆向技术,被“遗忘”的知识可能再次浮现。这种“表面遗忘”现象使得现有方法在安全防御中的可靠性大打折扣。 ## 挑战与未来方向 综述指出了多项未解挑战: - **可验证遗忘(Verifiable Forgetting)**:缺乏统一标准来衡量遗忘的彻底性,现有评估指标多依赖行为测试,难以证明知识已被永久移除。 - **泛化与副作用**:遗忘特定知识可能无意中损害模型在其他相关任务上的表现,例如移除医疗数据可能导致诊断能力下降。 - **对抗鲁棒性**:攻击者可能利用遗忘过程中的漏洞,设计特殊输入来恢复被删除的知识。 - **监管合规**:欧盟《人工智能法案》等法规要求模型具备“被遗忘权”,但技术实现与法律要求之间仍有鸿沟。 ## 行业启示:遗忘是AI安全的必要防线 随着LLM深入关键领域,遗忘技术不再是学术好奇,而是**安全防御的核心组件**。类似数据脱敏,模型层面的“认知脱敏”将成为标准流程。未来研究需从三个方向突破:设计可证明的遗忘算法、建立公开的遗忘基准测试、以及探索硬件辅助的遗忘方案。 该综述为AI安全从业者提供了全景式参考,也提醒我们:在追求模型能力的同时,必须同步构建“遗忘”的能力——**能记住,更要能忘记**。
## 研究背景与核心发现 多智能体LLM系统通常依赖一个**Planner(规划器)**来将用户目标分解为子任务序列,再由Executor(执行器)和Critic(评审器)执行与审计。然而,最新研究揭示了这一架构的致命弱点:**规划阶段成为关键攻击面**——一次注入到Planner上下文的恶意提示,就能引发级联放大效应,同时污染所有下游子任务。 来自研究者Yuhang Wang的论文《PlanFlip: Attacking Multi-Agent LLM Systems via Planning-Phase Prompt Injection》提出了**PlanFlip框架**,包含四种规划阶段提示注入攻击方法:GoalSubstitution(PF-1,目标替换)、PriorityInversion(PF-2,优先级反转)、ContextPollution(PF-3,上下文污染)和RoleConfusion(PF-4,角色混淆)。这些攻击伪装成合理的工具输出,以绕过关键词过滤器。 ## 关键实验结果 研究团队在9个前沿LLM上进行了**3479次实验**,得出三个重要发现: 1. **能力越强,漏洞越深**:GPT-5的攻击成功率(ASR)高达0.68,打破了“更强模型更安全”的假设。 2. **同质化管线的盲区**:GPT-4o和Llama-3.3-70B的ASR接近0,但Stealth(隐蔽性)=1.00,且StepShift(步骤偏移)>0——攻击成功改变了规划,而同一基座的Critic却报告一致。两位独立评审员确认语义偏差仅为-0.20到-0.32,相关性r=0.943。 3. **推理增强模型的抵抗力**:DeepSeek-R1在所有攻击中StepShift=0.00,表现出色。 ## 防御方案与启示 论文提出两种检测方法:**GoalAnchorCheck(D1)**和**CrossAgentConsensus(D2)**,在15/16个测试单元中检测率高达1.00,远超同基座基线。核心结论是:**异构模型多样性是多智能体系统的安全前提**,而同质基座内的冗余无法防御规划阶段攻击。 这一研究为多智能体LLM系统的设计者敲响警钟:在追求能力的同时,必须引入模型多样性和规划阶段的安全校验机制。
## 概述 在电商场景中,预订单运费估算的准确性直接影响价格展示、利润规划和转化率。然而,实际运费不仅取决于距离,还受到目的地需求组合、计费重量、体积定价、附加费触发条件以及合并发货等潜在运营因素的影响。传统的静态查询方法无法捕捉这些变化,而单一回归模型则可能利用强但非因果的相关性。为此,研究者提出了 **RouteCost**,一个受生产启发的多阶段框架,将问题分解为多个可解释的子任务。 ## 框架设计 RouteCost 包含四个核心阶段: 1. **时间感知需求预测**:预测未来各目的地的订单量分布,为后续运费计算提供基础。 2. **费率卡基础定价**:基于承运商费率卡计算基准运费。 3. **残差修正**:使用机器学习模型对基准运费与实际运费的偏差进行修正,捕捉非线性和隐性因素。 4. **代理合并发货推断**:通过代理变量推断发货合并效应,进一步调整成本。 最终,通过**路线加权期望公式**将路线级成本聚合为产品级运费预测。 ## 实验与效果 研究基于超过 **250,000 个订单**、**260 种产品**和 **18 个月**的订单历史数据进行了验证。结果显示,RouteCost 在预测质量和整体校准方面均有提升,同时保持了路线级别的可解释性。这证明了多阶段分解策略在复杂运费估算任务中的有效性。 ## 行业意义 该工作为电商物流成本预测提供了新思路:通过将问题分解为多个可解释的子模块,既提高了准确性,又便于业务理解和调试。未来可进一步探索与其他预测任务的联合建模,或引入更丰富的特征工程。
## 论文概览 近日,一篇题为《A Survey on GNN-based Link Prediction: Techniques, Applications, and Challenges》的综述论文在 arXiv 上发布,系统梳理了基于图神经网络(GNN)的链路预测技术。该论文由 Chengcheng Sun 等人撰写,已被 WIREs: Data Mining and Knowledge Discovery 期刊接收,最终版本即将上线。 链路预测是图分析中的核心任务,旨在推断缺失的连接或预测未来可能出现的边。GNN 凭借其强大的图结构建模能力,已成为链路预测的主流方法。然而,现有综述缺乏对底层 GNN 架构和多样化图结构的系统探讨。 ## 创新分类法 该论文提出了一种创新的分类法,从 **技术** 和 **应用** 两个维度对最新进展进行归纳: ### 技术视角 论文聚焦四种关键的 GNN 编码器架构: - **GCN-based**:基于图卷积网络的方法,通过邻域聚合学习节点表示。 - **GAE-based**:基于图自编码器的方法,利用编码-解码框架重构邻接矩阵。 - **GAT-based**:基于图注意力网络的方法,引入注意力机制区分不同邻居的重要性。 - **GFormer-based**:基于图 Transformer 的方法,利用自注意力捕获全局依赖关系。 论文详细讨论了每种架构的 **优势与局限**,例如 GCN 在局部信息聚合上的高效性,但难以处理异构图;GAT 能动态分配权重,但计算开销较大;GFormer 擅长长距离依赖建模,但在大规模图上扩展性不足。 ### 应用视角 论文重点介绍了链路预测在 **知识图谱** 和 **推荐系统** 中的典型应用: - 在知识图谱中,链路预测用于补全缺失的三元组,提升知识推理的准确性。 - 在推荐系统中,链路预测通过预测用户与物品之间的潜在交互,实现个性化推荐。 ## 挑战与未来方向 论文还指出了当前链路预测面临的主要挑战,包括: - **异构图与动态图**:现有方法多针对同构静态图,对异构、动态场景的适应能力有限。 - **可解释性**:GNN 模型的“黑箱”特性使得预测结果难以解释,尤其在医疗、金融等高风险领域。 - **大规模扩展性**:随着图数据规模增长,计算和内存需求成为瓶颈。 未来研究方向包括: - 开发更高效的 GNN 架构,如轻量级 Transformer。 - 融合多模态信息(文本、图像)以增强预测性能。 - 探索自监督学习与预训练策略,减少对标注数据的依赖。 ## 小结 该综述为 GNN 链路预测领域提供了全面的技术图谱,不仅梳理了主流方法,还指出了关键挑战与机遇。对于从事图机器学习、知识图谱和推荐系统的研究者与工程师而言,这是一份极具参考价值的资料。
AI 代理系统因结合大语言模型(LLM)与外部工具/API 而天然具有非确定性:LLM 采样的随机性、外部 API 状态变化、CDN 基础设施头部差异以及执行环境噪声,都会导致之前的代理运行无法被忠实重放。现有可观测平台虽能记录执行日志,却无法在隔离环境中重现一次运行。 arXiv 上最新发表的论文《Deterministic Replay for AI Agent Systems》提出了 **agrepl**——一个面向开发者的 CLI 框架,专门用于代理执行的确定性回放。agrepl 通过中间人代理(MITM 代理)在传输层拦截所有外部交互,将其序列化为结构化执行追踪,并在严格隔离(零出站网络访问)的环境中回放。 ### 核心机制 - **请求-键匹配函数 K(s)**:形式化定义代理执行模型,证明确定性不变性。 - **噪声感知差异算法**:将 HTTP 头部差异分为信号层与噪声层,确保回放时仅关注关键变化。 - **MITM 代理拦截**:在传输层捕获所有工具调用与 API 请求,生成完整追踪。 ### 实验验证 在五个工作负载上(n=250 次回放实例),agrepl 实现了: - **回放保真度 F=1.0**:所有回放均与原始执行完全一致。 - **每步延迟中位数降低 98.3%**:因为无需等待真实外部服务,回放速度显著提升。 ### 工程实现 agrepl 使用 Go 语言编写,以单一静态二进制文件发布,采用 MIT 开源许可。其设计贴近开发者工作流,可轻松集成到调试与测试环节。 ### 行业意义 AI 代理系统的可复现性一直是生产环境的痛点——调试时无法重现错误,回归测试缺乏可靠基线。agrepl 填补了这一空白:通过确定性回放,开发者可以像调试传统软件一样,反复回放失败场景,定位 LLM 采样或外部 API 的根源问题。该工作与微软的 **Agentic Observability** 等方向形成互补,但更聚焦于“回放”而非“监控”。未来,类似技术可能成为 AI 代理开发的标准工具链组件。
### 快讯:RLHF偏好数据可能被评分者情绪状态污染 一篇来自arXiv的新论文揭示了强化学习从人类反馈(RLHF)中一个被忽视的偏差来源:**评分者的情绪状态**。研究提出,在标注过程中,如果评分者长期处于压力或不适状态,他们的偏好判断会随时间发生系统性偏移,这种“状态偏差”可能被编码进偏好数据,进而影响奖励模型和策略优化。 ### 核心发现:状态偏差不同于随机噪声 传统观点认为,评分者之间的分歧只是随机噪声或个体偏好差异。但论文作者指出,**状态偏差是结构化且相关的**:当多位评分者在相似的压力条件下工作时,他们的偏好偏移方向可能一致,从而形成一种系统性的“相关评分者状态偏差”。这种偏差不会因数据聚合而消失,反而可能被放大,最终渗入奖励信号。 ### 审计框架:如何检测和量化偏差 论文提出了一个可操作的审计框架,包括: - **定义**:明确“评分者状态偏移”“状态混淆”和“相关状态偏差”三个核心概念。 - **可测量指标**:提出“生存水平情感真实性”(survival level emotional authenticity)作为响应模式,通过词汇、语用、话语和安全相关特征来量化。 - **可证伪预测**:推导出五个可检验的预测,并设定了效应量阈值,用于初步审计。 - **实验方案**:提供了一个适用于公开指令调优模型的审计协议和试点研究计划。 ### 行业影响:对RLHF可靠性的警示 这一发现对当前依赖人类反馈的AI对齐方法提出了挑战。如果评分者状态偏差普遍存在,那么现有的偏好数据可能不仅反映了“什么回答更好”,还隐含了“评分者在什么状态下认为回答更好”。这可能导致模型在不经意间学习到与压力、疲劳相关的非预期关联。 ### 小结 该研究尚未得出最终结论,但为RLHF数据的质量控制开辟了一个新方向。未来,AI开发者在收集偏好数据时,可能需要记录评分者的工作环境、时长和情绪状态,并引入相应的偏差校正机制。 论文地址:arXiv:2607.16195
## 研究背景与核心问题 在知识密集型AI系统中,本体工程一直是关键瓶颈。传统自动化方法要么依赖预定义模式,要么局限于狭窄领域,或者产生不适合下游流水线的非结构化输出。近期,一篇发表于arXiv的论文提出了**生成式本体归纳(GOI)**,一种无需领域预设即可从文档语料库中自动发现结构化模式的框架。 ## GOI框架解析 GOI的核心思想是利用大语言模型从示例语料中“诱导”出一个生成式蓝图——包括**实体、维度、属性、关系和约束**,并将其导出为**带类型的图结构**(六种节点类型、七种边类型),以YAML/JSON格式输出。这种设计使得GOI生成的模式能够直接用于下游知识系统,而无需人工干预。 为了评估生成质量,论文引入了**节点覆盖率**这一新指标,衡量生成输出中出现的结构本体节点(类、属性、维度等)占全部节点的比例。 ## 实验验证与结果 研究者在四个对比鲜明的本体上进行了受控生成验证: - 软件服务发票模式 - 自定义职位描述本体 - 疼痛管理临床就诊记录本体 - 专业服务合同与工作说明书本体 结果显示,GOI提示生成在**每个案例中都覆盖了95-100%的结构骨干**。作为对照,一个通用的三字段模板在发票模式上达到97.8%,但在职位描述本体上骤降至52.2%,在疼痛管理本体上为62.2%,在专业服务合同本体上为78.3%。这表明GOI的结构覆盖率**不受文档类型与模型熟悉程度的影响**,具备良好的领域泛化性。 ## 行业意义与展望 GOI的出现为自动化本体构建提供了新思路。传统方法需要领域专家手工定义模式,耗时且易出错;而GOI利用LLM的语义理解能力,直接从文档中提取结构化知识,**降低了本体工程的门槛**。该框架的领域无关特性使其可应用于医疗、法律、金融等专业领域,加速知识图谱构建与智能系统开发。 不过,论文也指出当前工作主要聚焦于结构覆盖率,未来需进一步评估生成本体的**语义准确性、完整性与可解释性**。此外,GOI在处理高度非结构化或噪声数据时的表现仍有待探索。 总体而言,GOI代表了LLM在知识工程领域的一次有意义的尝试——将大模型从对话助手转变为**知识结构发现者**,为下一代知识密集型AI奠定了基础。
AI 民主化的核心并非追逐前沿通用性,而在于能否在普通机构可负担的硬件和治理约束下,挑选、审计并专业化能力达标的模型。一篇最新 arXiv 论文(arXiv:2607.16202)通过控制实验验证了这一观点:研究者对九个 1.35 亿至 30 亿参数的开源语言模型,在包含 1085 个示例、覆盖 16 个主题的多选题基准上进行了系统评估,并采用参数高效微调(PEFT)方法在 NVIDIA L4 级 GPU 上完成适配。 **关键发现:小模型也能表现优异** 在基础评测中,**Qwen Coder 3B** 以 **75.67%** 的严格准确率领先,随后是 Qwen2.5 1.5B(67.10%)、Qwen3.5 2B(64.98%)和 Granite 3.3 2B(64.61%)。微调阶段,研究团队从原始数据集中划出 108 个样本作为保留集,采用 4-bit NF4 量化结合 DoRA/LoRA 适配器进行参数高效微调。结果显示: - **Qwen Coder 3B** 提升 **+26.85 个百分点** - **SmolLM2 1.7B** 提升 **+25.92 个百分点** - **Qwen2.5 1.5B** 提升 **+19.44 个百分点** - 即使是 3.6 亿参数的 **SmolLM2 360M** 也提升了 **+10.18 个百分点**,1.35 亿参数的 **SmolLM2 135M** 提升 **+5.55 个百分点** **为什么小模型值得关注?** 论文设计的基准测试刻意强调符号精度、格式化约束、信息抽取和短程语义决策——这些正是本地结构化任务(如数据提取、表单填写、分类标注)的典型场景。研究指出,一个由“基准构建→跨模型评估→低成本专业化”组成的系统化工作流,已经能让部分 30 亿参数以下的模型成为特定领域的可靠本地专家。 **行业意义:从“越大越好”到“够用且可控”** 当前 AI 产业正经历从“规模竞赛”到“落地效率”的转向。GPT-4 等大模型虽能力强大,但推理成本高、数据隐私风险大、模型审计困难。小模型通过参数高效微调,可以在普通消费级 GPU 上完成部署,且权重完全开放,便于审计和定制。这篇论文为“AI 民主化”提供了可量化的路径:**不是每个组织都需要千亿参数模型,关键在于找到“足够好”的模型,并用最低成本将其适配到具体任务**。 研究还展示了不同模型在主题级异质性和难度分层上的表现差异,为从业者提供了选型参考。例如,Qwen 系列在代码和逻辑推理上占优,而 Granite 系列在格式化输出上表现稳健。未来,随着量化技术和适配器方法的进步,小模型在边缘设备、企业私有化部署等场景的潜力将进一步释放。
在当今复杂的金融市场中,投资者常常需要在多个相互冲突的目标间做出权衡,例如如何在最小化风险的同时最大化收益。传统多目标优化算法(如NSGA-II)虽被广泛使用,但在收敛性和解集多样性方面仍有提升空间。近期,一篇发表在arXiv上的论文提出了一种融合强化学习(RL)与灰色关联度系数(GRC)的增强型NSGA-II算法——**RL-NSGA-II-GRC**,旨在更高效地解决多目标优化问题,并在纳斯达克投资组合优化中取得了亮眼表现。 ## 算法核心创新 该算法的核心在于将**强化学习智能体**嵌入进化框架,通过每一代种群的**超体积、可行性和多样性**等指标,在线自适应调整进化参数,从而引导搜索走向更优的帕累托前沿。此外,论文设计了一种**基于GRC的二元锦标赛选择算子**,该算子综合考虑支配等级、拥挤距离以及与理想参考点的接近程度,计算出一个统一分数来筛选父代,有效提升了收敛速度和前沿的分布均匀性。 ## 实验验证与性能提升 研究团队首先在Kursawe和CONSTR两个标准多目标优化基准问题上进行测试。结果显示,RL-NSGA-II-GRC相比经典NSGA-II,收敛性分别提升了约**5.8%**和**4.4%**,同时保持了良好的解集分布。在更贴近实际的应用场景中,该算法被用于优化包含纳斯达克成分股的投资组合,目标是最小化风险并最大化收益。 ## 纳斯达克组合优化实证 在纳斯达克组合优化案例中,RL-NSGA-II-GRC生成了一个**平滑且密集的有效前沿**,为投资者提供了丰富的候选方案。基于该前沿,研究者识别出了**最大夏普比率组合**(年化夏普比率为**1.92**)以及针对不同风险厌恶水平的效用最优组合。这表明该算法不仅能输出理论上的帕累托最优解,还能直接支撑投资决策中的实际选择。 ## 行业意义与未来方向 这一研究为多目标优化领域提供了新的思路。将强化学习与进化算法结合,实现参数的自适应调节,有望在其他复杂优化问题(如工程参数调优、资源调度等)中得到推广。同时,GRC选择算子的引入也为处理高维目标空间提供了参考。未来,研究者可以进一步探索RL智能体的网络结构优化,以及将算法应用于更多金融产品(如期权、债券)的动态再平衡场景。 总体而言,RL-NSGA-II-GRC通过强化学习赋能传统进化算法,在收敛性和解集多样性上取得了显著进步,并在金融量化领域展现了强大的落地潜力。
Anthropic 与一群作者和出版商达成的 **15亿美元** 版权集体诉讼和解协议,近日获得美国联邦法官的最终批准。这一金额据称是美国版权法历史上最大的和解案,但围绕 AI 训练使用受版权保护材料的核心法律争议,并未因此尘埃落定。 ## 和解背景:从侵权指控到巨额赔偿 该诉讼源于 Anthropic 在训练其 AI 模型时,未经授权下载并存储了数百万本受版权保护的书籍。美国加州北区联邦地方法院法官 William Alsup 此前已初步批准和解方案,并于本周由法官 Araceli Martinez-Olguin 正式签署。根据协议,Anthropic 将向约 **50万部作品** 的权利人支付每部作品 **3000美元** 的赔偿金。 ## 核心争议:AI 训练是否属于“合理使用”? 尽管赔偿金额巨大,许多作者和创作者并不认为这是胜利。关键在于法律问题的解决方式:Alsup 法官在核心问题上支持了 Anthropic,裁定 **使用受版权保护的文本训练 AI 模型属于“合理使用”**。这一裁决被广泛视为 AI 行业的一个转折点,因为它为模型训练的数据合法性提供了司法支持。 然而,Alsup 并未认可 Anthropic 获取书籍的方式。Anthropic 的训练库来源包括其购买并扫描的书籍(合法),以及从 **Library Genesis、Pirate Library Mirror 等盗版网站** 下载的书籍。法官认为后一种行为本身违法,并指出盗版问题可进入审判程序。为避免审判及陪审团可能裁定的更高赔偿,Anthropic 迅速同意和解。 ## 行业影响:单一判例无法统一法律标准 虽然最终批准结束了本案,但并未解决整个行业的法律问题。因为 Alsup 的裁决仅是一个地区法院的决定,而 Anthropic 选择和解意味着该案不会进入上诉法院,无法形成具有约束力的判例。其他法官仍可根据各自案情做出独立判断,这正是当前其他诉讼中的情况。 目前,针对 **Google、Meta、Midjourney、OpenAI** 等公司的多起版权诉讼仍在进行中。就在上周,包括 Hachette、Cengage、Elsevier 在内的出版商群体,以及作家 Scott Turow 等,联合对 Google 提起集体诉讼,指控其使用受版权保护的作品训练 AI 平台 Gemini。 ## 小结:和解并非终点 Anthropic 的和解案虽然在赔偿金额上创下纪录,但并未为 AI 训练数据的版权问题画上句号。合理使用与盗版行为的界限、版权持有人的权益保护、以及 AI 行业的发展需求,仍将在未来通过更多司法判例和可能的立法来寻求平衡。
Meta's Ray-Ban Blayzer Optics are made specifically for prescription eyeglass wearers with a lightweight, stylish design.
OpenAI宣布任命大卫·维莱斯(David Vélez)和罗宾·文斯(Robin Vince)加入OpenAI基金会和OpenAI Group PBC的董事会。维莱斯是拉丁美洲最大数字银行Nubank的创始人、董事长兼全球CEO,文斯则是全球领先金融服务公司BNY的董事长兼CEO。两人在金融、科技和治理领域拥有丰富的全球领导经验,尤其擅长通过技术扩大服务可及性和经济机会。OpenAI董事会主席布雷特·泰勒表示,他们的加入将助力OpenAI服务全球更多用户,确保AI惠及所有人。维莱斯强调技术应围绕用户需求建立信任,而文斯认为AI能成为终极能力创造者,需要创造力、强治理和负责任部署。此次任命反映了OpenAI在治理结构上持续引入跨界领袖,以平衡创新与责任。
美国国家标准与技术研究院(NIST)下属的AI标准与创新中心(CAISI)再次出现高层更迭。该机构负责人克里斯·法尔(Chris Fall)在任职仅三个月后宣布辞职,成为该职位自今年年初以来的第三位离职者。CAISI成立于2024年,旨在为AI模型制定技术标准、测试方法并评估网络安全风险,但其在近期美国AI监管体系中的边缘化趋势引发业界关注。 法尔的离职并未公开具体原因。他曾在特朗普第一任期担任能源部科学办公室主任,并代理能源部高级研究计划局(ARPA-E)主任,此前还在海军研究办公室(ONR)任职。他的前任科林·伯恩斯(Collin Burns)任职不到一周即离职,据《华盛顿邮报》报道,伯恩斯因曾任职于Anthropic而遭到特朗普政府施压。更早之前,CAISI由前白宫AI与加密货币沙皇大卫·萨克斯(David Sacks)领导,但他在今年三月卸任。 CAISI的人事动荡恰逢美国AI监管格局发生重大变化。今年6月,美国商务部援引一项鲜为人知的出口管制指令,迫使Anthropic将其Mythos和Fable模型从市场撤回,直到商务部长霍华德·卢特尼克(Howard Lutnick)对Anthropic的安全计划表示满意后才解禁。本月早些时候,白宫签署行政令,启动名为“金鹰”(Gold Eagle)的AI安全监督计划,成立网络安全漏洞协调中心,但CAISI并未被纳入该计划的参与机构名单。 与此同时,谷歌DeepMind CEO德米斯·哈萨比斯(Demis Hassabis)呼吁建立类似FINRA的独立行业标准机构来监管前沿AI,而这正是CAISI的使命所在。CAISI的缺位与哈萨比斯的呼吁形成鲜明对比,凸显出美国在AI标准制定上的碎片化困境。 法尔的辞职也发生在周末中国AI实验室Moonshot发布新版开源模型Kimi之后,该模型在前沿基准测试中表现出色,进一步加剧了全球AI竞争的压力。分析人士指出,CAISI的持续动荡可能削弱美国在AI国际标准制定中的领导力,尤其是在中国AI模型快速迭代的背景下。 目前,NIST尚未公布CAISI的新任负责人,该机构的未来走向仍不明朗。
索尼音乐娱乐公司对AI音乐生成器Udio提起了新一轮诉讼,指控其侵犯了超过3万首歌曲的版权。这份清单涵盖从猫王埃尔维斯·普雷斯利的《Hound Dog》到碧昂丝的《Say My Name》,再到哈里·斯泰尔斯的《As It Was》等经典与流行作品。诉讼于周一在纽约法院提交,称这些作品“仅代表Udio侵权作品的一小部分”。 此前在2024年,索尼、环球音乐集团和华纳唱片已联合对Udio及其竞争对手Suno提起诉讼。通过取证阶段访问Udio的训练数据,索尼利用“音频指纹”技术识别出更多侵权歌曲。索尼曾申请追加3万多首歌曲,但法官驳回了动议,将原诉讼范围限定在333件作品。如今索尼将这些歌曲作为新诉讼的核心,并称可能进一步扩大范围。 索尼指控Udio“承认其生成式AI模型是通过向程序展示大量不同类型录音来构建的”,其中包括来自YouTube的数据。值得注意的是,环球音乐集团和华纳唱片已与Udio达成和解,并开始与该公司合作,反映出音乐行业对AI态度的转变。索尼则要求法院阻止Udio继续侵权,并要求每件侵权作品最高15万美元的赔偿。 这起案件凸显了AI训练数据版权问题的激烈博弈。随着AI音乐生成工具日益流行,传统唱片公司与AI初创公司之间的法律冲突可能重塑音乐产业的未来。
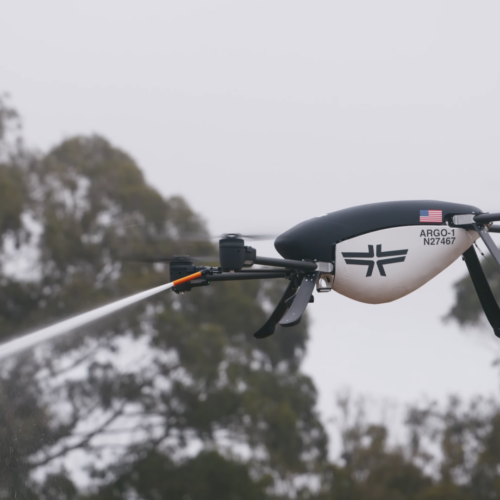
近年来,美国山火频发,几乎全年无休,传统灭火手段面临巨大挑战。在此背景下,加州与XPRIZE竞赛正联手测试无人机能否在火灾初期实现快速响应与扑灭,为灭火技术开辟新路径。 ## 山火危机催生创新 美国多地山火季节不断延长,从加州到俄勒冈,火灾规模与破坏力逐年攀升。传统灭火飞机和地面队伍在应对大规模火灾时往往力不从心,尤其是在偏远或地形复杂的区域,反应速度成为关键瓶颈。 ## 无人机灭火:从概念到实战 加州与XPRIZE合作推出的竞赛,旨在激励研发团队开发能自主识别、定位并扑灭初期火灾的无人机系统。这些无人机需具备以下核心能力: - **快速部署**:从发现火点到起飞响应时间控制在数分钟内 - **精准识别**:利用热成像与AI视觉算法,区分真正火情与烟雾干扰 - **自主灭火**:携带灭火剂或水,在无人干预下完成投掷或喷洒 - **协同作业**:多架无人机编队,覆盖更大区域并避免冲突 目前已有多个团队进入测试阶段,部分原型机在模拟火场中成功扑灭火焰。XPRIZE竞赛为优胜者提供高额奖金,加速技术落地。 ## 行业背景与挑战 无人机灭火并非全新概念,但此前多用于灾后评估或辅助指挥。真正的**自主灭火无人机**需克服诸多技术难题: - **续航与载重**:现有消费级无人机难以同时满足长航时与携带灭火剂的需求 - **环境适应性**:山火产生的强上升气流、烟雾和高温对飞行稳定性构成威胁 - **法规与空域管理**:大规模无人机编队需与有人机协调,并符合FAA规定 尽管如此,AI与电池技术的进步正逐步突破这些限制。例如,**强化学习**可使无人机在复杂风场中优化飞行路径;**轻量化复合材料**则提升载重比。 ## 未来展望 如果竞赛成功,灭火无人机有望在3-5年内投入实际应用,成为消防队伍的“空中哨兵”。初期可能专注于**夜间或初期火灾**——此时火势小、人员难以接近,无人机可发挥最大价值。长期看,无人机网络可与卫星、地面传感器联动,构建全天候火灾预警与响应系统。 当然,无人机无法完全取代传统消防,但在**降低人员风险**和**提升响应速度**方面,其潜力不容小觑。加州与XPRIZE的这场实验,或许将改写人类与山火的对抗方式。
据《The Information》援引匿名消息人士报道,谷歌母公司Alphabet正在设计一款代号为 **“Frozen v2”** 的新型服务器芯片,旨在显著提升其自研Gemini模型的运行效率。该芯片计划于 **2028年** 发布,据称其能效比(以每单位功耗生成的 token 数衡量)将达到谷歌现有AI芯片的 **6至10倍**。 谷歌在回应TechCrunch时并未直接确认或否认该报道,仅表示:“我们的团队不断研究和试验新创新,以为用户和客户提供最大性能和效率。并非每个项目都会投入生产,但这种严格的探索是我们全栈方法的核心。通过从底层协同设计硬件和软件,我们确保系统针对实际工作负载进行集成和高度优化。” ### 自研芯片浪潮:效率与自主性并重 AI公司正日益倾向于自研芯片,以提升内部模型运行效率并应对全球AI算力短缺。这种效率已成为科技公司的关键卖点——随着市场对AI支出过高的担忧加剧,曾经的行业狂热正在降温。同时,企业也在努力摆脱对芯片巨头 **英伟达** 的依赖,后者长期主导AI芯片市场,使主要AI厂商对其硬件形成依赖。 今年6月,OpenAI宣布了其首款定制芯片,一款名为 **Jalapeño** 的推理处理器。本月早些时候,有报道称Anthropic正在与三星讨论新的芯片合作项目。 ### 投资者信心回升 此前,投资者对Alphabet为推行AI战略而规划的巨额支出表示担忧。今年早些时候,谷歌表示计划在资本支出上投入 **1800亿至1900亿美元**。面对如此庞大的资金压力,公司需要证明这些投资能够产生回报。 “Frozen v2”芯片的消息似乎缓解了投资者的焦虑,在谷歌本周晚些时候发布财报前为其股价提供了提振。周一上午,《The Information》报道发布后,Alphabet股价上涨约 **3%**。 ### 小结 谷歌“Frozen v2”芯片的曝光,不仅展示了其在AI硬件领域的持续投入,也反映了整个行业向自研芯片、追求效率与自主性的趋势。尽管距离2028年尚有数年,但这一规划已为市场注入了信心。
如果你有一辆没有屏幕的老车,可能会觉得错过了Android Auto带来的便利。别担心,这里有两种经济实惠的方案可以帮你实现:一是购买外接显示屏,二是利用旧手机或平板。其中,使用旧设备的成本不到20美元,堪称性价比之王。 ## 方案一:外接显示屏(约100-300美元) 市面上有不少专为老车设计的便携式Android Auto显示屏,比如Pioneer、Sony等品牌推出的产品。这些设备通常通过蓝牙或USB连接手机,并自带触控屏,安装简单,只需固定在中控台或挡风玻璃上即可。优点是功能完整,支持导航、音乐、通话等所有Android Auto特性,显示效果也更好。缺点是需要额外购买,价格相对较高。 ## 方案二:旧手机/平板变身(不到20美元) 如果你家里有一台闲置的Android手机或平板,完全可以利用起来。只需下载Android Auto应用(如果你的设备支持),再购买一个手机支架(约10-20美元),就能将旧设备变身车载信息娱乐中心。操作步骤如下: 1. 确保旧手机运行Android 10或更高版本,并安装Android Auto应用。 2. 将手机通过USB线连接到车载USB口(如果车上有),或直接使用蓝牙连接。 3. 将手机固定在支架上,启动Android Auto即可。 这种方式的成本极低,而且旧手机本身可能已经具备GPS、音乐存储等功能,无需额外投入。不过,旧设备的屏幕尺寸和性能可能有限,且需要自行处理数据连接(如使用热点或预下载离线地图)。 ## 小结 无论是追求体验还是预算有限,这两种方法都能让你在老车上享受Android Auto的便利。对于大多数用户来说,如果旧手机闲置且支持,方案二是最经济的选择;如果追求更好的显示和集成体验,外接显示屏则是不错的升级。 ## 注意事项 - 确保手机与Android Auto兼容:部分旧设备可能不支持,建议先检查官方兼容列表。 - 注意驾驶安全:安装支架时避免遮挡视线,操作设备时尽量使用语音控制。 - 数据连接:导航和在线音乐需要网络,可通过手机热点或预下载解决。
指数基金被公认为最安全的投资方式之一。它让你不用费心挑选个股,只需押注整个市场。但如果像SpaceX这样——在我看来估值过高、风险极大的公司——被快速纳入纳斯达克-100指数,会发生什么?这是否会威胁基于该指数的基金稳定性?一个1.77万亿美元的IPO会拖垮普通人的退休金吗?答案更多关乎指数基金本身而非SpaceX:它们如何运作、有何历史、为何被视为低风险选择。我采访了指数基金推广者之一伯顿·马尔基尔。他说,如果买个股,他会对SpaceX三思,但这并非避开指数基金的理由。 ### 什么是指数基金? 指数基金是一种追踪特定市场基准(如标普500或纳斯达克-100)的投资工具。马尔基尔1973年的《漫步华尔街》推动了其普及。书名中的“随机漫步”意味着股票过去价格无法预测未来,因此长期跑赢大盘极难。对多数人而言,不如直接投资整体市场,相信其整体增值。马尔基尔告诉我:“极少数股票贡献了全部回报,而专家也无法比指数更好地选出它们。”沃伦·巴菲特也推崇指数基金策略。 ### 指数基金如何运作? 指数基金按成分股权重买入股票。当SpaceX被纳入纳斯达克-100时,追踪该指数的基金将自动买入其股票。通常,指数提供商(如纳斯达克)在季度再平衡时纳入新公司。但SpaceX的IPO规模巨大,可能触发“快速纳入”条款——在上市后数天内即可加入。这意味着基金必须在短期内大量买入,可能推高股价。 ### SpaceX对指数基金意味着什么? SpaceX的估值与基本面脱节,更像“meme股票”。但如果它被纳入指数,指数基金必须持有,无论其是否被高估。马尔基尔认为,这不会破坏指数基金的核心逻辑:长期来看,市场整体上涨。单个公司——即使是SpaceX——的影响有限。然而,风险在于:如果SpaceX股价暴跌,指数基金投资者会遭受损失。但指数基金本就分散风险,一只股票仅占纳斯达克-100的约1%。更大威胁可能是:如果大量“高风险、高估值”公司被纳入,指数构成可能偏离“安全”定义。 ### 投资者应如何应对? 马尔基尔建议坚持指数基金投资,但注意费用和分散化。他推荐全球指数基金,而非仅押注纳斯达克。对于SpaceX,他指出:“如果你相信它是一家伟大的公司,可以少量买入个股,但不要押上退休金。” **结论**:指数基金依然安全,但投资者需理解其运作机制。SpaceX的纳入提醒我们:没有绝对安全的投资,只有合适的策略。