
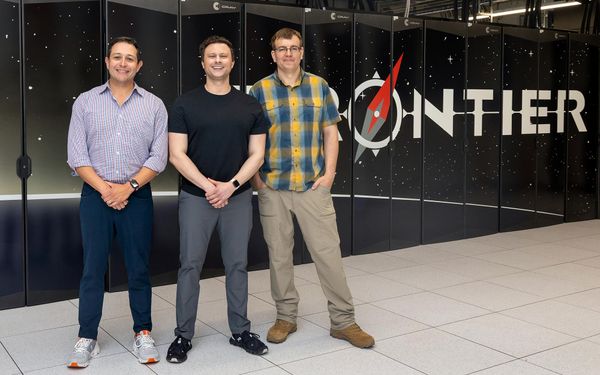
## 核电站遇上AI:一场迫在眉睫的联姻 美国核电站正面临一个严峻的现实:**专业人才不断流失,而现役机组日益老化**。据IEEE Spectrum报道,以**Atomic Canyon**为代表的一批公司正将AI引入核工业,试图用智能助手填补人力缺口,帮助维护这些关键能源基础设施。 ### 为什么核电站需要AI? 核能行业高度依赖经验丰富的专业技术人员,但这一群体正在萎缩。与此同时,美国许多核电机组已运行数十年,维护复杂度与日俱增。AI助手能够辅助工程师快速检索海量技术文档、历史维护记录和监管要求,从而**降低对个别专家记忆和经验的过度依赖**。 Atomic Canyon团队曾站在橡树岭国家实验室的**Frontier超级计算机**前——这暗示了其技术路线:利用高性能计算训练面向核领域的专用AI模型,让AI理解核工业的术语、安全标准和操作流程。 ### AI能做什么,不能做什么? 目前AI在核电站的应用仍以**辅助决策**为主,例如: - 快速定位技术规格和合规条款 - 辅助生成维护检查清单 - 从历史数据中识别异常模式 但核安全容不得半点马虎,AI不会直接控制反应堆,最终决策权仍在持证操作员手中。 ### 行业背景与挑战 美国核电站提供了全国约**20%的电力**和近一半的低碳电力,维持其安全运行对国家能源战略至关重要。然而,核工业的保守文化和对AI可解释性的高要求,意味着技术落地不会一蹴而就。Atomic Canyon等公司的探索,正是在**安全与效率之间寻找平衡点**。 如果成功,AI或许能帮助美国核电站延寿运行,为能源转型争取更多时间;如果失败,则可能加剧公众对核能的不信任。这场实验的结果,将深刻影响核能行业的未来。
## 从聊天机器人到「数字同事」 Google 正在把 Gemini 从「会聊天的助手」推向「能干活的同事」。在周四举行的 **Gemini at Work** 活动上,Google 宣布推出一款「通用型」Gemini AI 智能体,它可以在后台跨应用、跨设备地自主执行工作任务,用户只需在 **Gemini Enterprise** 应用中通过一个统一界面与它对话、派活即可。 这款产品目前仅面向企业客户开放**私有预览**,但它透露出的信号很明确:Google 想让 AI 助手从「你问我答」升级为「你交办、我完成」。 ## 一个入口,打通所有工作场景 根据官方介绍,这个智能体的核心卖点是「一站式」: - **深度嵌入 Workspace**:可以直接在 Gmail、Drive、Docs、Sheets、Calendar 等应用内部工作; - **多端统一**:用户可以从手机、桌面端、网页,以及 Slack、Microsoft 365 等第三方应用与它交互; - **云端保持上下文**:由于运行在云端,Gemini 在所有已连接设备上维持同一份上下文,不会出现「换个设备就失忆」的问题。 值得注意的是,Google 特别强调它能与**岗位专属的子智能体**协作完成任务,还能以「**同事智能体**」的身份运行——拥有独立身份和自己的邮箱地址 `@agents.company.com`。这意味着它不再只是一个工具,而是被当作组织架构里的一个「成员」来对待。 在执行任务时,Gemini 会自动选择最适合当前工作的 AI 模型,用户无需手动切换。 ## 企业先行,消费级已有铺垫 这不是 Google 第一次试水「代理式 AI」。今年 5 月,Google 就推出了面向消费者的 **Gemini Spark** 智能体,订阅用户可以用它在 Workspace 和网页上执行任务,但入口是 Gemini 应用内一个独立界面,与这次的统一界面思路并不相同。 从 Spark 到如今的通用企业智能体,可以看出 Google 正在收敛产品形态:与其让用户记住多个入口,不如把所有能力塞进一个窗口。 ## 这意味着什么 对企业用户来说,真正的价值不在于「AI 能回答问题」,而在于「AI 能替人跑流程」。跨应用、跨设备、保持上下文、拥有独立身份——这几个特性叠加起来,指向的是把 AI 从辅助工具变成可委派任务的执行者。 当然,目前它还处于私有预览阶段,实际的任务完成度、权限管理和可靠性都还有待验证。但方向已经清晰:AI 助手竞争的下一站,是谁能真正把活干完。
## 消费级 AI 代理来了,但你真的敢把生活交给它吗? 过去一年,AI 代理(Agent)从极客圈的小众玩具迅速走向大众市场。The Verge 资深 AI 记者 **Hayden Field** 在最新一期 *Decoder* 播客中与主编 **Nilay Patel** 深入讨论了这个转折点:**Meta 的 Muse**、**OpenAI 的 Dots** 以及 **xAI 的 Grok Bot** 相继发布,把「能替你订餐厅、清理收件箱、甚至处理营销和法务工作」的自主代理推到了数百万普通用户面前。 ### 从 Mac Mini 抢购到主流产品 如果你一直关注这个领域,应该记得今年早些时候一波 **OpenClaw** 自制代理方案曾带动 **Mac Mini** 销量激增。但那终究是爱好者的游戏。真正让代理进入主流视野的,是 Meta 和 OpenAI 几乎同时推出的消费级产品。两家公司不约而同地选择了**可爱的动画吉祥物**作为交互形象,试图降低用户对「自主 AI」的心理门槛。 两者的定位差异也很明显: - **Muse 免费**,而 **Dots 收费**; - OpenAI 为 Dots 推出了面向**营销、法律、会计**的「专家」版本,走专业化路线; - Meta 至今**没有自己的前沿大模型**,却可能凭借其**制造和分发消费级产品的超强能力**,在这场竞赛中占据独特优势。 ### 核心矛盾:能力与信任的拉锯 Hayden 和 Nilay 的对话触及了代理竞赛中最根本的张力:**AI 今天擅长什么、还做不到什么**,以及当你把**信用卡信息、邮箱收件箱和硬盘敏感数据**交给一个可能无需 App、无需手机就能替你行动的 AI 时,隐私与安全意味着什么。 这或许就是未来计算的形态——**永远在线、自主运行**。但播客中反复出现的一个疑问是:**大多数人是否真的愿意交出这些数据来换取便利?** 目前答案并不明朗。 Meta 和 OpenAI 都在赌用户会习惯这种交换。Muse 的免费策略可能加速这一进程,而 Dots 的付费与专家定位则试图证明代理能创造可衡量的商业价值。但无论哪条路径,信任都是绕不开的门槛。 ### 值得关注的几个问题 - **数据边界**:代理需要访问多少个人数据才能「好用」?用户能否精细控制? - **责任归属**:当代理自主做出错误决策(如错误预订、误删邮件),谁来负责? - **竞争格局**:没有前沿模型的 Meta,能否靠产品力弥补技术差距? 这场访谈没有给出简单答案,但它清晰勾勒出消费级 AI 代理从「酷炫 demo」走向「日常基础设施」时必须跨越的信任鸿沟。
在纽约电影节首映礼上,导演**卢卡·瓜达尼诺**谈到他的新片《Artificial》时说:“当有人想扮演上帝时,这对我来说非常有趣。”这部以**萨姆·奥特曼**为原型的讽刺传记片,核心正是围绕“扮演上帝”与权力展开——谁拥有权力、谁渴望权力、谁又不惜一切代价去争夺它。 ## 一部贴着事实走的讽刺剧 据 The Verge 资深 AI 记者 **Hayden Field** 的观察,这部黑色喜剧几乎踩中了科技圈所有为人熟知的里程碑事件。影片叙事紧贴 OpenAI 首席执行官崛起、以及短暂被罢免的真实经过,在讽刺与事实之间保持了微妙的平衡。 影片以旧金山**金门大桥**的震撼镜头开场,这座桥随后成为贯穿全片的隐喻——象征构建全知全能 AI 系统的野心。由**安德鲁·加菲尔德**饰演的奥特曼一次又一次指向大桥:先是说服未来的联合创始人**伊利亚·苏茨克维**相信他们愿景的重要性,随后又用这座桥来控制这位科学家。 ## 被夸张却似曾相识的角色群像 片中所有角色都或多或少是被夸张、被讽刺化的本人版本: - **埃隆·马斯克**(由艾克·巴林霍尔茨饰演)被塑造成当时广受爱戴、行程爆满、忙得不可开交的远见者,习惯身边人捧场他的笑话,浑身散发着千禧一代的尴尬感——他戴墨镜的次数比任何角色都多,爱说“史诗级”,还会在桌上敲鼓点。 - **OpenAI 总裁格雷格·布罗克曼**(库珀·霍夫曼饰)则是一个极度忠诚的兄弟式人物,对奥特曼亦步亦趋,最关心金钱与权力,片中有一幕他戴着一条疑似写着“ChatGPT”的钻石项链。 - **OpenAI 首席技术官米拉·穆拉蒂**(莫妮卡·巴巴罗饰)被描绘成才华横溢却容易动摇的局外人。 - **苏茨克维**则被塑造成理想主义、天真的英雄——整个实验室背后的天才头脑,无法忍受说谎,也不愿同流合污。 ## 为什么值得关注 在 AI 行业高速发展、权力高度集中的当下,《Artificial》选择用讽刺喜剧的方式回望 OpenAI 的内部动荡,既是对科技巨头个人崇拜的调侃,也是对“谁来掌控超级智能”这一严肃命题的追问。影片忠于事实的底色,让它在娱乐之外多了一层行业档案的价值。
## Google Maps正在成为你的餐饮决策中心 还在用Yelp找餐厅?Google Maps早就不是那个只会给你指路的地图应用了。通过一系列AI驱动的功能更新,Google正在把Maps打造成一个从“找餐厅”到“下单”的一站式平台——而且它可能比你想的更好用。 ### 对话式点餐,动动嘴就能下单 2024年8月,Google宣布其Gemini驱动的聊天工具**Ask Maps**可以理解对话式指令。你只需要像跟朋友聊天一样说出想吃什么,Maps就能帮你找到匹配的餐厅并直接下单。 最初,官方合作方只有**Toast**一家。但现在,用户已经可以通过**Square**和**Uber Eats**完成点餐。这意味着Google正在快速扩大其餐饮生态的覆盖面,减少用户在多个应用之间跳转的麻烦。 ### 趋势探索,跟着热点找美食 Google Maps的**Explore标签页**可以展示你附近正在被其他用户频繁搜索的热门餐厅。这个功能反映的是真实的用户行为趋势——你在Instagram或TikTok上刷到的那些爆款餐厅,很可能此刻就出现在Explore的趋势列表中。 对于喜欢尝鲜的用户来说,这相当于一个由真实数据驱动的“本地美食热搜榜”。 ### “到店前必知”,避免踩坑 选定一家餐厅后,**Know Before You Go**标签页会汇总其他用户在Google评论中贡献的关键信息。 这个板块的实用价值在于: - **着装要求**——避免到了门口才发现穿得不对 - **菜单限制**——提前了解是否有特殊规定 - **停车情况**——这可能是最被低估的功能,尤其是在车位紧张的城市 相比翻几十条零散的评论,这个聚合视图能让用户在出发前快速掌握最关键的信息。 ### 首份“粉丝最爱”餐厅榜单 基于海量用户的评论、推荐和本地知识,Google发布了首份**粉丝最爱餐厅榜单**,覆盖全球10个城市:亚特兰大、芝加哥、伦敦、墨尔本、蒙特利尔、纽约、旧金山、圣地亚哥、西雅图和东京。 这份榜单也折射出一个更大的趋势:社交媒体正在深刻影响全球饮食潮流。当某个小吃或饮品在社交平台上走红后,它很快就会出现在你所在城市的餐厅里。 ### 这对Yelp意味着什么? Google Maps的每一步更新,都在蚕食Yelp等传统餐饮点评平台的核心场景。当用户可以在一个应用里完成发现、决策和下单的完整链路时,切换到另一个应用的理由就变得越来越少。 Yelp的困境并非孤例——它反映的是超级应用整合趋势下,垂直平台的普遍焦虑。对于用户来说,这或许意味着更便捷的体验;但对于依赖独立流量的平台而言,挑战才刚刚开始。
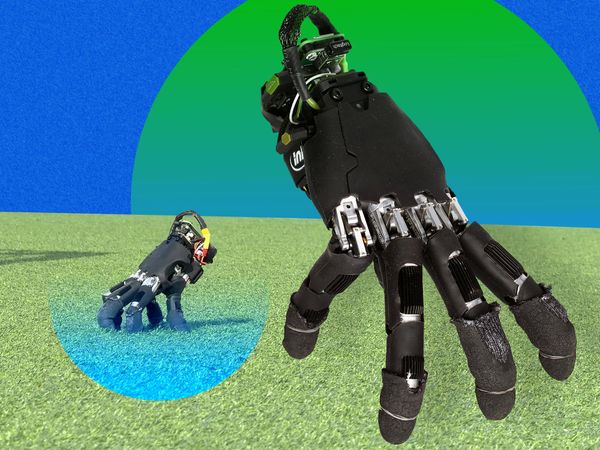
## 当机械手不再需要手臂 在大多数人的认知里,机械手只是机器人的一个末端执行器——它需要连接在机械臂上,机械臂又需要安装在移动底盘或固定基座上,才能完成有意义的工作。但苏黎世联邦理工学院(ETH Zurich)的研究团队提出了一个反直觉的设想:**如果一只手本身就能成为一台完整的机器人呢?** IEEE Spectrum 近日报道了这项研究。论文作者 Amirhossein Kazemipour、Hehui Zheng 和 Robert Katzschmann 展示了一种新思路:通过少量改造与训练,一只现成的商用机械手可以独立完成移动和操作任务,不再依赖传统的"手臂+底盘"组合。 ## 从"末端工具"到"独立个体" 这项研究的核心概念是**多用途身体部件**(multipurpose body parts)。传统机器人设计遵循层级结构:移动平台负责位移,机械臂负责定位,手部负责抓取。每一层都有明确的职责边界,但这也意味着系统复杂、成本高昂、灵活性受限。 研究团队的方案则打破了这种层级。他们让机械手直接承担移动功能——通过手指的协调动作实现爬行、翻滚或跳跃式位移,同时保留抓取和操作能力。这意味着同一套硬件既可以是"腿",也可以是"手"。 这种设计理念背后有一个关键洞察:**在特定场景下,机器人不需要像人类那样拥有完整的身体结构**。如果任务环境相对简单,一只具备移动和操作能力的机械手可能比一台完整的人形机器人更实用、更经济。 ## 技术实现的关键挑战 要让一只机械手独立移动,研究团队需要解决几个核心问题: - **运动控制**:手指关节的自由度原本是为精细抓取设计的,现在需要重新规划用于产生位移的协调动作模式 - **稳定性**:脱离固定基座后,机械手需要在不平坦表面上保持平衡,这对实时控制提出了更高要求 - **任务切换**:同一硬件如何在移动模式和操作模式之间平滑过渡,是系统设计的关键难点 团队通过对现成硬件进行"少量修改"并配合训练来解决这些问题。虽然报道未披露具体的算法细节和实验数据,但这一方向本身已经足够引人注目。 ## 为什么这很重要 这项研究的意义不仅在于技术本身,更在于它对机器人设计范式的挑战。当前机器人行业正朝着两个方向发展:一是通用人形机器人,追求形态上的类人化;二是专用机器人,针对特定任务优化。而"多用途身体部件"提供了第三条路径——**用更少的硬件完成更多的事情**。 对于搜索救援、太空探索、危险环境作业等场景,这种设计尤其有吸引力。在这些环境中,部署一台完整机器人可能成本过高或风险过大,而一只能够自主移动并执行操作的机械手,或许是一种更务实的解决方案。 当然,从实验室演示到实际部署还有很长的路。机械手的移动效率、续航能力、在真实复杂环境中的鲁棒性,都是需要进一步验证的问题。但至少,这项研究让我们重新思考了一个基本问题:**机器人的边界,究竟应该由形态决定,还是由能力决定?**
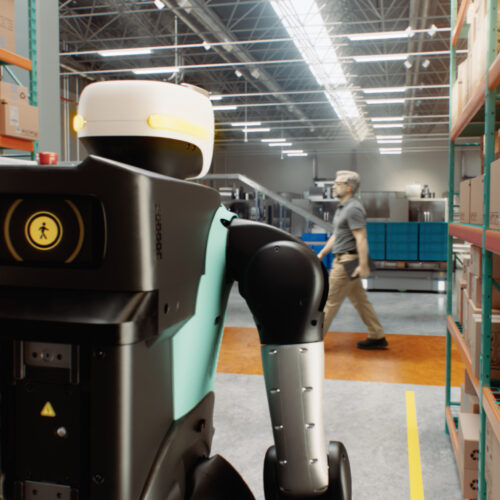
英伟达正在将其在人工智能领域的野心从数字世界扩展到物理世界。该公司近日宣布,其面向物理AI的全栈安全解决方案已被多家机器人公司采用,旨在让机器人出租车和人形机器人在现实环境中更安全地运行。这标志着英伟达在自动驾驶和机器人领域的一次关键战略布局。 ## 从虚拟到现实:物理AI的安全挑战 物理AI指的是在现实世界中感知、决策和行动的AI系统,例如自动驾驶汽车和人形机器人。与数字AI不同,物理AI的任何失误都可能造成人身伤害或财产损失,因此安全至关重要。英伟达的全栈解决方案涵盖了从芯片、传感器到算法和仿真测试的各个环节,试图为机器人制造商提供一个可靠的安全框架。 ## 全栈安全方案包含什么? 虽然细节未完全披露,但英伟达的解决方案很可能整合了其**DRIVE**平台(用于自动驾驶)和**Isaac**平台(用于机器人),并利用**Omniverse**进行高保真仿真测试。通过仿真,开发者可以在虚拟环境中模拟极端场景,验证系统的安全性,从而加速落地进程。 ## 谁在使用? 据英伟达透露,该方案已被多家机器人公司采用,但未具体点名。这可能包括自动驾驶出租车开发商和人形机器人初创企业。英伟达的GPU和AI计算平台已成为许多此类公司的首选,此次安全方案的推出进一步巩固了其生态地位。 ## 行业背景与影响 近年来,自动驾驶和机器人行业经历了从狂热到理性的转变,安全性和可靠性成为商业化的关键瓶颈。英伟达此举旨在解决行业痛点,同时扩大其在物理AI市场的影响力。随着特斯拉、Waymo等公司在自动驾驶领域的推进,以及Figure、特斯拉Optimus等人形机器人的兴起,物理AI的安全标准将日益重要。英伟达若能在这一领域建立事实标准,其增长空间将不可限量。 ## 挑战与不确定性 然而,物理AI的安全并非单靠一家公司就能解决。它需要跨行业合作、监管认可和长期验证。英伟达的方案能否成为行业通用标准,尚待观察。此外,地缘政治因素可能影响其全球推广。 无论如何,英伟达的这次押注反映了AI从云端走向边缘、从虚拟走向现实的大趋势。物理AI的时代正在加速到来。
曾以纪录片《社交困境》掀起反屏幕成瘾浪潮的**人道技术中心**(Center for Humane Technology,CHT),如今正经历一场剧烈的战略收缩。据 WIRED 报道,该组织将裁掉 16 名非创始人员工中的约一半,并终止其政策研究与诉讼支持工作,转而聚焦所谓“创始人主导”的项目。 ## 从巅峰到收缩 CHT 由前谷歌产品经理 **Tristan Harris** 联合创立,以揭露社交媒体平台如何刻意设计成瘾机制而闻名。就在裁员消息传出的不久前,该组织还在一系列针对社交媒体公司的法庭诉讼中取得重大胜利——这些诉讼正是基于其研究成果,指控平台故意让孩子沉迷屏幕。 然而,胜利的背后是多年的内部张力。据 16 名前员工透露,组织内部对于发展方向一直存在争论。董事会最终认定,同时扮演由 Harris 领衔的倡导团体和产出政策报告的智库,让组织**战线拉得过长**。 ## 谁离开,什么被砍掉 即将离职的九人包括执行董事 **Julie Guirado** 和高级战略总监 **Camille Carlton**。被裁撤的职能涵盖协助诉讼和评估 AI 工具等。董事会表示,未来将专注于**公众教育、针对性简报和私下协调**等由创始人亲自牵头的活动,发挥他们“接触广泛受众和影响关键决策者”的优势。 董事会主席 **Premal Shah** 在声明中称:“当前 AI 风险加速的时刻,要求我们聚焦于一种战略。我们选择了我们一直最擅长的事,以应对这个时刻。” ## 与 AI 风险赛跑 近年来,Harris 已加入对先进 AI 风险的警告阵营,他警告说,如果软件脱离控制,可能出现“AI 接管”。上个月他对 NBC 新闻表示:“我们必须现在就行动,否则就太晚了。”CHT 曾鼓励人们签署暂停 AI 开发的重要请愿书,协助组织国会关于聊天机器人危险的听证会,并为针对 AI 实验室设计选择的诉讼和调查提供建议,包括一起由家长对 OpenAI 提起的 ongoing 案件。 这次重组折射出非营利倡导组织在资源有限时面临的经典困境:是广泛布局,还是集中火力?CHT 选择了后者,但代价是失去近半团队成员和部分核心工作。在 AI 风险日益紧迫的背景下,这一转向能否让 Harris 及其团队更有效地影响政策与公众,仍有待观察。
## 微软把「AI PC」的天花板又抬高了 微软周三在旧金山举办了一场展示活动,**Satya Nadella** 与 **Nvidia CEO 黄仁勋**同台出席,正式公布了 **Surface Laptop Ultra** 的发售信息:**10 月 18 日上市,起售价 2599 美元**,而最高配置的价格会一路攀升到 **6000 美元**。 这个价格显然不是给普通办公用户准备的。 ### 一台为 AI 重度用户打造的机器 Surface Laptop Ultra 最早在今年台北 **Computex** 上亮相,核心卖点是搭载 Nvidia 全新的 **RTX Spark 处理器**,在 ARM 架构上运行 Windows,并支持最高 **128GB 统一内存**。机身采用高端铝合金材质,整体定位是「AI 生产力旗舰」。 从硬件细节看,它并不只是堆料: - **15 英寸 HDR 屏幕,峰值亮度 2000 尼特** - 大面积**触觉反馈触控板** - 几乎不可见的散热开孔与圆润边缘设计 - 名为 **「magnetic connect」的磁吸 USB-C 充电口**,充电器可自动吸附到位 ZDNET 的评价是:它看起来像 Surface,但手感像是 Surface 系列的下一阶段进化。 ### 六款 RTX Spark 笔记本集体登场 Surface Laptop Ultra 并不是孤军作战。同场还展出了来自 **Asus、Dell、HP、Lenovo、MSI** 的五款 RTX Spark 笔记本,配置同样高端:OLED 屏幕、触觉反馈、最高 128GB 统一内存,价格也都处于同一高位区间。 不过,Surface Laptop Ultra 显然是这场秀的主角——它拥有专属的宣传片和现场演示环节。 这些设备的目标人群很明确:**AI 重度用户、创作者和开发者**。它们能跑游戏,但官方并不把它们定位为游戏本。现场演示的是 **Blender、ComfyUI、Photoshop** 中的复杂工作流,以及此前只能跑在云端的大型本地模型。 ### 微软想讲的故事:Windows 的「混合智能」 把 Surface Laptop Ultra 放在 RTX Spark 阵营的领导位置,是微软的一次叙事布局——它想借此掌控「下一代高性能 Windows 设备」的定义权。 大内存不只是为了今天的「前沿」任务,更是为未来工作流做准备。微软强调的方向是 Windows 的 **「混合智能」(hybrid intelligence)**,目标是让云端与本地的切换更加无缝。 换句话说,这批设备是面向未来的第一代「AI 优先」笔记本,而 Surface Laptop Ultra 是微软给出的样板。 ### 值得注意的问题 价格是这台机器最直接的争议点。**2599 美元起步、6000 美元封顶**,已经进入专业工作站的价格区间。微软显然在赌:愿意为本地大模型推理和 AI 工作流付费的专业用户,会接受这个溢价。 至于这个赌注是否成立,10 月 18 日上市后的市场反应会给出答案。
## 当意识不再是优化目标,而是一种架构属性 长期以来,AI 领域对"意识"的讨论要么停留在哲学思辨,要么被简化为某个可优化的目标函数。但一篇来自 arXiv 的最新基础性论文(arXiv:2610.08792)提出了一个截然不同的视角:**意识或许不是系统"学会"的东西,而是特定循环结构自然具备的架构属性**。 这篇由 Eduardo Righi Capanema de Almeida 撰写的论文,提出了**贝叶斯镜像架构(Bayesian Mirror Architecture, BMA)**——一个自指涉的生成式框架。它的核心思想并不复杂:让感官抽象、元抽象与一个"自我隐变量"通过循环递归相互作用,形成一个闭环。 ### 闭环更新:BMA 的定义性约束 BMA 最关键的约束是一个看似简洁的闭环更新: > **S_t ← H_{t-1}** 这里的 **H_t** 是一个"混合事件-自我隐变量",它的作用是把自我表征与抽象世界模型绑定在一起,并将这种耦合重新注入自我状态。换句话说,系统不是单向地"感知世界",而是不断地把"自己如何看待世界"这一信息反馈回"自己是谁"的建模中。 论文明确指出,在这种受限意义上,意识**既不是优化目标,也不是语义标签**,而是拥有这种循环结构的系统所具备的架构属性。这是一个值得注意的立场转变:它把意识从"结果"重新定位为"结构"。 ### 用最优传输几何刻画自我稳定性 由于 BMA 的推理是在后验信念上进行的,它的内在状态空间本质上是**配备了最优传输几何的概率测度空间**。这意味着,系统的稳定性和连贯性可以用 **2-Wasserstein 度量**在 P_2 空间上形式化,从而得到无需坐标系的"自我稳定性"与"混合连贯性"概念。 论文进一步定义了**因果学习机制(Causal Learning Regime, CLR)**,通过 Wasserstein 信念漂移的边界和一个整合指数来刻画自我隐变量与世界隐变量之间的持续耦合。需要强调的是,CLR 诊断的是"环境是否包含可学习的因果结构",**它本身并不是意识的标志**。 ### 多盆地、瓶颈与"选择" BMA 并不要求全局严格收缩性——它可能表现出**多个连贯的盆地**。论文按盆地定义了"自流形",即局部 Wasserstein 收缩性下不变测度的支撑集。同时,作者识别出 **Wasserstein ε-瓶颈**:这些是传输瓶颈,盆地在此解耦,并在消失电导极限下产生唯一的实现延续。作者将这种选择解释为"选择"——**内部决定,但在有限分辨率下外部不可预测**。 学习过程则通过**变分自由能最小化**进行,稳定性与能动性从"环境允许学习到什么"中涌现。 ### 这意味着什么? 这篇 15 页、无图表的基础性论文,其价值不在于给出可立即工程化的方案,而在于提供了一套**数学上自洽的语言**,用来讨论机器意识这一长期被模糊处理的话题。它把意识从"能力"问题转化为"几何与动力学"问题——这或许能为未来 AI 架构设计提供一条不同于规模扩张的思路。 当然,这仍是一篇理论构建阶段的论文,其核心概念(如 CLR、自流形、ε-瓶颈)尚需后续工作验证其可操作性与实证意义。
## 一项用机器学习拆解正念疗效的研究 正念干预对抑郁症状的改善效果,早已不是新鲜话题。但一个更实际的问题长期缺乏清晰答案:**同样的干预方案,为什么有人改善明显,有人却收效甚微?** 近期发表于 arXiv 的一篇论文(arXiv:2610.08809)尝试用可解释机器学习回答这个问题。 研究团队基于一个**多中心纵向临床队列**,追踪慢性或急性躯体疾病患者的抑郁状况。他们以 **BDI-II(贝克抑郁量表第二版)** 评分作为预测目标,分别建模干预后 **12 周**和 **24 周**的抑郁结果。输入变量覆盖人口学特征、临床疾病信息、医院中心标识、基线 BDI-II 评分,以及患者对正念治疗的参与度指标。 ### 方法:小样本下的稳健建模 由于随访存在缺失,研究者采用**基于模型的随机插补**处理缺失结果,在样本量有限的前提下尽量保留结果变量的变异性。随后他们评估了五类回归模型,涵盖正则化线性回归与树集成方法。 结果呈现出有趣的“分工”: - **12 周短期预测**:Ridge 回归表现最佳,RMSE 为 **5.186**,R² 为 **0.474**; - **24 周长期预测**:LightGBM 表现最佳,RMSE 为 **5.038**,R² 为 **0.525**。 ### 三个值得注意的临床规律 比预测精度更有价值的,是模型揭示的变量重要性模式: 1. **基线严重程度仍是最强预测因子**。无论短期还是长期,初始抑郁水平都主导着后续走向,这一点符合直觉。 2. **短期结果更依赖临床与医院情境**。疾病类型、就诊中心等背景因素在 12 周时影响更突出——这意味着早期改善可能部分反映的是照护环境差异,而非干预本身的独立作用。 3. **长期结果更依赖行为依从性与人口学因素**。到了 24 周,患者是否坚持练习、参与度高低,以及个人特征,开始取代情境变量成为关键。 研究还进行了**疾病特异性与分层亚组分析**,发现预测因子在不同临床类别之间、乃至同一类别内部都存在显著差异。换句话说,不存在一套对所有患者都通用的疗效预测模型。 ### 意义与边界 这项工作的方法论价值在于:它把“正念干预有没有效”这个大问题,拆解成了“**对谁、在什么阶段、由什么因素驱动**”的可操作问题,并主张用**可解释、情境感知的建模**来支持个性化心理健康服务。 需要保持谨慎的是,该研究样本量被作者自己描述为“modest(有限)”,缺失数据依赖插补,且 R² 处于中等水平,说明抑郁结果仍有大量未被模型捕捉的方差。这些预测因子应被理解为关联模式,而非因果结论。对于希望把 AI 用于心理健康精准干预的团队来说,这篇论文提供了一个值得参考的框架,但距离临床落地仍有距离。
## 地理基础模型在真实农田中的表现究竟如何? 一项新研究对广泛使用的地理空间基础模型 **Prithvi-EO-2.0** 进行了迄今规模最大的分布外性能评估,覆盖三大洲 **12 个国家、37 个事件**。结论并不乐观:模型在美国的**平均总体精度(OA)为 0.65**,到欧洲却骤降至 **0.40**。 ### 精度下降背后:物候错位是主因 研究者发现,精度崩塌往往发生在**观测窗口与当地作物物候不匹配**时。更棘手的是,模型此时**确定性置信度依然很高**——这意味着它可能在“自信地犯错”。 - **预期校准误差**在 8 组配对事件中有 7 组上升; - 每个受影响场景中,**12%–51% 的区域被以近零精度自信地错误标注**; - **蒙特卡洛 dropout 熵**在全部 8 组事件中均捕捉到了这种偏移,表明跨大陆精度下降更多反映**物候错位**,而非单纯的空间迁移失败。 ### 两项无需重训的补救措施 研究同时给出了可操作的调整方案: 1. **合并类别**:基于模型的主要混淆模式,将 13 类作物合并为 10 类,**平均 OA 提升 8.4 个百分点**。 2. **压缩观测窗口**:在 **45 至 90 天**的区间内精度可保持稳定,**约 75 天达到峰值**;但窗口窄于 30 天时,精度会再下降约 0.11。 ### 对行业意味着什么 这项研究为地理空间基础模型的落地敲响警钟:**微调后的模型只有在观测窗口匹配当地生长季时才能有效迁移**。对于依赖卫星影像进行作物监测的农业科技公司、保险机构和政府项目而言,这意味着不能盲目将北美训练的模型直接部署到欧洲或其它地区。 论文还评估了模型对**波段丢失**以及**云和阴影污染**的鲁棒性,进一步揭示了运行环境中的潜在风险。该研究提醒业界,在将 GeoFM 投入业务化运行前,必须进行本地化的物候校准和不确定性验证。
## 一个被忽视的结构性盲区 随着大模型上下文窗口从几千扩展到十万甚至百万 token,**KV 缓存压缩**已经成为高效推理的刚需技术。目前主流方案可以归为三大流派:基于分数的淘汰(score-based eviction)、摘要补偿(summary compensation)以及卸载-召回(offload-and-recall)。 但 arXiv 新论文 **KVFetch** 指出了一个共同缺陷:这三类方法在决定"保留什么、召回什么"时,**全部依赖内容与当前 query 的相关性**。作者认为,这种设计在结构上是不完整的。 ## 缓存有两种访问模式,现有方法只实现了一种 论文的核心洞察是:缓存天然支持两种访问方式—— - **按内容进行关联查找**(associative lookup) - **按位置进行顺序遍历**(sequential traversal) 现有的 KV 压缩器几乎只实现了第一种。 这个缺口在真实场景中代价很高:**检索增强生成(RAG)、代码补全、结构化数据抽取**等任务,都要求模型从上下文中逐字复现标识符、字段值或代码 token。而基于内容的淘汰策略会保留这类序列的"开头",却丢弃其"续写部分",导致逐字复制在中途不可逆地断裂。作者将这种失败命名为 **sequential forgetting(顺序遗忘)**。 关键在于,这种失败**无法通过更好的打分函数、更大的预算、摘要补偿或动态重打分来修复**——它是压缩后剩余质量损失的主要来源。 ## KVFetch 怎么做 论文提出的 **KVFetch** 是一个免训练、即插即用的框架,为任意基于分数的压缩器打开一条**时间召回通道**: 1. 将被淘汰的候选降级到**量化冷层**; 2. 通过一个**单调读指针**检测模型是否正在主动复制; 3. 将位置上的后继 token **预取**到固定大小的热层槽位中,且**不增加注意力计算开销**。 ## 实验结果 - 在 **RULER-16K** 的等预算对照下,KVFetch 将逐字复制能力从 **0.8 恢复到 78.4**,13 项任务平均提升 **+8.4**,增益集中在需要顺序访问的任务上。 - 在 **LongBench** 上,由于没有任务需要顺序访问,该通道保持休眠,**不带来任何额外成本**。 论文共 21 页、7 张图,已投稿至 ICLR 2027。 ## 为什么值得关注 KVFetch 的价值不只是一项工程优化,而是提醒社区:**KV 缓存压缩的评测与设计长期偏向了"相关性"这一单一维度**。当应用越来越依赖长上下文中的精确复制(代码、ID、结构化字段)时,补齐"位置/顺序"这条通道,可能比继续堆叠打分策略更有效。
当AI智能体从聊天窗口走进工厂产线、电网调度和医疗决策,一个棘手的问题浮出水面:仅靠概率推理,系统真的可以安全部署吗? 来自arXiv的一篇新论文《Bounded Autonomy and Verifiable Safety for Agentic AI Enabled Automation》给出了一个系统性的回答。作者Srini Ramaswamy与Deveeshree Nayak提出了一套名为**BRaVeS**的边界推理与安全治理框架,试图在"让智能体自主行动"与"确保行为可验证"之间找到平衡点。 ## 核心问题:认知漂移 论文指出了一个被忽视的风险——**认知漂移(epistemic drift)**。简单来说,当AI的推理链条越拉越长、越挖越深时,它的行为可能逐渐偏离领域专家设定的安全约束。这不是模型"故意"违规,而是概率推理在长链条中自然产生的偏移。 在核电站监控、自动驾驶或工业控制这类场景中,这种漂移的代价可能是灾难性的。 ## BRaVeS的四个支柱 BRaVeS框架包含几个相互配合的机制: - **不变锚点(invariant anchors)**:将领域专家定义的安全约束编码为推理过程中始终可见的"锚",防止关键规则在深层推理中被稀释。 - **MoDA风格深度感知访问**:借鉴Mixture of Depths Attention的思路,让模型在不同推理深度下都能访问这些锚点。 - **SMARtAutonomy状态层级**:随着认知风险升高,系统会**主动降低自主性**,而非一味追求全自动。 - **Lyapunov有界共识框架(LBCF)**:将连续的认知风险信号映射为有限的K-bag抽象,并通过"屏蔽状态转移"强制系统能量下降,或在必要时将控制权交给人类。 ## 验证与边界 研究团队使用HAI 22.04工业控制系统的时间序列数据,加入合成噪声和传感器退化场景,通过离散事件蒙特卡洛仿真进行测试。结果显示,LBCF过程实现了**有限步收敛**,且未出现安全护栏违规。 但作者也明确划定了结论的边界:形式化收敛结果仅适用于固定阈值和可行屏蔽假设下的有限LBCF抽象,**并不证明完整连续神经激活空间的安全性**。未来工作包括在真实Transformer部署上验证、引入实时人类在环测试,以及应对更复杂的对抗性环境。 这篇论文已被《Journal of Intelligent and Robotic Systems》接收。它传递的信号很清晰:智能体AI要进入高风险领域,需要的不仅是更强的推理能力,更是一套能在推理过程中持续生效、且可被形式化验证的安全治理机制。
## 长记忆的代价:序列模型的状态、上下文与稳定性复杂度 **arXiv:2610.08816** 最新论文《The Cost of Long Memory: State, Context, and Stability Complexity in Sequence Models》直接切入序列模型的一个核心资源问题:给定一个预测记忆律,模型需要多少**状态、上下文或动力学临界性**才能准确预测? ### 核心发现:记忆越强,代价呈平方对数增长 论文针对**代数衰减的预测记忆**(即长程依赖按幂律衰减)证明: - 对于指数模式和有限状态模式,最优 **r-模式预测误差**以 **e^{-Θ(√r)}** 衰减; - 因此,要将预测误差降到 **τ**,所需状态或模式数为 **r = Θ(log²(1/τ))**。 这意味着,**长记忆的代价是状态数的平方对数增长**。此前“记忆诅咒”类结果已表明稳定循环模型的广泛局限,而这项研究在预测风险框架下证明上下界匹配,从而**确定了该目标下的最优资源指数**。 ### 分数长记忆改变几何结构 论文进一步揭示,真正的**分数长记忆**会改变预测几何本身: - 预测误差在分数积分后度量; - 从长度 **L** 的有限上下文预测,领先阶恰为 **1/L**; - 固定分数强度 **d** 下,状态复杂度仍遵循**平方对数律**; - 在短记忆边界附近,作者识别出 **d²** 和 **d⁴** 尺度,并给出中间区域的一致构造律。 ### 非线性循环与稳定性 对于**均匀收缩状态动力学**的非线性上下文循环,论文推导出**指数第一混沌包络**,并给出将预测精度与收缩裕度关联的显式必要条件。特别地,**在代数目标上实现零预测误差,会迫使循环定量地趋向临界性**——这是必要条件,但并非充分条件。有限样本的 **KL 散度**计算进一步将预测几何与统计信息联系起来。 ### 实验验证 作者用**收缩状态空间模型、门控循环网络和注意力模型**进行定理匹配实验,结果复现了状态与稳定性的预测。 ### 启示 这项研究为理解 Transformer、RNN 等序列架构的**记忆容量与稳定性权衡**提供了理论标尺:长程依赖不是免费的,模型必须付出状态数或临界性代价。对于设计长上下文模型、优化记忆机制的研究者和工程师,这提供了可量化的资源下界。
## 一句话总结 华中科技大学团队提出 **DenoFlow**,把 SSVEP 脑电去噪重新定义为「传输问题」——用整流流(rectified flow)让模型从受污染信号出发、沿直线路径积分回干净信号,并在训练中引入分类器监督,确保去噪结果仍然「可解码」。在**两个公开 SSVEP 数据集**、**五种主流解码器**上,它同时赢下了信号保真度与下游解码准确率两项指标。 ## 问题:去噪做得好,不等于解码解得出 基于脑电(EEG)的脑机接口,尤其是**稳态视觉诱发电位(SSVEP)**系统,对噪声和生理伪迹极其敏感。眼动、眨眼、肌肉活动带来的 EOG/EMG 干扰,会直接拉低解码准确率。 近年来不少深度去噪方法看似有效,但论文指出了三个共性缺陷: - **没有配对真值**:真实脑电数据拿不到「干净版」,模型只能靠无监督方式拟合; - **容易退化成恒等映射**:网络可能直接复制输入,看起来「去噪」了,其实什么都没做; - **只优化波形距离**:波形接近干净信号,并不代表输出还能被解码器正确识别。 换句话说,过去的评价标准与脑机接口真正关心的目标之间存在错位。 ## 方法:把去噪当作「传输」而非「映射」 DenoFlow 的核心思路是:不去学一个从「脏信号 → 干净信号」的直接映射,而是学习两者之间**直线路径的速度场**,遵循 **rectified-flow** 的表述,去噪时从观测信号出发、沿该场向前积分。 几个关键设计值得注意: - 场网络是一个**编码器-解码器**结构,每一层都能看到受污染的信号,瓶颈处则接收路径位置信息; - 训练时**并行训练一个分类器**,直接监督积分后的输出,把「是否可解码」写进优化目标; - 由于观测信号既是条件输入、又是积分起点,模型**从噪声生成信号**这一步被彻底绕开,训练退化为纯回归,**去掉了对抗式 min-max 博弈**。 ## 数据:用真实生理伪迹「人工造脏」 没有配对真值是脑电去噪的老大难。作者的做法是:记录真实的 **EMG(肌电)** 与 **EOG(眼电)** 信号,在受控信噪比目标下注入干净试次,从而构造出带有真实生理特征的配对数据。这比合成高斯噪声更接近实际使用场景。 ## 结果与意义 在两个公开 SSVEP 数据集上,面对五种常用 SSVEP 解码器,DenoFlow 在**信号保真度**和**下游解码准确率**上都超过了 **7 个基线去噪模型**。 对脑机接口领域而言,这项工作的价值不只是刷了一个指标,而是提示了一个方向:**去噪模型的目标函数应当与下游任务对齐**。当去噪器只对波形负责时,它可能悄悄破坏了解码器依赖的判别性特征;而把分类器拉进训练回路,等于给去噪加了一道「任务保真」的约束。代码已开源。
**时空预测**一直是物流调度、城市规划与智能交通系统的底层支撑技术。但现实中的传感器网络受限于部署成本与维护资源,很难做到空间上的全覆盖——大量区域根本没有历史观测数据,这让**未观测节点状态预测(FUNS)**成为一个棘手难题。传统模型依赖历史序列,遇到"零记录"节点时往往直接失效。 针对这一痛点,来自相关研究团队的最新论文 **《Just for FUNS: LLM-Guided Spatio-Temporal Graph Node Generation for Forecasting Unobserved Node States》**(arXiv:2610.08818)提出了一种全新思路:把问题重新定义为**时空图上的条件生成任务**,并给出框架 **GenST**。 ## 用大模型当"语义桥梁" GenST 的核心创新在于引入**大语言模型作为语义桥接器**。研究团队对一个预训练 LLM 进行微调,使其能够从节点描述中提取丰富的语义特征——例如该区域属于什么**功能区**、**路网结构**如何。这些语义信息被用来补偿缺失的时空信号,让模型在完全没有历史观测的情况下也能"推理"出节点的未来状态。 ## 两阶段生成架构 技术实现上,GenST 采用两阶段生成式设计: - **第一阶段:时空 VAE**。将复杂的时空动态压缩到潜在空间,学习其低维表示; - **第二阶段:生成式 Transformer(GenT)**。以噪声为起点,在**多模态条件**(语义、地理坐标、邻域上下文)的引导下,重建未观测节点的未来状态。 这种"先压缩、再生成"的范式,本质上是用生成模型替代传统的回归预测,从而绕开"必须依赖历史观测"这一硬约束。 ## 实验表现 论文在**六个交通数据集**和**两个非交通数据集**上进行了验证。结果显示,在**零样本预测任务**中,GenST 显著优于现有基线方法。这意味着即便目标节点从未产生过任何数据,模型仍能给出有参考价值的预测。 ## 为什么值得关注 这项工作的价值不仅在于单一任务的性能提升,更在于它展示了一条缓解**时空数据稀疏性**的新路径:**用语义知识补位数值观测**。对于智慧城市建设、交通流量推演、应急场景下的传感器缺失补偿等应用,这种"语义引导生成"的思路具备相当的实用潜力。 当然,LLM 提取的语义特征质量高度依赖节点描述的完备程度,这在实际部署中可能成为新的约束条件。后续研究如何降低对文本描述质量的依赖,值得持续观察。
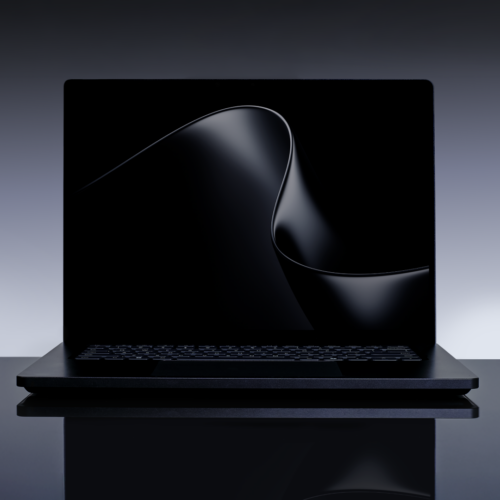
微软在近日的硬件发布会上推出了一系列面向AI的新硬件,并对Windows系统进行了深度AI化改造。此举标志着微软正加速将AI从云端推向本地设备,试图在苹果、谷歌等对手的竞争中确立优势。 ## 硬件:为AI而生的新设备 微软发布了新一代Surface设备,包括Surface Pro和Surface Laptop。这些设备搭载了专为AI任务设计的**神经处理单元(NPU)**,能够本地运行复杂的AI模型,如实时翻译、图像生成和语音助手。NPU的加入不仅提升了性能,还增强了隐私保护,因为数据处理无需上传云端。 此外,微软可能还推出了其他AI友好配件,例如智能摄像头或音频设备,但具体细节尚未完全披露。 ## Windows:系统级AI集成 Windows 11将迎来重大更新,深度集成AI功能。最引人注目的是**Windows Copilot**,它将成为系统级的AI助手,能够帮助用户完成各种任务,如总结文档、调整设置、生成内容等。Copilot将出现在任务栏中,随时待命。 其他AI功能包括: - **AI增强的搜索**:通过自然语言查询快速找到文件或设置。 - **实时字幕和翻译**:在视频会议或观看视频时提供实时字幕和翻译。 - **AI驱动的照片编辑**:一键增强照片或生成艺术效果。 这些功能将逐步推送,部分需要NPU支持。 ## 战略意图:AI PC时代的卡位战 微软此举旨在推动“AI PC”概念,将PC重新定义为智能个人助手。通过硬件与软件的协同,微软希望引领新一轮PC升级周期,同时与苹果的M系列芯片和谷歌的AI集成竞争。 分析师认为,微软的AI PC战略可能刺激企业换机需求,但消费者是否买单尚待观察。此外,隐私和能耗问题也是潜在挑战。 ## 小结 微软的发布会展示了其AI雄心:从芯片到系统,全面拥抱AI。随着AI PC浪潮来袭,Windows生态将迎来新的变革。
## 一场大胆的宣言 “软件已死”(Software is over)——这是某位AI开发者向Adobe发出的挑战书。近日,一位开发者利用AI模型**Opus**构建了一系列开源创意工具,旨在克隆Adobe Creative Cloud的核心功能。这些工具免费、开源,但远未完成,却已展现出AI对传统软件巨头的潜在冲击。 ## 开源克隆:理想丰满,现实骨感 据Ars Technica报道,这些开源替代品覆盖了图像编辑、视频剪辑等Adobe主力产品的功能。开发者声称,借助AI编程助手,他能够快速生成代码框架,大幅缩短开发周期。然而,这些工具目前仍处于早期阶段,功能残缺,稳定性不足,距离“可用”尚有距离。 ### 为什么值得关注? - **AI降低开发门槛**:过去,克隆Photoshop这样的软件需要数百人年的工程投入,如今AI辅助编程让个人开发者也能挑战巨头。 - **开源与免费的诱惑**:Adobe的订阅制价格不菲,免费开源方案对预算有限的创作者极具吸引力。 - **象征意义大于实用**:尽管工具尚不完善,但它传递了一个信号——AI可能重塑软件行业的竞争格局。 ## Adobe的护城河还稳固吗? Adobe深耕创意软件数十年,拥有庞大的用户生态、格式标准和工作流集成。开源克隆短期内难以撼动其地位,尤其是在专业领域。但长期来看,如果AI持续降低开发门槛,Adobe的高价订阅模式可能面临压力。 ### 挑战与不确定性 - **完成度低**:这些克隆工具目前只是原型,缺乏关键功能,无法满足专业需求。 - **维护难题**:开源项目依赖社区贡献,能否持续迭代仍是未知数。 - **法律风险**:克隆商业软件可能涉及专利和版权问题,尽管开源社区通常规避直接复制代码。 ## 结语:软件的未来是AI生成的吗? “软件已死”或许言过其实,但AI正在改变软件的构建方式。这位开发者的尝试更像是一次概念验证:当AI能快速生成代码,传统软件公司的壁垒还能维持多久?对于Adobe而言,真正的威胁或许不是这些粗糙的克隆,而是AI催生的全新创作范式。
## 管理者正在用AI写绩效评估,但员工买账吗? 一项新调查显示,**78%的管理者**在过去一年中借助AI起草、编辑或总结绩效反馈,但只有**16%的非管理岗员工**被告知AI参与了评估过程。当AI悄然进入职场反馈循环,它究竟在帮谁? ### 效率提升背后的透明度缺口 专业发展公司**Highwire**对**1034名企业员工**进行了调查,试图厘清AI如何渗透进管理者与员工之间的关系。结果显示,管理者使用AI准备反馈的首要动机是**提速**——这并不令人意外。但问题在于,绝大多数员工对AI的介入并不知情。 这种信息不对称可能源于一种职场顾虑:今年6月**Atlassian**的一项研究发现,公开承认在工作中使用AI反而会带来负面评价。于是,管理者选择沉默,员工则在不知情的情况下接收反馈。 ### 反馈质量:改善与退化并存 AI的介入对反馈质量的影响并非一边倒: - **54%**的员工认为反馈变得更具体、更具可操作性 - **34%**的员工觉得反馈更加泛泛而谈 - **32%**的员工表示反馈的实用性反而下降 **三分之一的员工**从绩效评估中获得的实际价值可能不如从前。即便多数人感受到了好处,这个比例也绝不容忽视。关键在于AI的使用方式:让AI格式化或总结人类撰写的观察意见,与直接把绩效数据丢给AI让它从头生成一份评估,是截然不同的干预程度。 ### 员工在自寻出路:用AI排练高难度对话 调查还发现了一个耐人寻味的趋势:**近四分之一的员工**现在会用AI工具排练职场中的困难对话。 Highwire将这一现象归因于支持缺位——只有**44%**的员工表示获得了管理者对其演练高风险对话的支持,而**85%**的员工认为这种练习至关重要。巨大的落差之下,AI成了紧张员工的替代方案。 这一需求也正在被产品化。AI视频公司**Synthesia**最新发布的**Sessions**功能,就允许用户通过AI视频模拟来练习棘手的职场场景。 ### AI是桥梁还是隔阂? AI在绩效反馈中的角色充满矛盾。它确实填补了管理者准备反馈时的效率缺口,也为缺乏支持的员工提供了练习工具。但当它替代而非辅助人类的判断时,反馈可能失去最宝贵的部分——来自真实互动的具体洞察。 对于企业而言,真正的挑战或许不在于是否使用AI,而在于**如何透明地使用**:告知员工AI的参与程度,区分AI辅助与AI主导,并确保管理者仍然投入足够的时间去观察和了解他们的团队。否则,效率的提升可能以反馈质量为代价。