
## 多环境访问 Claude 平台的统一方案 企业通常需要在多种环境中调用 **Claude Platform on AWS (CPonAWS)** 的推理能力:生产环境中的 AWS 工作负载、开发者的本地笔记本,以及运行在其他云或本地 CI/CD 管道中的外部服务。这些环境的认证需求各不相同,但理想情况下应共享同一个订阅,并在生产与开发流量之间实现工作区级别的隔离。 AWS 近期发布的技术指南详细介绍了如何通过一个专用 **AI Services 账户** 实现上述目标。该方案的核心是三层账户结构: - **付款(管理)账户**:负责账单与治理。 - **AI Services 账户**:托管 CPonAWS 订阅、工作区、API 密钥和跨账户角色。 - **工作负载账户**:不直接接触订阅,而是通过承担角色(assume role)进入 AI Services 账户来发起推理调用。 这一设计将订阅所有权与消费方解耦,同时利用工作区实现生产与开发流量的逻辑隔离。 ## 三种访问模式的配置要点 针对不同环境,指南给出了三种认证路径: 1. **AWS 工作负载账户:跨账户 SigV4** 例如运行在 Amazon EKS 上的 Pod,通过承担 AI Services 账户中的 IAM 角色,使用 SigV4 签名发起请求。这种方式无需长期凭证,适合 AWS 原生工作负载。 2. **开发者:工作区范围的 API 密钥** 为开发者生成限定于特定工作区的 API 密钥,用于本地迭代。密钥的作用域隔离可防止开发流量误入生产工作区。 3. **外部环境:OIDC 联邦** 对于其他云或本地 CI/CD 管道,通过 OIDC 联邦将外部身份提供商与 AWS IAM 角色关联,实现无密钥的临时凭证访问。 ## 实施步骤与扩展建议 指南提供了完整的 CLI 命令、控制台操作和代码片段。部署时,首先在组织内创建专用 AI Services 账户,然后配置跨账户角色、生成工作区 API 密钥并设置 OIDC 信任关系。 对于拥有更多环境的组织,建议为每个团队或工作负载创建独立的工作区,并重复跨账户角色模式。这种模式不仅适用于 Claude 平台,也可为其他 AI 服务的多环境访问提供参考。 通过这套方案,企业可以在保持订阅统一的前提下,满足不同环境的认证需求,同时实现流量的精细隔离与治理。
Amazon Quick Sight 是 AWS 提供的全托管、云原生商业智能(BI)服务,支持在任何设备上访问仪表板,并可嵌入到应用程序、门户和网站中。在构建仪表板时,作者通常会添加多个筛选器,让读者能够缩小数据范围。但筛选器数量需要在灵活性和界面简洁性之间取得平衡:太多筛选器会显得杂乱,操作步骤也会变得繁琐。 ## 从六个筛选器到单一控件 以一个常见仪表板布局为例,其中包含六个独立筛选器:四个地理层级筛选器(**Region**、**Sub-Region**、**Country**、**City**),以及两个分别针对 **Segment** 和 **Product** 维度的筛选器。在真实场景中,筛选器数量往往更多,严重影响用户体验。 为此,Amazon Quick Sight 推出了**层级筛选器(hierarchy filter)**。它允许仪表板作者在**一个紧凑的控件**中提供丰富的多级筛选,减少界面杂乱,并引导读者以更少步骤找到所需数据。 ## 层级筛选器的核心优势 - **减少视觉杂乱**:读者首先看到的是简短的区域(Region)列表,而不是一次性展示数百个城市。每一步界面都保持干净,可见选项更少。 - **更少步骤,更引导式探索**:读者沿着逻辑路径(Region → Sub-Region → Country → City)下钻,而不是扫描一长串扁平筛选器。每次选择都会缩小下一级范围,帮助读者更快到达目标。 - **混合层级选择**:读者可以在一个筛选控件中组合不同层级,例如同时选择整个国家(如日本)和单个城市(如纽约)。 - **可扩展而不压倒界面**:支持最多**五级**的深层级结构,而无需添加五个独立筛选控件挤占工具栏。一个紧凑控件即可处理完整下钻路径。 - **防止读者混淆**:读者无需知道哪个国家属于哪个区域,层级结构已内置这种知识,使仪表板具备自引导能力。 层级筛选器通过将多级筛选整合到单一控件,显著提升了仪表板的易用性和可读性,尤其适用于地理层级、产品分类等具有天然层次结构的数据维度。
在大多数信息被隐藏的**军棋**(Stratego)游戏中,AI 一直难以达到人类水平。如今,一项新研究通过引入**第二个神经网络**来猜测隐藏棋子的身份,成功攻克了这一难题。 ## 军棋:AI 的盲点 军棋是一种双人策略棋盘游戏,与**国际象棋**或**围棋**不同,玩家无法看到对手棋子的具体类型。这种**不完美信息**使得 AI 难以通过传统的搜索和评估方法进行决策。此前,AI 在军棋上的表现远不及人类专家。 ## 双网络架构的突破 研究团队设计了一种新颖的 AI 系统,其核心是**两个神经网络**的协同工作: - **主网络**:负责评估棋盘状态和选择行动,类似于 AlphaZero 的架构。 - **辅助网络**:专门用于**猜测隐藏棋子的身份**,通过分析对手的移动模式和历史信息来推断。 辅助网络的预测结果会作为额外输入提供给主网络,从而显著提升了决策质量。 ## 实验结果与意义 在实验中,该 AI 系统在军棋对战中达到了**超越人类专家**的水平,并且能够泛化到不同的初始布局。这一成果不仅推动了**不完美信息游戏** AI 的发展,也为现实世界中信息不完全的决策问题(如军事策略、商业谈判)提供了新思路。 > 研究者表示:“关键在于让 AI 学会像人类一样,通过观察和推理来填补信息缺口。” 未来,团队计划将这一方法扩展到其他类似游戏和实际应用场景中。
在零售平台的内容审核中,通用模型往往难以直接满足企业特定的业务规则。台湾统一企业集团旗下的数字平台 **uniopen** 就面临这样的挑战:其审核政策需要同时判断用户行为的九个类别和指向的三种主题(品牌、其他、禁止),两者都正确才能做出有效决策。 为了将 **Amazon Nova 2 Lite** 适配到这些业务特定政策,uniopen 团队采用了 **Amazon SageMaker AI** 中的监督微调,并结合提示级别的输出优化。整个方案将修正数据、托管训练、评估和部署控制整合到一个可重复的工作流中,确保质量可控。 ### 审核政策的特殊性 uniopen 是一个连接电商、会员权益等零售体验的数字通信和会员平台,覆盖网页、平板和移动端。其审核政策要求对每次交互从两个维度分类: - **行为类别**:共九种,描述发生了什么行为; - **主题类别**:品牌、其他或禁止,描述行为指向的对象。 这两个维度都必须正确,审核决策才有用。而且这些类别是 uniopen 业务特有的,通用模型无法开箱即用。 ### 技术方案:分离生产与训练路径 架构将生产审核路径与修正、训练、评估和部署分开: - **生产审核**:由 Amazon Nova 2 Lite 处理主要审核请求。 - **修正生成**:Amazon Nova 2 Pro 为报告的错误生成候选修正,但必须经过人工审核才能进入训练集。这种分离确保生成的标签不被当作绝对真理,从而安全地改进领域特定行为。 - **数据存储**:Amazon S3 存储验证后的修正集和训练数据;Amazon DynamoDB 跟踪活跃和候选模型配置。 - **编排与部署**:Argo Workflows on Amazon EKS 编排提示优化、评估和部署;Argo CD 将批准的配置应用到生产。 - **监控与告警**:Amazon SNS 和 Amazon CloudWatch 在硬性门槛失败或候选需要关注时通知操作员。 ### 评估与发布门槛 团队设置了业务相关的评估指标和发布门槛,确保模型质量。通过监督微调和提示优化,模型学会了 uniopen 特有的审核政策,同时保持了可重复的工作流和人工监督。 这一案例展示了如何利用 AWS 的托管服务,将通用大模型定制为符合企业特定政策的生产系统,为零售行业的 AI 审核提供了参考。
Airbnb 本周随秋季更新推出了全新的 AI 搜索功能,这是这家在 AI 上一直谨慎慢行的公司迈出的重要一步。联合创始人兼 CEO **布莱恩·切斯基**(Brian Chesky)此前曾表示,纯聊天机器人界面不适合旅行发现。随着更多 AI 功能即将进入 Airbnb 应用,我在 Zoom 上采访了切斯基,聊了聊公司如何推进 AI、界面将走向何方、消费级 AI 为何仍未奏效,以及语音将扮演什么角色。 ## 聊天机器人不是电商的正确答案 切斯基对聊天机器人的看法没有改变。他认为,聊天机器人不适合浏览或购物,因为它们一次只给你几个选项,你得来回多轮才能得到结果。但他也不认为 Airbnb 当前版本的搜索就是最终形态——界面会随时间演变。 “我长期以来一直认为,聊天机器人不是电商的正确界面。你今天看到的也不是电商、旅行或购物的终局。我认为会出现某种界面,我不想称之为中间点,而是介于聊天机器人和我们发布的第一版之间的某种东西。” 他进一步解释:很多用户希望有些事情快而简单,比如“帮我订张机票,我不想看”。但在 Airbnb 上,用户享受浏览产品。旅行研究表明,人们在规划和期待旅行时获得的愉悦感,其实比旅行本身更多。所以你不应该把灵感、浏览和梦想的图书馆体验拿走。 ## 聊天机器人的第二个问题:为单人而建 切斯基看到聊天机器人的第二个问题:它们是为一个人构建的。他觉得它们不是协作式界面,而这对人们经常与家人朋友一起使用的产品来说很重要。 未来三到六个月,Airbnb 的任务是探索能够实现**多人 AI** 的界面,即多个人(比如一起规划旅行的群体)可以同时使用的 AI。 ## 生成式界面与确定性界面的混合 Airbnb 并非唯一在重新思考 AI 界面形态的公司。随着 AI 工具演进,新界面也在应用中涌现。**Monogram** 和更近期的 **Wabi** 等初创公司正在试验**生成式界面**——由 AI 即时构建的屏幕,而非设计师预先固定的界面。 切斯基认为,人们会看到**确定性界面**(预先设计、可预测)和**生成式界面**的混合。 ## 为什么消费级 AI 仍未奏效? 切斯基在采访中还谈到消费级 AI 的现状,以及为什么它还没有真正打动普通用户。他的核心观点是:世界需要一个 **AI 原生操作系统**。当前的 AI 智能体缺乏属于自己的运行环境,导致体验碎片化、无法协作、难以跨应用完成任务。 这一判断与行业动向相呼应:从 OpenAI 到 Anthropic,各大厂商都在探索智能体框架,但底层操作系统层面的整合仍属空白。切斯基的呼吁暗示,Airbnb 未来可能不只是接入 AI,而是参与定义 AI 时代的交互底层。 ## 语音的角色 切斯基也谈及语音将扮演的角色。虽然他没有给出具体产品路线图,但表示语音是自然交互的一部分,尤其适合那些“快而简单”的任务场景。不过,对于需要灵感和浏览的旅行规划,视觉界面仍不可替代。 ## 小结 Airbnb 的 AI 搜索只是起点。切斯基的愿景很清晰:不是用聊天机器人取代一切,而是构建一种既能快速完成任务、又能支持多人协作、还能保留浏览乐趣的混合界面。而要实现这一点,或许真的需要一个为 AI 智能体而生的操作系统。
在AI智能体(Agentic AI)快速发展的今天,如何管理这些自主实体的身份已成为一个关键挑战。近日,一份题为《Identity Management for Agentic AI》的2025年PDF文档在Hacker News上引发热议,获得77分和28条评论。该文档探讨了为AI智能体建立身份管理系统的必要性和潜在方案。 ## 为什么智能体需要身份管理? 传统AI系统通常作为工具运行,而智能体AI具备自主决策、执行任务和与其他系统交互的能力。这意味着它们需要像人类用户一样拥有可验证的身份,以便进行权限控制、审计追踪和责任归属。 ## 核心挑战 - **自主性**:智能体可能动态生成子智能体或修改自身行为,身份需要随之变化。 - **互操作性**:不同厂商的智能体需要相互认证和授权。 - **安全与隐私**:防止身份伪造和恶意攻击,同时保护敏感数据。 ## 可能的方向 文档可能提出了基于去中心化标识符(DID)、可验证凭证(VC)或区块链的解决方案,为每个智能体分配唯一且可验证的身份。此外,可能涉及策略管理、生命周期管理和信任框架。 虽然具体内容因PDF格式无法直接解析,但这一话题反映了AI治理的紧迫性。随着智能体在金融、医疗、客服等领域的部署,身份管理将成为基础设施的关键部分。Hacker News上的讨论也表明,技术社区对此高度关注,期待更成熟的方案出现。
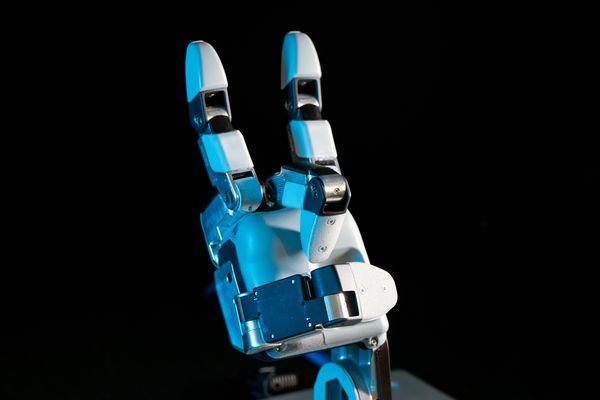
## 波士顿动力为何反其道而行? 在机器人领域,打造一只「像人手一样」的机械手,几乎是所有顶尖实验室的执念。但波士顿动力(Boston Dynamics)在 Atlas 机器人上给出了一个反直觉的答案:**三根手指加一根拇指,13 个自由度**——这就是他们眼中「几乎能做所有事」的最优解。 据 IEEE Spectrum 报道,波士顿动力认为,人类手部的复杂结构并非机器人抓取的最佳模板。人手拥有约 21 个自由度,但其中大量自由度用于精细的肌肉协同与冗余控制,对机器人而言,这反而意味着**更高的成本、更复杂的控制算法和更低的可靠性**。 ### 三指为何够用? 从工程角度看,机械手设计的核心矛盾始终是:**能力、可靠性与可制造性**三者难以兼得。 - **能力**:13 个自由度已足以覆盖绝大多数工业与物流场景中的抓取需求,包括不规则物体、工具使用和双手协同操作。 - **可靠性**:更少的关节和驱动器意味着更少的故障点。在 Atlas 这类需要高动态运动的人形机器人上,手部一旦失灵,整机任务即告失败。 - **可制造性**:仿人手往往依赖大量定制微型电机和精密传动结构,量产难度极高。三指方案在零部件数量和装配复杂度上都有显著优势。 值得注意的是,这并非波士顿动力首次挑战仿人范式。Atlas 本身就以非仿人的液压驱动和动态运动能力著称,其设计哲学一贯是**功能优先于形态**。 ### 行业背景:仿人手的困境 过去十年,Shadow Robot、特斯拉 Optimus、以及多所高校的灵巧手项目,大多沿着模仿人手的路线推进。但结果往往是:实验室演示惊艳,实际部署困难。特斯拉 Optimus 的机械手据称拥有 11 个自由度,已引发广泛讨论;而波士顿动力的 13 自由度三指方案,在自由度数量接近的同时,结构更为精简。 这背后反映出一个更深层的趋势:**人形机器人的竞争正在从「像不像人」转向「能不能干活」**。当机器人进入仓储、制造和危险环境作业时,可靠性、维护成本和量产能力,远比外观拟人更重要。 ### 仍需观察的问题 目前,波士顿动力尚未公布该机械手的详细技术参数、负载能力和量产计划。三指设计在精细操作(如穿针、使用螺丝刀)上的上限,也有待实际验证。但可以确定的是,这一设计为行业提供了一个重要参照:**仿人未必是最优,工程约束下的取舍才是真正的竞争力。**
在年度 DevDay 大会上,OpenAI 正式发布了名为 **Dots** 的 AI 智能体,由 **GPT-6 Astra** 驱动。这款产品从形态到定位都与 Meta 的 Muse 平台高度相似,标志着两家科技巨头在 AI 智能体赛道的正面交锋正式打响。 ## 可爱外表下的技术野心 OpenAI CEO **Sam Altman** 在欢呼声中登台,将 Dots 描述为一款「真正的 AI」智能体,灵感来源于「我们从小在电影里看到的那种酷炫智能体」。与 Meta Muse 类似,Dots 采用了色彩鲜艳、可个性化定制的「小圆点」形象,配有拟人化的眼睛,刻意营造出一种平易近人的可爱感。 不过 OpenAI 并不满足于仅仅做一个「有用的助手」。在演示环节,Dots 展示了构建类元宇宙虚拟世界的能力——这被普遍解读为对 Meta 核心业务的直接挑衅。 ## 价格:一场不对称的战争 然而在竞争中最关键的维度上,Dots 却暴露出明显短板:**定价**。 Meta 的 Muse 主打「免费且无摩擦」的 AI 智能体体验,为每位用户提供一台免费的专属虚拟机,同时承载智能体与用户数据。任何拥有 Meta 账号的用户都能直接使用 Muse。 相比之下,OpenAI 的 Dots 目前仅向 **每月 20 美元的 Pro 计划及以上用户**开放。考虑到 ChatGPT 拥有约 **12 亿用户**,其中绝大多数人将无法体验 Dots。 ## OpenAI 为什么不敢免费? 答案藏在财务数据里。据 Bloomberg 报道,OpenAI 正以 **1.4 万亿美元估值**寻求 **300 亿美元**融资;Axios 则指出,自第三季度初以来公司增长了 **70%**,年度经常性收入已接近 **700 亿美元**。 但即便是这样的体量,OpenAI 的资金也并非无限——尤其当对手是 Meta 这样的广告巨头时。过去一年,已有不少用户指责 AI 实验室在「AI 资金紧缩」背景下将成本转嫁给消费者,而 OpenAI 目前正以惊人的速度烧钱。 ## 免费能否成为护城河? 这场竞争的核心问题在于:当功能趋同时,**免费**是否会成为决定性的护城河?Meta 用广告业务补贴 AI 基础设施的模式,让它可以承受长期亏损来换取用户规模。而 OpenAI 作为一家仍需外部融资的 AI 实验室,必须在增长与成本之间走钢丝。 Dots 的技术能力或许足够亮眼,但如果大多数用户被价格挡在门外,OpenAI 可能重演「技术领先但用户增长受限」的困境。这场可爱智能体之间的战争,最终可能由财务报表而非技术演示来决定胜负。
移动应用的时代正在落幕?AI 初创公司 **Photon** 用一场真实的葬礼宣告了它对移动应用未来的判断。这家帮助开发者构建跨消息平台 AI 代理的初创公司,刚刚完成了 **450 万美元种子轮融资**。 ## 一场“应用葬礼”背后的赌注 9 月 17 日,旧金山的一座教堂里,Photon 为移动应用举办了一场葬礼——有演讲、有小组讨论,甚至还有一口真正的棺材,里面装满了应用图标。这显然是一场半开玩笑的营销活动,但联合创始人兼 CEO **Daniel Tian** 对背后的判断却相当认真:“老实说,这需要一段时间,但我认为,从方向上看,从应用到代理的转变是不可避免的。” Photon 的核心论点是:用户不再愿意下载新应用,他们更希望通过已有的消息应用(如 **iMessage** 和 **WhatsApp**)直接访问 AI 代理。 ## 从“应用发现难”到 4 万开发者 Photon 的创立源于 Tian 和 CTO **Ryan Zhu** 在学生时代反复遇到的瓶颈:每次开发完新应用,都卡在“如何让人发现它”这一步。他们意识到,如果能构建一个在 iMessage 内运行的代理,就能借助用户每天都在用的苹果 Messages 触达他们。 Tian 曾开发过一个能在 iMessage 上冒充他本人回复朋友的机器人。当他们在 GitHub 上开源这项技术后,数千名开发者采用了它。于是两人决定全力投入:Tian 从宾夕法尼亚大学 M&T 项目退学,Zhu 离开高中,后来成为 MIT 媒体实验室的访问学生。 如今,Photon 声称已拥有 **超过 4 万名开发者**,收入在 **四个月内增长了 10 倍**。 ## 产品与市场定位 Photon 提供一套工具包,包括: - **统一 API** - **可扩展的渠道框架** - **命令行界面(CLI)** - **可观测性套件** 这些工具让开发者能够构建和运营跨 **iMessage、WhatsApp、Telegram、SMS/RCS、电子邮件、语音** 等平台的代理体验。 即便 Meta 的 **Muse** 等消费级 AI 应用在应用商店登顶,Tian 仍然认为,服务那些希望自己的应用能在消息服务上运行的开发者,是一个独立且巨大的市场。 Photon 的赌注能否成立,取决于消费者是否真的会像 Tian 所预测的那样,逐渐放弃下载应用,转而依赖消息平台内的 AI 代理。至少现在,它已经用一场葬礼,让更多人开始思考这个问题。
在AI基础设施狂飙突进的当下,一座号称“全球最大”的数据中心本应是技术乐观主义的丰碑。然而,The Verge资深特稿作者Josh Dzieza历时数月调查发现,Kevin O'Leary在犹他州推动的**Stratos项目**(更广为人知的名字是**Wonder Valley**)非但没有成为AI算力的里程碑,反而演变成一场彻底的政治灾难——项目被叫停,犹他州政治生态被颠覆。这个故事揭示了一个被硅谷长期忽视的真相:当科技巨头试图用资本强行推进基建时,地方民主可能成为它们唯一无法用钱摆平的障碍。 ## 一个“世界最大”的野心 根据The Verge编辑-in-chief Nilay Patel与Josh Dzieza的对谈,Wonder Valley的规划规模令人咋舌:占地**4万英亩**,配备**9吉瓦**电力——这比整个犹他州的平均用电量还要高出一倍多。项目背后的推动者是知名投资人Kevin O'Leary,他在Shark Tank节目中以“Wonderful”的口头禅闻名,项目也因此得名。 从纸面上看,这似乎是AI时代最激动人心的基建故事:算力即权力,谁掌握最大规模的数据中心,谁就掌握AI竞赛的入场券。O'Leary本人也频繁现身新闻,为项目造势。 ## 地方民主:科技巨头无法“花钱摆平”的障碍 但Dzieza的调查揭示了故事的另一面。Wonder Valley的推进方式——如何规划、如何宣布、如何获批、如何将当地居民蒙在鼓里——最终点燃了一场严重的政治风暴,直接导致Stratos项目戛然而止。 关键问题在于:**当地居民被排除在决策过程之外**。数据中心带来的土地征用、水资源消耗、电力挤占和环境影响,在项目宣布前几乎没有经过充分的公共讨论。当居民意识到发生了什么时,反弹迅速跨越党派界限,形成了罕见的**两党共同反对**局面。 这并非孤例。Dzieza的报道将Wonder Valley置于更大的行业背景下:AI基础设施热潮正在全美各地遭遇类似的抵制。科技行业发现,尽管它们可以斥巨资购买土地、电力和设备,却无法用同样的方式“购买”当地社区的同意。 ## 对AI行业的警示 Wonder Valley的失败传递了一个清晰信号:AI基建的瓶颈正在从技术转向政治。当数据中心规模大到足以改变一个州的能源格局和社区面貌时,它就不再是单纯的商业项目,而是一个公共政策议题。 对于正在全球范围内疯狂建设数据中心的科技公司而言,犹他州的教训值得深思:**速度与透明度之间的权衡**,可能比芯片供应或电力成本更能决定项目的生死。 正如Patel在对话中所言,这个故事不仅是关于一个项目的失败,更是关于“AI行业的基础设施繁荣、两党对建设的反弹,以及科技行业如何撞上它似乎无法用钱解决的唯一障碍:地方民主。”
**美国联邦贸易委员会(FTC)** 已对多家领先人工智能公司展开调查,重点审查其产品可能带来的风险。据 Hacker News 热门讨论,此次调查涉及 **OpenAI**、**Anthropic** 等头部 AI 企业,引发业界广泛关注。 ## 调查背景 FTC 作为美国主要的消费者保护机构,近年来持续关注 AI 技术的快速发展可能带来的隐私、安全及竞争问题。此次调查旨在评估这些公司的 AI 产品是否存在误导用户、侵犯隐私或造成其他损害的风险。 ## 涉及公司 虽然具体调查细节尚未完全公开,但已知 **OpenAI**(ChatGPT 开发商)和 **Anthropic**(Claude 开发商)均在调查名单之列。这两家公司是生成式 AI 领域的代表性企业,其产品被广泛应用于对话、写作、编程等场景。 ## 行业影响 此次调查可能对 AI 行业产生深远影响: - **合规压力增加**:AI 公司可能需要更严格地审查产品输出,避免有害内容或虚假信息。 - **透明度要求提升**:FTC 可能要求企业披露更多关于模型训练、数据使用及风险缓解措施的信息。 - **创新与监管平衡**:如何在促进 AI 创新的同时保护消费者权益,成为政策制定者的关键挑战。 ## 业界反应 Hacker News 上的讨论(187 分,131 条评论)显示,开发者与创业者对调查看法不一。部分人认为监管有助于建立信任,另一些人则担忧过度监管可能减缓技术发展。 目前,OpenAI 和 Anthropic 尚未就调查发表正式回应。FTC 也未公布调查时间表或潜在处罚措施。我们将持续关注事件进展。
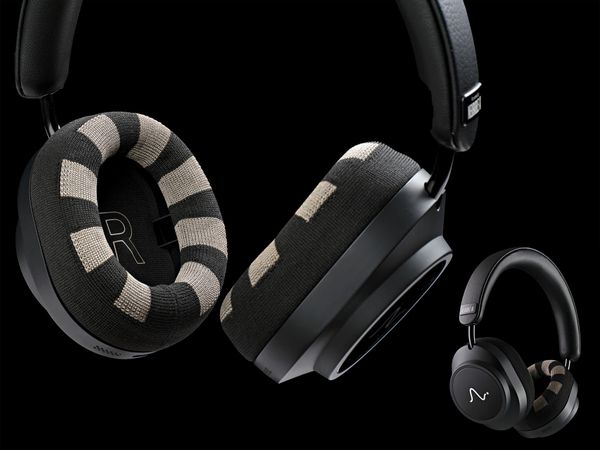
## 当耳机开始「读心」 一副看起来与普通头戴式耳机无异的设备,正在尝试回答一个越来越紧迫的问题:**我们的大脑什么时候需要休息?** 据 IEEE Spectrum 报道,Neurable 推出的 **Neurable One** 将主动降噪耳机与非侵入式脑机接口合二为一。它在耳罩内缝入了 **12 通道 EEG(脑电图)传感器**,持续采集用户的脑电波数据,并通过算法学习每个人的独特脑波模式,从而识别疲劳状态。 ## 不是「读心术」,而是疲劳监测 需要澄清的是,这类设备并不解读你在想什么。它的核心任务更朴素也更实用:**判断认知疲劳何时出现**。 传统上,EEG 测量需要在头皮上涂抹导电凝胶、粘贴多个电极,操作繁琐且局限于实验室环境。Neurable 的思路是把电极藏进日常佩戴的耳机耳罩中,让数据采集发生在通勤、办公或游戏等真实场景里。 关键难点在于信号质量与个体差异。耳部周围的电信号比头皮更微弱,且每个人的脑波基线不同。Neurable 的应对方式是**让系统随时间学习用户自身的脑波特征**,而非套用统一阈值——这也是「个性化」成为产品卖点的原因。 ## 脑机接口的消费化路径 Neurable 并非新玩家。这家公司此前曾推出过基于 EEG 的 VR 控制方案,如今转向消费级耳机,折射出脑机接口行业的一条现实路径:**与其追求高带宽的「意念控制」,不如先做低门槛的状态监测**。 这一转向有其合理性。疲劳、注意力、放松程度等指标对信号精度的要求相对宽容,却对应着真实需求——无论是防止疲劳驾驶、优化工作节奏,还是帮助游戏玩家判断何时该收手。 ## 值得追问的问题 不过,将 EEG 装进耳机仍面临几重考验: - **准确性**:12 通道耳部 EEG 能否稳定区分「疲劳」与「无聊」「分心」等状态? - **实用性**:识别出疲劳之后,用户会真的改变行为吗? - **隐私**:脑电数据属于最敏感的生物信息之一,如何存储、使用和共享,目前尚无成熟的行业规范。 ## 小结 Neurable One 的意义或许不在于它是否完美,而在于它把脑机接口从实验室推向了货架。如果这类设备能证明「日常场景下的脑状态监测」足够可靠,那么 EEG 耳机的故事,可能才刚刚开始。
在印度德里,电力盗窃曾是一项普遍现象,导致电力公司巨额亏损,并加剧了电网压力。然而,这座城市似乎找到了一种有效的解决方案。IEEE Spectrum 的报道指出,德里的做法可能为其他面临类似问题的地区提供借鉴。 电力盗窃通常通过非法接线、篡改电表或直接窃电等方式进行,不仅造成经济损失,还危及公共安全。德里采取的综合性措施,结合了技术升级、执法加强和社区参与,显著降低了盗窃率。 虽然具体细节尚未完全披露,但德里的经验表明,解决电力盗窃需要多管齐下,而非单一手段。其他城市在考虑复制这一模式时,需根据本地情况调整策略。 随着全球能源需求增长和电网现代化推进,电力盗窃问题日益受到关注。德里的案例为政策制定者和电力公司提供了有价值的参考。
## 芯片设计的新变量 电子设计自动化(EDA)巨头 **Synopsys** 近日因一则与 **GPT** 相关的动态登上 Hacker News 热门,引发社区对“前沿智能革新芯片设计”的讨论。尽管现有信息仅包含官网入口,但结合行业动向,这一方向已足够值得关注。 ## 为什么芯片设计需要 AI? 现代芯片设计是人类最复杂的工程活动之一:单颗芯片可能包含数百亿晶体管,设计流程涵盖架构探索、逻辑综合、布局布线、验证签核等数十个环节,每个环节都涉及巨大的搜索空间与权衡。传统 EDA 工具依赖启发式算法和专家经验,而随着工艺逼近物理极限,设计复杂度呈指数增长,人力与算力瓶颈日益突出。 **AI 的介入有望从根本上改变这一局面:** - **设计空间探索**:强化学习可在海量参数中快速找到性能、功耗、面积的最优解; - **布局布线优化**:谷歌曾用强化学习将芯片布局时间从数周缩短到数小时; - **验证与调试**:大模型可辅助生成测试用例、定位缺陷,减少重复劳动; - **知识复用**:将历史设计经验编码为模型,降低对资深工程师的依赖。 ## Synopsys 的 AI 布局 Synopsys 早已在 AI 驱动 EDA 上投入重兵,其 **DSO.ai** 等产品利用强化学习优化芯片设计流程,并宣称可将设计效率提升数倍。此次与 GPT 的关联,可能指向更深入的生成式 AI 集成——例如用自然语言交互完成设计意图描述、自动生成 RTL 代码,或构建芯片设计领域的专用大模型。 Hacker News 上 189 分、111 条评论的热度,反映出开发者社区对“AI 重构芯片设计”既期待又审慎。讨论可能集中在: - 大模型在严谨工程场景中的可靠性; - 数据安全与 IP 保护; - 对 EDA 行业格局的冲击; - 是否真能带来数量级效率提升。 ## 挑战与不确定性 芯片设计容错率极低,一次流片失败可能损失数千万美元。生成式 AI 的“幻觉”问题在此时尤为致命。因此,短期内 AI 更可能扮演“副驾驶”角色,而非完全替代人类工程师。此外,EDA 三巨头(Synopsys、Cadence、Siemens EDA)的竞争也将因 AI 加剧。 ## 展望 如果 Synopsys 能成功将前沿智能融入芯片设计全流程,其影响将远超工具层面——它可能重塑半导体行业的创新节奏,让定制芯片不再是大厂专属。对于 AI 从业者而言,这也是大模型在垂直领域落地的一次关键验证。 (注:本文基于有限信息与行业背景推断,具体产品细节以官方发布为准。)
当AI智能体开始自主行动,当大模型渗透进企业每个角落,一个棘手的问题浮出水面:**AI出了事,谁来负责?** 普华永道(PwC)最新发布的《数字信任洞察2027》报告给出了一个令人不安的答案:**企业高层对此毫无共识**。这项覆盖71个国家、约4000名商业与技术领袖的调查显示,没有任何一个角色对AI智能体及其安全负有明确责任。 ## 高管们的责任“甩锅”图鉴 调查数据勾勒出一幅混乱的权责图景: - **29%** 的CEO及安全风险负责人认为,责任应落在CIO、CTO或其他技术角色头上 - **17%** 的受访者表示,CISO或网络安全团队才是担责方 - 仅有约**三分之一(33%)** 的组织设立了专门的AI高管职位,如首席AI官或AI董事会成员 这意味着,超过半数的企业在AI治理上仍处于“无人驾驶”状态。当AI模型失控、AI智能体成为攻击入口、或发生“友好AI黑客”入侵无辜企业的事件时,问责链条的断裂可能让企业付出惨痛代价。 ## 董事会层面的认知鸿沟 报告同时揭示了一个积极信号与一个明显短板: **积极面**:九成商业领袖表示,董事会监督、高管问责和企业风险整合等机制已基本到位。 **短板**:只有**47%** 的受访者表示网络安全是董事会的固定议程——这远远不够。要知道,AI风险早已不是技术部门的“家务事”,而是关乎企业生死的战略议题。 ## 首席AI官是解药吗? 面对责任真空,设立“首席AI官”(CAIO)或专门的AI董事会成员,正被越来越多企业视为解决方案。但这真的够吗? 问题的核心在于:**AI治理不能只是“挂个名”**。如果首席AI官没有实权、不掌握预算、无法穿透业务线,那么这个职位只会沦为摆设。更关键的是,AI风险横跨技术、法律、合规、伦理多个维度,单一角色很难独揽全局。 普华永道的调查传递出一个明确信号:企业需要从“谁负责”的争论,转向“如何共担”的机制设计。这包括明确AI系统的身份控制(正如管理员工一样管理AI智能体)、建立跨部门的风险委员会、以及将AI安全纳入董事会常规议程。 AI带来的效率红利毋庸置疑,但红利背后是风险的对价。当AI智能体开始像员工一样行动,企业就必须像管理员工一样,为它们建立身份、权限与问责体系。否则,下一次AI事故来临时,企业可能连“谁该写检讨”都找不到。
## 核心发现 大语言模型(LLM)的强化学习训练正在从「可验证奖励」中获益,但一项新研究指出:**现有后训练方法普遍忽视了一个关键区分——哪些问题模型一次就能答对,哪些问题需要多次采样才能「捞」出正确答案。** 这篇来自 arXiv 的论文(编号 2609.35793)提出了 **GapFT** 方法:只针对「单样本失败、但 K 次采样内能解出」的问题进行微调,结果在 **Llama-3.1-8B** 上把 **Pass@1 提升了 14.4 和 13.9 个百分点**,并且用三分之一的训练数据就追平了在全量验证集上微调的效果。 ## 问题背景:验证器能「捞答案」,但部署时往往只有一次机会 论文聚焦一个现实矛盾: - **训练侧**:RLVR(可验证奖励强化学习)借助精确验证器,可以从多个采样中挑出通过的答案,支持测试时扩展(test-time scaling); - **部署侧**:很多场景只允许**单样本解码**——每个问题生成一次回答,没有搜索、没有重采样。 作者提出的问题是:**搜索暴露出来的行为,能否被「吸收」进模型本身?** 现有做法通常把「已验证正确的回答」不加区分地用于后训练,但论文指出这会造成预算浪费——大量训练样本其实在重复模型已经掌握的行为。 ## GapFT 的做法 GapFT 的核心是按「来源检查点的单样本结果」筛选训练证据,专门在 **Pass@K 与 Pass@1 的差距区间**上微调,也就是: > 模型单次采样失败、但在 K 次采样内被验证器判定通过的问题。 在实验设计上,论文严格控制了变量:训练样本数、处理的 token 数、优化器步数都保持一致,目标函数也不变,从而把提升归因于「样本选择」而非训练规模。 ## 关键结果 - 在 **LogiQA 2.0** 和 **ReClor** 两个逻辑推理数据集上,使用 **Llama-3.1-8B**: - GapFT 相比源模型 **Pass@1 提升 14.4 / 13.9 分**; - 在相同学习率下,优于**预算对齐的均匀验证 RFT**; - 用**三分之一的数据**追平在全量验证池上的微调效果。 - **单次解码即可达到源模型经验证器筛选后的 Pass@4 准确率**——这意味着原本需要 4 次采样加验证器才能拿到的效果,被压缩进了一次生成。 - 随机对照实验表明,增益主要来自**覆盖了不同的失败模式**;分析还将可获得的增益与「可迁移的失败支撑集」联系起来。 - 在 **Qwen2.5-7B** 上的三随机种子复现实验,在两个逻辑任务上仍保持对均匀 RFT 的正向增益。 ## 为什么值得关注 对实际部署而言,测试时扩展(多采样 + 验证器)虽然有效,但推理成本高昂。GapFT 提供了一条更务实的路径:**把搜索能力蒸馏进模型权重,让单次推理接近搜索级表现**。 论文也坦承边界——增益与「可迁移的失败支撑」相关,意味着并非所有失败都能被这种训练方式补救。这为后续研究留下了明确的问题:哪些失败模式是可以通过后训练吸收的,哪些必须依赖外部工具或搜索?
## 当模型跨医院部署,"准不准"比"分得开"更重要 哮喘恶化预测是典型的临床时序任务:模型需要综合环境、肺功能、症状、用药、可穿戴设备与情境等多路信号,提前给出短期风险预警。然而现实部署中,患者群体、传感器生态和可用模态都会随队列变化。现有模型大多在单一队列内优化**区分度(discrimination)**,一旦迁移到新队列,输出的概率往往严重失准——而临床决策恰恰依赖概率本身,而不只是排序。 arXiv 论文 **CALIBRA**(arXiv:2609.35795)正是针对这一痛点提出的"校准优先"多模态时序框架。 ## CALIBRA 做了什么 该框架的核心设计可以拆成三层: - **专用循环编码器**:分别为环境、肺功能、症状、用药、可穿戴和情境等数据流建模,而非强行拼接成单一向量。 - **可靠性条件门控**:当某模态数据陈旧或缺失时,门控机制会主动抑制其影响,从而应对真实场景中普遍存在的不完整数据。 - **梯度反转训练**:通过对抗式训练削弱可避免的队列特征,让模型学到更可迁移的表示。 在预测层,CALIBRA 使用**收缩式层次逻辑回归**,在一个患者不重叠的目标子集上校准概率;同时引入**分裂共形预测(split conformal prediction)**,输出具备"弃权"能力的预测集合,即在证据不足时允许模型不作判断。 ## 实验结果与边界 为避免虚构临床证据,作者在一个有文档记录、受控分布偏移的**三队列半合成基准**上完成评估,目标患者被严格封存。在五个随机种子下: - 平均目标测试 **AUPRC 为 0.224**,最强非消融对照 **TemporalTransformer 为 0.240**; - 平均 **AUROC 为 0.717**,**Brier 分数为 0.098**。 值得注意的是,CALIBRA 在区分度指标上并未全面超越对照,但其卖点在于校准质量与迁移可靠性。实验还覆盖了完整模态失效、校准曲线、共形覆盖率、决策曲线、亚组行为、消融、运行时间与参数量等维度。 作者明确强调:结果仅在受控偏移下验证了方法与可复现流程,**并不构成临床有效性证据**,仍需在协调后的真实哮喘队列上做外部验证。 ## 为什么值得关注 这篇工作折射出医疗 AI 的一个转向:从"刷高 AUROC"走向**可校准、可弃权、可迁移**的部署级要求。对于任何需要在多机构、多设备生态中落地的健康预测模型,CALIBRA 的"校准优先"思路提供了一个值得借鉴的工程范式。
用大语言模型当评审、把打分结果直接转成「通过/不通过」来训练策略,是当前 RLHF 与可验证奖励之外最常见的做法之一。但一篇新论文指出,这种二值化操作会系统性地「压平」评分空间,让一类真实存在的质量变化在训练信号中彻底隐身。 ## 问题出在哪 论文作者 **Jacob Cole** 把每个通过/不通过判定,建模为一条未公开评分尺度上的分数与某个阈值的比较。关键在于:只要对这条尺度做**仿射拉伸**(proportional stretch),所有分数会等比地靠近或远离阈值,却**永远不会跨过阈值**——于是没有任何一个判定会发生变化。 换句话说,策略完全可以对响应质量做这种整体缩放,而评审面板报告的结果一模一样。对训练而言,这意味着奖励信号对这类变化完全「失明」。 ## 加一档就能修好 作者在联合高斯模型下证明:引入**第三档评分**相当于增加第二个阈值,从而消除这种仿射拉伸的歧义。 实验验证使用了 **MATH** 与 **SciBench** 的输出,评审为一个包含七项标准的 LLM judge。结果很直接: - 构造出的 **14 个**逐标准拉伸,在二值化后**全部不可见**; - 换成三档评分后,这些变化**全部可见**; - 在 **n=1,024** 时,同时掌握两种总体分布的检验在 **1.5 倍压力**下功效至少达到 **96.5%**。 ## 但三档也不是万能药 论文特别强调,保留档位只是堵上了一个盲点,**判定本身仍然不够用**。仍有两类变化无法与真实改进区分: 1. **档位内的任意变化**; 2. **固定协方差、沿载荷方向对齐的均值漂移**——作者称这正是「谄媚式提升」(sycophancy-shaped lift)的特征,而评审却会把它读成能力提升。 此外,论文使用的共享因子参考近似在 MATH 和 SciBench 上拟合良好,但在 **HealthBench** 上并不成立,这也划定了该方法的经验适用范围。 ## 实践建议 作者给出的建议相当具体: - 至少保留**三档评分**,例如让评审对每条标准回答「完全满足 / 部分满足 / 不满足」,并给予 **{0, 0.5, 1}** 的奖励; - 对剩余方向上观察到的增益,进行**外部验证**——因为再细的评分尺度也无法消除这一方向的歧义。 论文共 14 页、3 张图、2 张表,属于预印本,尚未经过同行评审。对于正在用 LLM judge 构建奖励信号的团队来说,这项工作的价值在于:它把「二值化会损失什么」从直觉变成了可量化、可检验的结论。
低比特 KV 缓存量化能显著节省显存,却往往让视觉语言模型(VLM)的准确率断崖式下跌。一篇新论文提出了 **HeadGuard**,一种可组合的注意力头保护方案,试图在不更换底层量化器的前提下,把丢失的精度「捞」回来。 ## 问题出在哪里 VLM 在处理图文混合输入时,KV 缓存的体积会随图像 token 数量迅速膨胀,成为推理显存的主要负担。把缓存压到 2 bit、3 bit 是常见思路,但论文指出:**低比特量化对 VLM 的伤害远比对纯文本 LLM 更明显**,因为视觉 token 的键值分布更不均匀,一刀切量化会直接破坏跨模态对齐能力。 ## HeadGuard 的做法 HeadGuard 的核心思路很朴素——不是所有注意力头都同等重要,那就别让它们一起「降级」。 - 通过 **图像敏感度(image-sensitivity)** 与 **输出敏感度(output-sensitivity)** 两个离线评分,挑选出对视觉信息最关键的物理 KV 头; - 主实验中约 **1/8** 的注意力头被纳入保护名单; - 被保护的头,其图像 key(以及可选的 value)继续以 **bfloat16(BF16)** 高精度保存,其余未保护条目则交给基础量化器压缩。 由于保护掩码是固定且离线的,HeadGuard 可以叠加在任意基础量化器之上,属于「即插即用」的增强层,而非替代方案。 ## 实验数据 论文在 **8 个 VLM、3 种基础量化器和 8 个基准(6 个判别式 + 2 个生成式)** 上做了评估,结果包括: - 在 **2 bit** 设置下,最弱基础量化器的六任务判别式平均分从 **0.436 提升到 0.580**; - **Qwen 与 InternVL** 系列收益最为明显; - 保护机制还能改善生成式回答质量,以及图像描述与 BF16 输出的保真度; - 在三类量化器、两套校准数据集上,平均精度增益均可复现; - **仅保护 key** 的轻量版本在更低存储成本下仍保留大部分恢复效果。 ## 值得注意的边界 需要强调的是,论文中的评估基于**模拟量化**,并非真实硬件部署下的实测结果,因此实际推理加速与显存收益仍需进一步验证。此外,1/8 的保护比例是主实验设定,最优比例可能随模型规模与任务类型变化。 ## 一句话总结 HeadGuard 提供了一条务实路线:与其重新设计量化算法,不如**精准识别哪些注意力头不能碰**,用极小的精度预算换取大幅的准确率回升。对需要在边缘设备或低成本 GPU 上部署 VLM 的团队来说,这是一个低侵入性的可选组件。
## 去中心化联邦学习的新选择 工业预测性维护正面临一个现实难题:设备分布在不同站点,传感器数据因隐私、带宽或合规限制难以集中汇聚。**联邦平均(FedAvg)** 通过中心聚合服务器解决这一问题,而 **Gossip 学习** 则更进一步——彻底移除服务器。但针对循环故障检测模型,Gossip 学习在受控条件下的表现一直缺乏系统测量。 一篇新发表于 arXiv 的论文 **《Serverless gossip training of LSTM failure detectors: A matched-protocol comparison with federated, local and centralized learning on NASA C-MAPSS》** 填补了这一空白。作者 Yusuf Öztürk 等人对比了**同步环形 Gossip**、**FedAvg**、**孤立本地训练**以及**集中式参考**四种方法,任务是在 NASA C-MAPSS 涡扇发动机基准上检测即将发生的故障,模型采用**堆叠 LSTM**。 ## 严格的控制变量实验 所有方法共享同一套开放实现、架构、初始化、优化器、数据划分和训练预算。主要评估指标使用每个测试引擎的**单个终端窗口**,以避免重叠窗口带来的统计依赖问题。 在 **FD001** 子集(五个随机种子)上,结果如下: - **Gossip**:终端窗口 F1 为 **89.6 ± 1.3%** - **FedAvg**:**89.9 ± 1.1%** - **本地训练**:**83.6 ± 6.7%** - **集中式训练**:**93.5 ± 2.1%** 值得注意的是,Gossip 在传输与 FedAvg 相同数据负载的情况下,**无需任何协调器**。节点模型之间高度一致但并非完全相同——成对决策分歧率为 **1.8%**,而无通信时高达 **5.6%**。 ## 跨子集表现与鲁棒性 在 FD002 至 FD004 子集上,对等通信将终端窗口 F1 相比本地训练提升了 **13 至 28 个百分点**。Gossip 在 **FD003 和 FD004** 上与 FedAvg 持平,但在多工况的 **FD002** 子集上低 **4.3 个百分点**。 模拟消息丢失、节点故障和服务器宕机对两种方法均无显著影响,但**环形规模增大时 Gossip 性能下降更快**。这表明:当数据异质性适中时,环形 Gossip 是实用的无服务器替代方案;而异质性加剧时,**更快混合的拓扑结构**变得至关重要。 ## 行业启示 这项研究为工业物联网场景提供了重要参考。对于无法部署中心服务器或担心单点故障的预测性维护系统,Gossip 学习在中等异质性数据下已接近 FedAvg 的精度。但若各站点数据分布差异巨大,仍需考虑更高效的通信拓扑。论文代码已开源,为后续研究提供了可复现的基准。