

在AI前沿实验室纷纷将高风险研究锁在门后的当下,两位行业科学家却选择了一条截然相反的路。他们创立非营利组织**Trillium Labs**,主张将递归自我改进(RSI)和智能体等敏感领域的研究公开进行。这究竟是天真,还是破解AI安全困局的关键一步? ## 封闭 vs. 开放:一场关于AI安全的路线之争 当前,**OpenAI**、**Anthropic**等头部公司的最强模型仅能通过应用或API访问,模型如何构建、如何行为,外界几乎无从知晓。支持者认为,将强大AI能力控制在少数可信者手中,是防止其造成现实危害的必要手段。 但**Nathan Lambert**和**Tom Zick**不这么看。他们共同创立了非营利研究机构**Trillium Labs**,聚焦**递归自我改进(RSI)**、**智能体**等潜在风险领域,并承诺公开实验细节,供外部科学家研究和复现。 Lambert曾任**Ai2**研究员,他告诉《连线》杂志:“过去几千年,人类用科学方法减轻伤害、建设更美好的未来。当前前沿AI的封闭发展轨迹,正在让我们倒退。” ## 透明度是风险放大器,还是安全阀? 封闭阵营的担忧不无道理。前沿模型已能自动发现软件漏洞、探测并入侵系统,近期多起备受瞩目的黑客攻击更让监管神经紧绷。 然而,Lambert认为,封闭反而削弱了社区审查想法、贡献新方法的能力。让外部专家了解模型的构建与调优方式,对缓解风险至关重要。 这一理念并非孤例。中国的**小米**近期公开了其模型重大训练运行的实时细节;**斯坦福大学**的研究人员也在公开预训练AI模型**Marin**。开放与封闭的路线之争,正成为AI行业的核心议题。 ## 高风险研究公开做,可行吗? Trillium Labs的实践意味着,实验的设计、过程和结果都将被记录并发布。这既能让更多科学家参与风险分析,也可能加速危险能力的扩散。 Lambert和Zick显然认为,共享对风险的理解,会让所有人更安全。在AI能力日益强大、安全争议愈演愈烈的今天,这场“公开做高风险研究”的实验,本身就是一次值得关注的探索。
## 当合规审查从“人工翻阅”变成“屏幕上的数字” 一家在多州持有 **5 万份租约**的物业运营商,正面临一个典型困境:各州房东-租客法规(滞纳金上限、通知期限、押金限额)随立法周期频繁变动,而每次法规更新后,合规团队必须找出哪些租约已经违规。小规模时,律师助理逐份阅读即可,答案可信,因为背后站着一个人。但当规模突破某个阈值,工作只能交给软件,新问题随之而来——**答案变成了屏幕上无人能独立验证的数字**。 AWS 在最新技术博客中提出了一种名为 **Adjudicated Query(裁决式查询)** 的设计模式,试图解决这一矛盾。其核心思路是:将生成式 AI 的对话能力与确定性的规则引擎分离。用户在 **Amazon Quick** 聊天界面中用自然语言提问,但最终的通过/拒绝判定完全由非 AI 的规则引擎做出。 ## 为什么 RAG 和 Text-to-SQL 不够用 文章明确指出,这类高利害合规场景需要两个关键属性: - **可证明的完整性**:诸如“我们检查了全部 22,910 份得克萨斯州租约”的声明必须真实且可演示。从未被评估的记录应被标记为“未评估”,而非被静默忽略。 - **可辩护性**:一项发现可能在数月后的诉讼、审计或监管检查中被质疑。辩护意味着必须清楚知道:哪条规则的哪个版本、应用于哪段条款文本、采用何种方法、在哪个日期、由谁执行。 **RAG(检索增强生成)** 解决了可访问性问题,但无法满足上述任一属性——相似度搜索没有“全部”的阈值,排序样本永远不知道自己排除了什么。**Text-to-SQL** 缩小了差距,但存在类别级风险:一个幻觉出的谓词可能静默缩小查询范围,导致漏检。 ## 参考架构与可部署示例 Adjudicated Query 模式将 Amazon Quick 聊天代理与一个**有界的 MCP 服务器**配对,后者封装在确定性规则引擎之上。文章提供了完整的 **AWS 参考架构**和一个可端到端运行的 **AWS CDK 示例**,以租约合规为具体案例。 该模式同样适用于其他高风险合规领域,例如**制裁筛查、保险理赔裁决、出口管制**。 > 对于正在探索生成式 AI 落地合规场景的团队,这一模式提供了一个重要思路:AI 负责交互与信息提取,但最终判定权必须交给可审计、可复现的确定性系统。
## 背景:知识截止问题与解决方案 Claude Desktop 在 Amazon Bedrock 上虽然能提供强大的 AI 辅助,但缺乏集成的网页搜索功能,其回答仅限于模型的训练知识截止日期。当用户需要获取最新信息,如文档更新、实时定价或天气情况时,模型无法自行检索。 **Amazon Bedrock AgentCore** 是一个用于大规模构建、连接和优化智能体的平台,支持任意框架或模型。通过其 **AgentCore Gateway** 功能,可以将 Claude Desktop 连接到 **Web Search**,从而弥补知识截止的差距。 ## Web Search 与 AgentCore Gateway Web Search 是一项完全托管、兼容 **Model Context Protocol (MCP)** 的网页搜索能力,由 Amazon 网页索引支持,覆盖数百亿文档。所有查询流量都保留在 AWS 基础设施内,无需管理外部 API 密钥,查询也不会离开您的边界。 使用 Claude Desktop,可以通过托管 MCP 服务器连接到启用了 Web Search 目标的 AgentCore Gateway。本文将逐步介绍如何设置此集成,并使用基于 **JSON Web Token (JWT)** 的入站认证来保护通信。 ## 架构与身份验证流程 许多在 AWS 上运行的企业使用 **AWS IAM Identity Center** 为其 AWS 账户提供单点登录 (SSO) 访问。在本演练中,我们使用 AWS IAM Identity Center 作为 AgentCore Gateway 的认证源。通过此设置,Claude Desktop 可以通过受信任的、企业管理的身份流调用 Web Search,符合现有组织身份治理,无需单独的凭证或第三方身份提供商。 为了将 AWS IAM Identity Center 与 AgentCore Gateway 的基于 JWT 的认证桥接,我们使用 **Amazon Cognito** 作为联合层,采用 OAuth 2.0 授权码授予流程。IAM Identity Center 通过 **SAML** 处理用户认证,Amazon Cognito 颁发 JWT,AgentCore Gateway 在每个请求时验证它们。整个认证链都保留在 AWS 内。 下图展示了此认证流程:  ## 先决条件 要遵循本文中的步骤,您需要: - 一个 AWS 账户,具有创建 AWS Identity and Access Management (IAM) 角色和 Amazon Bedrock AgentCore 资源的权限。 - 管理员访问权限(具体权限细节请参考原文)。 ## 总结 通过将 Claude Desktop 与 Amazon Bedrock AgentCore Gateway 和 Web Search 集成,并利用 AWS IAM Identity Center 和 Amazon Cognito 实现安全的 JWT 认证,企业可以在不牺牲安全性的情况下,为 AI 助手提供实时信息检索能力。这种方案完全在 AWS 内运行,简化了管理并增强了合规性。
## 为什么搜索智能体需要多轮训练? 大模型驱动的**搜索智能体**正在改变企业信息检索的方式:它不再要求用户写出精准的查询词,而是自己决定搜什么、用哪种检索策略、什么时候停下来,并在多轮交互中根据已获取的信息不断调整方向。 但要让这种多步行为真正可靠,并不容易。**没有任何基础模型天生就懂你的工具和运行环境**:提示一个小模型,多轮行为往往不稳定;提示一个前沿大模型,效果通常不错,但代价是更高的延迟和成本。 微调提供了第三条路——直接把工具和环境“教”给小模型,从而在保持小模型速度与成本优势的同时,获得原本只有前沿模型才具备的可靠性。 ## 传统微调方法为何不够用 即便微调是顺理成章的下一步,常见做法也各有短板: - **监督微调(SFT)**:依赖专家演示的理想多轮轨迹,收集成本高,而且针对你自己的场景往往根本不存在这样的数据。 - **单轮强化学习**(如 RLVR,可验证奖励的强化学习):一次只给一个回复打分。但搜索智能体的决策是多轮相互依赖的,每一步都建立在之前的上下文之上,孤立地优化单步会完全忽略这种依赖关系。 真正需要的,是一种**覆盖完整多轮轨迹**的训练方式:奖励信号只需反映最终结果好不好,而不必逐步标注。 ## 多轮强化学习(MTRL)做了什么 这正是**多轮强化学习(MTRL)**的价值所在。它训练智能体在一整串步骤中做出好决策,把环境相关的行为内化进模型,同时让你对输出质量有更强的控制。由于最终运行的是更小、更专用的模型,推理也更快、更便宜。 在本文中,我们介绍了如何使用 **Amazon SageMaker AI MTRL** 微调一个搜索智能体,并分享了在**检索质量和可靠性**上观察到的结果。 Amazon SageMaker AI MTRL 让你能够在多轮交互场景下用强化学习微调大模型,它把一个智能体任务建模为一系列决策过程。至于具体的训练配置、奖励设计与实测提升幅度,原文尚未展开,需要结合完整技术文档进一步确认。 ## 值得关注的信号 对企业而言,这条路径的意义在于:**用专门化的小模型替代通用大模型**,在搜索这类高频、多步、强依赖环境的任务上,可能同时拿到更低的延迟、更低的成本和更稳定的表现。多轮强化学习能否成为智能体训练的主流范式,值得持续观察。
## 教皇利奥十四世为何批评AI艺术? 本周五,罗马教皇**利奥十四世**在X平台上发文,明确表达了对AI生成艺术的反对态度。他写道:"在人工智能时代,区分人类艺术与机器产物变得尤为紧迫。艺术与机器通过统计计算生成的图像之间,存在**本体论上的差异**,这种差异甚至先于美学差异。算法缺乏人类火花。" 教皇进一步解释,AI生成内容是基于对他人创作的数百万张图像进行统计计算的结果,而人类艺术则源于独特的灵性体验。 ### 梵蒂冈的AI立场 这并非教皇首次就AI发声。今年5月,他发布了一道**通谕**,强调在自动化日益普及的世界中维护人类尊严的重要性。此次X平台发文可以视为该立场的延续和具体化。 值得注意的是,科技公司也在试图影响梵蒂冈的态度。据《纽约时报》近期报道,**Anthropic**曾积极游说梵蒂冈,希望其重新考虑对非人类意识的立场,但似乎收效甚微。 ### 行业背景与影响 AI生成艺术近年来引发广泛争议,艺术家们担忧版权侵犯和创作价值被稀释。教皇的介入为这场辩论增添了道德和哲学维度。尽管梵蒂冈的立场不会直接改变AI技术发展轨迹,但其道德权威可能影响公众认知和政策讨论。 目前,AI公司尚未对教皇的最新言论作出回应。
## Pixel 用户遭遇感应支付失灵,Google 尚未回应 如果你最近几周在用 Pixel 手机刷 Google Wallet 时遇到了尴尬——站在收银台前怎么贴都刷不上,那你并不孤单。自**上个月中旬**以来,Reddit 及多个支持论坛上陆续有用户反馈 Pixel 的**感应支付(tap-to-pay)**出现问题:有人是偶尔失灵,有人则完全无法使用。 更麻烦的是,这个问题往往在你**最需要付款的那一刻**才暴露出来。 ### 问题出在哪? Google Wallet 近年来的功能已经大幅扩展,从驾照、公交卡到保险卡都能装进手机,便利性极高。但一旦感应支付失灵,对依赖它的人来说可能直接影响一整天的安排。 根据用户反馈,问题似乎在于:打开 Google Wallet 后,**部分 Pixel 手机无法识别附近存在 NFC 终端**,因此不会发送完成交易所需的信息。值得注意的是,**Pixel 11 将 NFC 天线位置移到了手机顶部**(此前几代位于中部),但该问题影响范围更广,**从 Pixel 9 系列开始的几乎所有机型**都有用户报告。ZDNET 作者也在自己的 **Pixel 10 Pro** 上遇到了同样的情况。 目前尚不清楚问题出在 Google Wallet 还是设备本身。ZDNET 已联系 Google,但**官方尚未承认该 bug**,因此也没有正式修复方案。 ### 四个可以尝试的修复方法 根据用户报告,以下操作可能让感应支付恢复工作: 1. **重启手机**——虽然排队时重启很不方便,但这是目前看起来**最可靠的修复方式**,多位用户表示重启后感应支付恢复正常。 2. **退回锁屏再重开**——不想重启整台手机的话,有用户反馈关闭 Wallet 应用、回到主屏幕、再重新打开 Wallet 即可解决问题。 3. **清除 Wallet 缓存**——部分用户报告清除 Wallet 应用缓存后问题得到缓解。 4. **检查 NFC 天线位置**——由于 Pixel 11 的 NFC 天线移到了手机顶部,刷机时可能需要调整贴合位置。 ### 这意味着什么? 对于把手机当作主力支付工具的 Pixel 用户来说,这个问题再次提醒我们:**移动支付的可靠性仍然是用户体验的底线**。Google Wallet 生态越做越大,但底层硬件与软件的协同稳定性如果跟不上,便利性反而会变成风险。 在 Google 给出官方修复之前,建议 Pixel 用户出门时**随身带一张实体卡作为备用**,以免在关键时刻陷入无法支付的窘境。

## 一场改名风波,一次忠诚度测试 七十年前,一群科学家在达特茅斯学院提出了一个大胆的设想:机器或许能像人类一样思考。其中一位科学家约翰·麦卡锡为这个新领域取了一个名字:**人工智能**。从此,这个词沿用至今。在谷歌学术上搜索“人工智能”,能返回约 **742万条** 结果。它无处不在,无人不晓。即便对人工智能深恶痛绝的人,最不关心的也是它叫什么。 然而,并非所有人都这么想。不知何故,美国总统**唐纳德·特朗普**对这个词产生了反感。9月23日在联合国演讲时,他暗示可能想要废除“人工智能”这个说法。当时听起来像是虚张声势,毕竟他向来热衷于给海湾、湖泊和艺术中心改名。但重新命名一个研究领域和美国最关键的产业? 本周,在白宫与顶级人工智能领袖的午餐会上,他真的动手了——签署行政命令,宣布“人工智能”成为禁用词,政府将改称其为 **“超级智能”**。显然,总统期望私营部门也跟进。 ### 巨头们的顺从 令人遗憾的是,人工智能的巨头们温顺地默许了。从此,他们大概要被称为 **“超级智能领主”** 了。这不禁让人看作总统的终极权力展示——尽管这些高管拥有万亿美元财富和真正的智慧,但房间里真正的阿尔法,是那个橘皮色的家伙。 改名与约束一项潜在灾难性技术相比,似乎微不足道。但对这群人来说,人工智能远不止几个字母。它是他们的**根基**,他们的**身份**。小时候躲在被窝里读科幻小说时,这个词点燃了他们的想象。他们为人工智能建立或改造公司,过去四年里几乎只谈论这个话题。 然而,当总统利用午餐会赢得他们对这个疯狂想法的认可——推翻70年历史——显然,在座的**杰夫·贝索斯、黄仁勋、达里奥·阿莫代伊、马克·扎克伯格、桑达尔·皮查伊、格雷格·布罗克曼**等人,没有一个人提出异议。 ### 为何集体沉默? 这背后是科技巨头与政治权力之间微妙的博弈。特朗普政府时期,科技行业面临反垄断、内容审核等多重压力。公开反对总统的象征性举动,可能招致更严厉的监管。而顺从改名,看似无关痛痒,实则是对总统权威的认可,也是一种**忠诚度测试**。 更深层看,这反映了人工智能行业在政治面前的脆弱性。尽管技术影响力巨大,但在政策制定者面前,巨头们仍选择明哲保身。改名本身或许不会改变技术发展轨迹,但它象征着一个危险信号:当政治权力可以随意重新定义科学术语,学术自由和产业独立性将面临何种挑战? 这场改名风波,与其说是关于词汇,不如说是关于权力。而科技领袖们的沉默,或许比改名本身更值得深思。
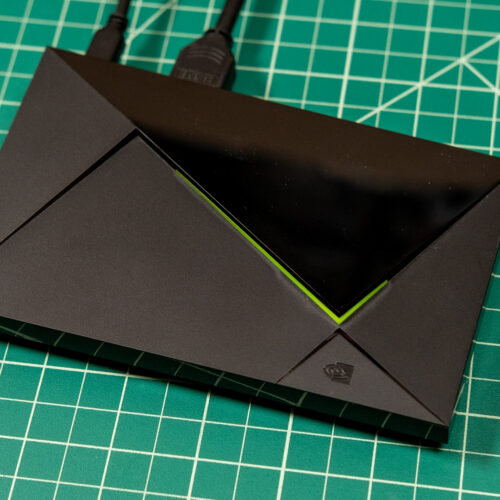
## 一款七年老设备为何逆势涨价? 近日,英伟达旗下 **Shield TV Pro** 的售价悄然上调至 **299.99 美元**,较此前 **199.99 美元** 的定价上涨了 **100 美元**。这款最初于 **2019 年** 发布的流媒体盒子,在生命周期步入第七年时反而变得更贵,这一反常现象背后,是 **AI 浪潮** 对全球芯片供应链的深度重塑。 ### 涨价背后的AI逻辑 Shield TV Pro 搭载的 **Tegra X1+** 芯片,虽然最初为移动设备设计,但其衍生型号如今被广泛应用于 **AI 边缘计算** 和 **汽车智能驾驶** 等领域。随着生成式 AI 爆发,英伟达将大量产能转向 **H100、B200 等数据中心 GPU**,导致边缘计算芯片的供应相对紧张。同时,AI 服务器对 **内存、闪存** 等元器件的需求激增,也推高了 Shield TV Pro 的物料成本。 ### 市场影响与用户选择 对于消费者而言,**299.99 美元** 的 Shield TV Pro 已进入 **Apple TV 4K**(129 美元起)和 **Google TV 设备** 的价格区间,性价比优势被削弱。不过,Shield TV Pro 仍凭借 **AI 画质增强(DLSS 类似技术)**、**GeForce Now 云游戏** 和 **本地 4K 解码** 等特性,在高端流媒体市场占有一席之地。 英伟达尚未对此轮涨价做出官方解释,但业内人士认为,这可能是 **AI 挤压消费级芯片产能** 的又一例证。随着 AI 需求持续高涨,类似“老设备涨价”的现象或将在更多消费电子品类中显现。 ### 小结 - **Shield TV Pro 涨价 100 美元**,现价 299.99 美元。 - 原因指向 **AI 芯片产能倾斜** 和 **元器件成本上升**。 - 消费者需权衡 **AI 功能** 与 **价格涨幅**,竞品性价比凸显。 - 这或许只是 **AI 重塑硬件市场** 的开始。
两年前,大多数公司还没有 **GTM 工程师**这个岗位。如今,这一角色正在科技行业迅速铺开,从业者利用 AI 和自动化搭建过去需要多人、多工具、大量手动流程才能完成的营收系统。Clay 联合创始人兼 CEO **Kareem Amin** 将在 **TechCrunch Disrupt 2026** 的 AI Stage 上,专门探讨这一变化背后的逻辑。 ## 一个几乎不存在的新岗位 Clay 在 **2023 年**提出了“GTM 工程师”这一称谓。根据 Clay 自己的 GTM 工程指南,GTM 工程师的核心工作不是手动执行单个 GTM 任务,而是**构建自动化的营收工作流**。传统 GTM 工作往往包含大量重复劳动:研究客户、清洗数据、筛选线索、准备触达内容,以及在各个系统之间搬运信息。GTM 工程则试图用 AI、数据和自动化,把其中更多环节变成可复用的系统。 Clay 表示,目前每月大约会出现 **100 个 GTM 工程师职位**,招聘方包括 **Cursor、Lovable、Webflow** 等公司。 ## AI 如何重塑 GTM 技术栈 AI 正在给 GTM 团队提供新的手段:研究潜在客户、处理数据、个性化触达,以及自动化那些原本分散在不同工具和团队之间的工作流。当这些能力逐渐融合,公司需要重新思考的不只是 GTM 技术选型,还包括**由谁来构建和管理增长背后的系统**。 Amin 的分享主题是“**The GTM Engineer: How AI Created Tech’s Next Big Job Category**”。他将梳理 AI 如何改变传统的 GTM 技术栈,并催生出新的学科,让参会者看到 AI 原生 GTM 在实践中的样子,以及它如何改变公司增长的方式。 ## 对创始人和 GTM 负责人的意义 对于正在决定下一笔预算投向何处、或者下一次招聘招什么人的创始人和 GTM 负责人来说,这场分享提供了另一种思考增长的方式:是继续增加人手来执行现有流程,还是构建系统,让现有的人以不同的方式执行? 如果你正在创业,或者正在重新思考团队在销售、营销和增长上的做法,这是一个值得了解的新角色。TechCrunch Disrupt 2026 的通行证现已开放注册,第二张票可享 **50% 折扣**,四人及以上团体还有更多优惠。
当生成式AI开始频繁“胡说八道”,餐厅和零售业的一线员工正面临一种新的困境:顾客拿着ChatGPT的答案来推翻专业人士的判断,甚至无视过敏警告。 ## 从“顾客永远是对的”到“ChatGPT永远是对的” “顾客永远是对的”这句老话,正在被生成式AI改写。据The Verge报道,纽约市一家米其林推荐意大利餐厅的服务员Madison(化名)最近经历了一系列令人不安的“险情”。她习惯在每桌客人落座时询问过敏情况,但如今,当有人告知海鲜过敏后,却会无视她的警告,点一道汤底含贝类的鱼料理。原因很简单:**ChatGPT说这道菜不含过敏原**。 “他们只想跟ChatGPT对话,”Madison说,“你对海鲜过敏,ChatGPT说这道菜里没有海鲜,而我们告诉你,有!” 这种冲突不仅限于过敏问题。Madison发现,顾客对生成式AI的依赖正在急剧增加。她多次建议“让我为您叫侍酒师”,却被拒绝:“不用,我问ChatGPT就行。”甚至有侍酒师被客人直接打发走,因为客人更信任AI的推荐。更荒诞的是,有顾客会点名要餐厅根本不卖、甚至**根本不存在的酒款**——这些显然是AI幻觉的产物。 ## 当AI幻觉撞上专业壁垒 Madison的观察揭示了一个深层问题:AI幻觉并非简单地制造错误信息,而是与顾客原有的心理焦虑形成共振。 “有些人一直对侍酒师有抵触,觉得‘这些人就像二手车销售,想让我们花远超预算的钱买酒’,”她说,“也有人会胡思乱想,‘侍酒师肯定觉得我很蠢’。” AI恰好为这些不安提供了一种看似中立、实则可能完全错误的“权威”背书。当ChatGPT给出一个不存在的酒名或错误的过敏原信息时,顾客往往将其视为客观真理,而把真正受过专业训练的服务人员当作推销员。 为了“缓和AI幻觉带来的冲击”,Madison和同事不得不采用话术迂回:“我们的酒单非常特殊,也许它给您显示的是某款法国酒……”这种委婉的纠正,折射出一线服务者在技术冲击下的无奈。 ## 技术傲慢与人的代价 这一现象并非孤例。随着ChatGPT等工具在消费场景中普及,零售、餐饮、客服等行业的一线工作者正面临前所未有的挑战:他们不仅要完成本职工作,还要**纠正顾客从AI那里获得的错误信息**,同时避免冒犯“上帝”。 更令人担忧的是安全风险。在过敏问题上,AI幻觉可能直接危及生命。Madison提到的“险情”并非杞人忧天——如果顾客坚持相信ChatGPT而拒绝服务员的警告,后果可能不堪设想。 从更广的视角看,这反映了AI技术落地时的一个关键矛盾:**当AI的权威被过度放大,人类专业判断的空间就会被挤压**。而修复这种信任错位,需要的不仅是更准确的模型,还有对技术边界的清醒认知。 目前,OpenAI等公司尚未对此类场景作出专门回应。但可以确定的是,在AI幻觉彻底解决之前,“顾客永远是对的”或许会变成“ChatGPT永远是对的”——而这,对谁都不是好消息。
## 当数据中心穿上「自然外衣」 在得克萨斯州圣安东尼奥,市议员 **Ric Galvan** 亲眼见证了数据中心从「看起来像普通办公楼」到「占地数百万平方英尺的超大规模设施」的演变。如今,他所在的约 **55 平方英里**选区内已有超过 **12 个**数据中心,若拟建项目全部落地,未来几年可能逼近 **20 个**。这些设施沿两条主干道聚集,施工时砍树、堵路,运营后灯光常亮、噪音不断,让原本生活在绿地旁的居民感到自然被迅速剥夺。 这并非孤例。全美各地越来越多的社区开始抵制这些庞然大物,担忧它们对生活质量、污染、水资源和电费的影响。科技公司则承诺出资升级当地水电基础设施以缓解矛盾。而 **微软** 正在尝试一种不同的思路——**仿生学(biomimicry)**,让数据中心对社区和环境的冲击变得不那么刺眼。 ## 仿生学不只是「长得像自然」 仿生学是一个宽泛的概念,指技术从自然界汲取灵感,例如模仿蚊子口器设计的「无痛」针头,或参照白蚁丘建造的自然通风建筑。微软将这一理念引入数据中心建设,试图在视觉、噪音和生态层面减少对周边社区的侵扰。 尽管报道未披露具体设计细节,但方向已明确:让数据中心更「融入」而非「突兀」。这背后是科技巨头面临的现实压力——AI 算力需求爆发式增长,数据中心规模与数量激增,社区抵触情绪也随之高涨。 ## 伪装能解决根本矛盾吗? 微软的仿生学尝试,本质上是在「物理存在感」上做减法:如果建筑看起来不那么像工业巨兽,噪音和灯光被自然屏障吸收,居民的直观反感或许会降低。但社区的核心关切——**电力消耗、水资源占用、长期噪音和房价影响**——并不会因为外墙种满绿植就消失。 换言之,仿生学可以改善「观感」,却难以单独化解「资源竞争」的实质冲突。当 AI 数据中心对电力和水的需求持续攀升,地方社区与科技公司之间的博弈,最终仍要回到透明的资源规划、合理的成本分摊和真正的社区参与上。微软的这一步,是姿态,也是试探——它能否成为行业范本,取决于后续是否配以更硬核的可持续承诺。
## 亚马逊罕见强硬表态 亚马逊正在向全美社区传递一个明确信号:**不要阻挡AI数据中心**。否则,美国经济和国家安全的损失将“不可弥补”。 10月2日,AWS CEO **Matt Garman** 发布了一篇超过3000字的博客文章,直接回应公众对数据中心的种种担忧。他的措辞异常强硬——将反对声音部分归因于“错误信息乃至彻头彻尾的谎言”,甚至暗示有外国势力故意在美国散布关于数据中心的虚假信息,目的是让美国“慢下来”。 > “这场建设在地缘政治层面如此重要,以至于有广泛报道显示,多个国家正在有意在美国散布关于数据中心的错误信息,诱使我们减速。” ## 为什么亚马逊急了? 背景很清晰:美国公众对AI数据中心的支持率正在快速下滑。在数据中心密集落地的社区,反对声浪日益高涨。Garman在文中披露了一个关键数字——**全美目前有超过100个数据中心禁令正在被审议**。 “如果这些措施被通过,美国可能是在给自己写一张输掉这场竞赛的票,后果将持续几代人。” 这种焦虑并非空穴来风。数据中心带来的电力需求激增、水资源消耗、噪音污染以及就业拉动不及预期等问题,正在让越来越多的地方政府和居民站到对立面。AI安全和社会影响的担忧也在全国范围内升温。 ## 亚马逊开出了什么条件? 为了缓和矛盾,亚马逊在文中提出了一套“**数据中心承诺**”(Data Center Commitment),核心内容包括: - **创造就业**:承诺为当地社区提供工作岗位 - **控制电价**:防止数据中心推高居民能源费率 - **社区投资**:承诺投入超过**10亿美元**支持数据中心周边社区 此外,亚马逊还宣布不再与政府机构签署保密协议(NDA)。这一转变的直接导火索是民主党议员**Jamie Raskin**此前对科技公司与地方官员秘密交易的调查。 ## 一场刚刚开始的拉锯战 亚马逊这篇博客的本质,是一场面向公众的**舆论防御战**。它试图将反对数据中心的声音重新框定为“被误导的”甚至“被操纵的”,从而为AI基础设施的快速扩张争取政治空间。 但问题在于,社区反对的核心诉求——电价、水资源、土地使用和生活质量——并不会因为一篇博客而消失。当AI竞赛的宏大叙事与地方居民的实际利益发生碰撞时,亚马逊们需要的不只是公关文章,而是真正可验证的社区契约。 这场围绕AI基础设施的博弈,才刚刚开始。

## 当 AI 工具自身成为攻击目标 过去一年,关于 AI 代理自主入侵网站、网络犯罪分子滥用 AI 工具的报道层出不穷。但 Objective-See Foundation 最新披露的一个 macOS 版 **ChatGPT** 应用漏洞,揭示了一个常被忽视的事实:**AI 软件本身就是一个极具吸引力的攻击目标**。 这个已被 OpenAI 修复的漏洞,可能允许攻击者完全接管受害者电脑上的 ChatGPT 应用,进而获取该应用存储的所有聊天记录及其他数据,甚至波及浏览器会话等互连资源。 ## 漏洞原理:三层签名验证被绕过 ChatGPT macOS 应用包含多个组件,它们通过数字签名检查来安全通信。设计思路是确认发起请求的双方都是 OpenAI 组件,而非外部恶意软件。系统甚至要求在请求的三层关联上都进行签名验证,以防恶意软件通过代理方式发出看似可信的请求。 但研究人员发现,一个受信任的脚本解释器组件会接受不受信任的脚本(即命令列表),并可被操纵将该脚本传递到 ChatGPT 主进程中。 > "他们检查了进程的父级和祖父级,但恶意脚本只需三次启动脚本解释器,然后发出请求,就能满足所有要求。" —— Objective-See Foundation 软件分析师 **Patrick Wardle** Wardle 是长期研究 macOS 安全的专家,他将 AI 代理比作"拥有所有房间钥匙的楼宇管理员":"代理需要大量访问权限才能完成工作。如果它们被破坏或颠覆,问题就非常严重,可能意味着无特权代码也能访问所有资源。" ## 为什么这件事值得关注 这一漏洞凸显了 AI 平台为正常工作而获得的深层系统访问权限与信任——以及由此带来的巨大风险。随着 AI 应用日益普及,攻击者通过攻破 AI 软件本身获取的价值正在上升。 OpenAI 已于 **9 月 25 日**在系统变更日志中公开确认该安全漏洞及修复。OpenAI 发言人 **Shane Bauer** 在给 WIRED 的声明中表示:"我们持续改进安全实践,但也认识到需要更快行动。" 目前尚无证据表明该漏洞已被实际利用,但这一事件提醒我们:在关注 AI 攻击能力的同时,AI 工具自身的安全防线同样不容忽视。
## Suno 把「说话」也做成了生成式音频 以 AI 音乐生成起家的 **Suno** 正在把能力边界从旋律扩展到人声。官方宣布,新功能 **Speech** 已在 Suno 的网页端和移动端开启公开测试,用户可以通过脚本或提示词描述来生成语音旁白,并且能够**同时生成背景音乐**,把语音与配乐合成为一条连贯的音轨。 Suno 首席产品官 **Jack Brody** 在公告中表示:「音乐永远是 Suno 的核心,也是我们所构建之物的核心。与此同时,我们的愿景一直延伸到其他形式的人类表达。今天我们通过 Speech 扩展 Suno 的可能性:这是首个把语音与音乐作为一条完整音轨一起生成的音频模型。」 ## 两种模式,先描述还是先写稿 使用路径并不复杂:进入 **Create** 标签页,找到 Speech 选项即可。它提供两种模式: - **Simple(简单模式)**:在提示框中描述你想要的效果,例如「一位海盗船长在鼓舞船员」。 - **Advanced(高级模式)**:如果你已经明确知道要说什么,可以直接填入自定义脚本。 高级设置还允许调整 AI 声音的**性别**、**语音风格**,以及对其他参数的进一步控制。背景音乐是可选的——如果你只想要干净的人声,可以用开关关掉配乐。Suno 给出的典型场景是:为诗歌配一段平静的配乐,或为戏剧化旁白、鼓舞人心的演讲配上更有能量的声音。 ## 语音合成早已拥挤,Suno 的差异在哪 AI 生成语音并不新鲜。**DeepMind** 在深度学习语音合成上已经摸索了十年,**Adobe** 有文本转语音工具,**ElevenLabs** 自 2023 年推出以来也成为这一领域最具辨识度的平台之一。Suno 此时入场,更像是一次平台能力的横向扩张。 它的差异化在于「语音 + 音乐一起生成」。多数文本转语音工具解决的是「把字念出来」,而 Suno 试图解决的是一条完整音轨的听感问题:旁白和配乐不再分两次制作、再在后期里对齐,而是在同一次生成中完成。对于短内容创作者、播客片头、有声内容试水者来说,这种一体化流程可能比单纯的音色质量更有吸引力。 ## 为什么 Suno 需要新故事 值得注意的是,Suno 的音乐生成器一路走来伴随着**大量诉讼**,版权争议始终是悬在其商业模式上的阴影。在这种背景下,Speech 既是产品线的自然延伸,也可能是一种风险分散:当音乐生成面临法律与授权不确定性时,语音旁白、企业配音、有声读物等场景的商业路径相对更清晰,也更容易与现有内容工作流衔接。 当然,Speech 目前仍处于公开测试阶段,实际音质、情感表现、多语言支持深度以及版权归属规则,都还需要在更大规模的使用中检验。Suno 能否把「音乐公司」的标签扩展为「音频生成平台」,这一步只是开始。

美国最大医院连锁HCA与Palantir合作开发的AI排班工具Timpani,本应优化护士调度,却因频繁出错、忽视员工偏好、导致人手不足,引发护士群体强烈不满。一线护士警告,这不仅加剧职业倦怠,更可能危及患者安全。 ## 当AI接管排班:护士的噩梦 在佛罗里达州,重症监护护士**Amber Retzloff**过去四个月申请了50个特定的12小时班次,但超过一半被Palantir支持的排班软件分配到了其他时间。她经常被安排连续三天上班,身心俱疲。Retzloff表示,这款工具在尊重个人偏好方面远不如以前手动排班的管理者。 她的经历并非个例。自2023年起,**HCA Healthcare**——美国最大的医院连锁——在约130家医院部署了与Palantir共同开发的AI排班工具**Timpani**。五位来自不同地点的护士向WIRED证实,他们对Timpani同样不满。Reddit上也有自称HCA员工的人抱怨该工具。 ## 安全隐患与职业倦怠 护士们指出,Timpani在几乎没有监督的情况下运行,经常导致班次人手不足或经验丰富的资深护士不够,尤其在周日。它还频繁忽略护士对轮班间隔、夜班周末班偏好或特定休息日的请求。结果,护士不得不花更多时间换班或申诉排班,同时越来越多同事选择请病假或休带薪假来逃避任务——尽管这样做超过几次就可能被解雇。 34岁的Retzloff是全国护士联合会工会领袖,有十年床边经验。她回忆最近某班次,四名同事全是新手,作为唯一资深护士,她不得不推迟最危重患者的护理,先指导新手处理轻症。“HCA让AI做主,”Retzloff说,“我们用一款应用覆盖了临床判断和医疗中人与人之间的关怀。” ## 手工排班 vs. AI排班 此前,管理者手动排班,通常会提前与护士协商。而现在,护士们认为AI缺乏灵活性,无法应对复杂的临床需求。HCA和Palantir尚未公开回应这些指控。 随着AI在医疗领域的渗透,Timpani的争议凸显了一个核心问题:算法效率与人文关怀如何平衡?当排班软件只追求优化指标,却忽视了一线人员的实际体验和患者安全,技术便可能成为负担。
## 当供应链遇上机器学习 供应链的运转,本质上是一场关于时间的博弈。原材料从供应商到工厂,成品从仓库到客户,每一个环节的运输时间都会层层传导,最终影响交付承诺、库存水位和客户满意度。arXiv 上最新收录的一篇论文(arXiv:2609.38190)就把目光投向了这个看似传统、实则棘手的命题:**如何用机器学习和深度学习,更准确地预测供应链中的运输时间**。 论文作者 Balaji Venkateswaran 在摘要中直言,供应链生态系统极其复杂,高度依赖原材料和成品的运输与物流。准确的运输时间估计之所以关键,是因为它能帮助供应链各方**提升物流一致性和整体表现**——从计划排程、需求预测,到前置期管理和装配计划,都建立在对时间较为可靠的判断之上。 ## 为什么运输时间预测仍然是个难题 在传统供应链管理中,运输时间往往依赖历史平均、承运商承诺或人工经验来估算。这类方法在稳定环境下尚可应付,但一旦遇到天气波动、港口拥堵、运力紧张或突发中断,误差就会被迅速放大。 论文指出,配送侧的物流同样直接影响**客户满意度**和“客户之声”。换句话说,运输时间预测不只是内部效率问题,它最终会体现在终端体验上。 作者的研究路径是:收集大量历史数据,并采用较新的建模技术,构建一个能够预测库存运输时间的模型。论文篇幅达 **50 页**,包含 **24 张图**和 **8 张表**,从体量上看,作者在数据探索和模型验证上投入了相当的工作量。 ## 这项研究的价值与边界 从行业背景看,将机器学习用于物流时间预测并不算全新概念。近年来,越来越多企业尝试用梯度提升、循环神经网络或图神经网络来建模运输网络。这篇论文的贡献在于,它把问题明确锚定在供应链管理语境下,并强调数据驱动方法对计划、预测和前置期管理的支撑作用。 需要指出的是,目前公开的摘要并未披露具体使用了哪些模型架构、数据来源、预测精度指标或对比基线。因此,**这篇论文的实际效果仍有待全文细节验证**。50 页的篇幅和 24 张图表暗示了较丰富的实验内容,但在缺乏具体数字的情况下,不宜对其性能表现做过度推断。 ## 值得关注的方向 对供应链从业者和 AI 研究者而言,这项工作的意义可能体现在几个层面: - **数据层面**:如何整合多源历史数据,处理缺失和噪声,是运输时间预测的基础难题; - **模型层面**:机器学习与深度学习在不同运输场景下的适用性差异,值得进一步比较; - **落地层面**:预测结果如何嵌入计划系统和前置期管理流程,决定其真实价值。 如果后续全文能够公开更详细的实验设计和误差指标,这篇论文或可为供应链运输时间预测提供一个可参考的方法框架。在此之前,它更像是一个明确的问题声明:**在复杂供应链中,时间预测值得用更精细的 AI 方法来重新审视**。
## 决策树的困境:可解释性与可扩展性难以兼得 决策树因结构直观、可解释性强,长期被视为高风险场景下最可信的模型之一。但它有一个长期未解的痛点:**当数据规模变大、特征连续、树需要更深时,训练就变得极其困难**。 现有方法大致分成两条路线,各有短板: - **全局最优方法**:能保证最优性,但通常受限于二值特征选择,且只能处理较浅的树,规模一大就崩。 - **传统启发式方法**:速度快、可扩展,但往往牺牲预测精度。 来自 arXiv 的最新论文 **《A Moving-Horizon Approximate Branch-and-Reduce Method for Deep Classification Trees》**(arXiv:2609.38194,已被 Transactions on Machine Learning Research 收录)试图同时突破这两个瓶颈。 ## 核心思路:分层优化 + 移动视界 作者提出了一种 **移动视界近似分支归约方法(moving-horizon approximate branch-and-reduce)**,用于在大规模连续特征数据集上训练**近最优的深度分类树**。 其技术骨架可以拆成三层: 1. **分层根-子树优化框架**:把整棵树的训练拆解为根节点问题和子树问题。 2. **根层用分支归约**:根层问题通过 branch-and-reduce 精确求解。 3. **子树用贪心近似**:由根层决策引出的子树问题,改用贪心启发式近似处理。 这一近似并非随意为之——论文将其类比为强化学习中的 **lookahead rollout(前瞻展开)**。虽然底层框架理论上具备全局最优性保证,但正是这种近似,让方法在深层结构上获得了显著的效率提升。 在此基础上,作者引入 **低成本移动视界策略**,对模型精度进行迭代式精修。 ## 实测表现 论文给出的数值实验结论清晰: - 在**测试精度**上超过现有启发式基线; - 在**可扩展性**上——无论是数据集规模还是树深度——都明显优于全局最优求解器。 ## 为什么值得关注 在深度模型主导的当下,决策树的价值并未消失,反而在需要**审计、合规、可解释**的场景中愈发重要。这项工作的意义在于:它尝试把「全局最优」的严谨性和「启发式」的工程可扩展性接在一起,而不必二选一。 不过需要注意,论文目前公开的是摘要与元数据,具体的复杂度分析、实验数据集构成和精度提升幅度,仍需查阅全文才能判断。对于关心可解释机器学习与大规模优化的研究者,这篇论文提供了一个值得跟进的方向。
## 当界面问题遇上神经算子 在流体力学、材料科学和计算机图形学中,追踪两种介质之间的**界面**(如气泡表面、激波锋面)是一个经典难题。传统上依赖数值求解器一步步推进时间步,计算昂贵;而近年来兴起的**神经算子**(Neural Operator)试图直接学习从初始界面到整个时空轨迹的映射,却面临一个尴尬的困境:训练数据必须由他们想要取代的求解器生成。 arXiv 最新论文 **《A Data-Free Physics-Informed Neural Operator for Level-Set Interface Advection》** 提出了一种彻底摆脱参考解的方案。作者 **Muhammad Akbar Khan** 构建了一个**无数据物理信息神经算子**,仅利用物理定律本身来训练。 ## 核心思路:让物理定律当老师 该方法的关键在于,将界面视为方程的唯一未知量,算子学习的是从初始界面到完整时空演化的映射。训练时只使用**输运残差**(transport residual)和**几何约束**(eikonal 约束,即水平集梯度模为 1),完全不引入任何参考解。 架构上,作者采用**时空傅里叶骨干网络**(spacetime Fourier backbone),一次前向传播即可输出整个轨迹。更巧妙的是,初始条件通过**构造方式**硬性嵌入,而非作为惩罚项加入损失函数,从而消除了无数据时锚定项与残差项之间的竞争。 ## 性能对比:代价与收益 研究者在两个标准基准上对比了无数据算子、纯监督算子和混合算子(使用少量参考解): - **反向单涡测试**:无数据算子相对 L2 误差为 **1.614 ± 0.067%**,监督基线为 **0.369 ± 0.035%**,差距约 **4.4 倍**。 - **刚体旋转测试**:无数据算子误差 **3.804 ± 1.075%**,监督基线 **2.576 ± 0.159%**,差距约 **1.5 倍**。 有趣的是,两个基准对方法的排名并不一致。作者将差异归因于 **eikonal 约束**:在旋转流场中,精确解仅在 **0.3%** 的区域违反 |∇φ|=1,而在涡流中这一比例高达 **86.9%**。当约束有效时,物理训练算子虽然场误差更大,但**封闭面积守恒性比监督基线好 2.7 倍**。此外,混合方案仅用 **8 个参考解**就超越了使用 **16 个参考解**的纯监督方案。 ## 意义与展望 这项工作为**科学机器学习**提供了一个重要视角:当标注数据稀缺或获取成本极高时,物理约束可以成为有效的替代监督信号。尽管在复杂流场中精度仍有差距,但面积守恒等物理性质的提升表明,无数据训练在保持物理一致性方面具有独特优势。未来,如何自适应地平衡物理约束与数据驱动,或许是神经算子走向实用的关键。
## 当极端值绑架了预测结果 时间序列预测在金融、气象、供应链和公共卫生等领域都是核心能力。传统集成方法通过组合多个模型的输出来提升稳健性,但一个长期被忽视的问题始终存在:**极端预测值会不成比例地拉偏最终结果**。一个模型如果偶然给出一个离谱的高值或低值,整个集成的可信度就可能被拖垮。 来自 arXiv 的最新论文 **Conformal Adversarial Generative Ensemble(CAGE)** 提出了一套新框架,试图从机制上解决这一问题。该研究已发表于 ICONIP 2024,收录于 Springer LNCS 第 15287 卷。 ## CAGE 的三层结构 CAGE 的设计思路可以拆解为三个相互配合的组件: - **生成层**:多个生成模型分别产出初始预测,提供多样化的候选结果; - **判别层**:引入对抗式判别机制,对每个预测的可信度进行评估; - **共形预测层**:这是 CAGE 的核心创新。通过计算非一致性分数(nonconformity scores)导出 **p 值**,再据此动态调整各模型的权重。 换句话说,CAGE 不是简单地平均或投票,而是用统计检验的方式判断“这个预测值是否值得信任”,然后让可信度高的预测获得更大话语权。不可靠的预测会被自动降权,极端异常值的影响因此被显著压缩。 ## 两个数据集上的验证 研究团队选择了两个差异明显的真实数据集进行测试: 1. **新西兰牛奶收集量数据**——典型的农业供应链时间序列,具有季节性和波动性; 2. **全球猴痘公共卫生数据**(来自公开的 owid-monkeypox 数据集)——事件驱动型数据,噪声和突发峰值更为突出。 实验和统计分析表明,CAGE 在处理**离群值和噪声数据**时明显优于传统集成方法。论文作者刻意选择两个不同领域的数据集,正是为了说明该方法的通用性——它不绑定于某一类时间序列,而是可以迁移到金融、天气、供应链管理等多种场景。 ## 为什么值得关注 时间序列预测的集成方法并不新鲜,但把**共形预测**引入权重调整环节,是一个相对少见的组合。共形预测本身提供的是带有统计保证的不确定性量化,这意味着 CAGE 输出的不仅是预测值,还隐含了“这个值有多可信”的统计信号。 对于需要基于预测做决策的场景——比如库存调度、疫情预警或能源负荷管理——这种带统计严谨性的输出,比单纯的数值精度更有实际价值。论文将其定位为“准确且统计上严谨的预测”,这一表述也指向了当前预测系统的一个关键短板:**不是预测得不够准,而是不知道什么时候不该信**。 目前 CAGE 的验证规模仍限于两个数据集,其在更大规模、更高维度时间序列上的表现还有待进一步检验。但作为一个融合生成建模、对抗判别与共形预测的框架,它为集成预测的可靠性问题提供了一个有新意的解题方向。
## 当语言模型开始「读懂」K线 金融时间序列预测一直面临一个尴尬的现实:价格数据本身是连续、低信噪比的数值流,而真正驱动市场波动的新闻、公告、宏观事件却是离散的文本。传统模型要么只吃数字,要么把文本当作外挂特征,很难让两者在同一套表征空间里协同工作。 arXiv 上最新提交的论文 **DualCast** 提出了一种双路径框架,试图用「冻结的大语言模型 + 离散金融词表」来统一这两类信号。作者来自 Wentao Zhao、Hongqiang Wu、Shanghang Liu、Zhaochen Zan、Yu Zhang、Biqing Huang 等人,论文编号 arXiv:2609.38197,归类于 cs.LG 与 cs.AI。 ## 把收益率「切块」成 token DualCast 的核心设计是把每个对数收益率片段(patch)编码为 **一个学习到的摘要 token 加三个残差形状 token**。这种表示既保留了局部的漂移与波动率信息,又让形态模式可以在不同资产之间共享——换句话说,股票和能源期货的「走势形状」可以被同一套词表复用。 为了让这套离散词表不塌缩成少数几个高频 token,研究团队还设计了 **自适应频率均衡残差向量量化**(adaptive frequency-equalizing residual vector quantization),在不牺牲重建精度的前提下重新平衡过载的码字。 ## 快路径与慢路径的分工 整个框架分成两条路径: - **快路径(fast path)**:在冻结的 **Qwen3-8B** 骨干上,只训练新增的金融 token 嵌入和输出头,快速给出一个纯数值预测。 - **慢路径(slow path)**:通过一个可开关的 **LoRA 适配器**,以快路径的预测和预测时点可获得的新闻为条件,输出修正后的预测。 慢路径的「修正器」先经过监督微调初始化,再用 **收益空间群组相对策略优化**(return-space group relative policy optimization)进一步优化,奖励信号直接来自「比快路径预测得更准」。 ## 零样本评测:12 个设定中 8 个最优 在覆盖股票与能源价格、时间粒度包括 **5 分钟、日频、周频** 的零样本评测中,慢路径在 **12 个数据集-预测跨度设定里有 8 个取得最低的平均绝对百分比误差(MAPE)**,其中包括所有最长跨度的设定。 新闻消融实验显示,在大多数测试设定中引入新闻都能带来额外增益,但增益幅度因市场而异——这意味着文本信号的价值并非在所有市场、所有频率上都稳定。 ## 这意味着什么 DualCast 的思路是把「快速数值预测」和「可选文本修正」解耦:基础预测不依赖新闻也能跑,新闻只在能提供增量信息时才介入。这种设计对实际部署比较友好——新闻管道断掉时,快路径仍然可用。 不过需要注意,论文目前是 arXiv 预印本,尚未经过同行评审;新闻增益在不同市场间的波动也提示,文本条件修正的泛化能力仍需更多验证。 对于关注「LLM 能否真正理解金融时序」这一问题的读者来说,DualCast 提供了一个值得跟踪的方向:不是让语言模型直接预测价格,而是让它学会一套金融离散词表,再在这个空间里做条件修正。