
在语音识别领域,OpenAI的Whisper模型长期占据主导地位,但一家仅有六人团队的小型初创公司却带来了令人惊喜的突破。Moonshine Voice近日发布了其开源语音识别工具包,不仅声称在准确率上超越了Whisper Large V3,还提供了从26MB到高性能的多种模型选择,为开发者带来了全新的实时语音应用解决方案。 ## 事件背景 语音识别技术近年来快速发展,OpenAI的Whisper系列模型因其出色的性能和开源特性,成为了行业标杆。然而,Whisper模型在实时流式处理、设备端部署和隐私保护方面仍存在一定局限。正是在这样的背景下,Moonshine团队凭借有限的资源——**六人团队和每月不到10万美元的GPU预算**,开发出了这套全新的语音识别解决方案。 Moonshine Voice的诞生反映了AI领域的一个重要趋势:小型团队通过技术创新,能够在特定领域挑战行业巨头。这种开源、轻量化的解决方案,特别适合对**隐私保护、低延迟和跨平台兼容性**有高要求的应用场景。 ## 核心内容 Moonshine Voice的核心优势体现在多个方面。首先,在性能指标上,该团队声称其顶级模型的**词错误率(WER)低于Whisper Large V3**,这意味着更高的识别准确率。这一成就尤其值得关注,因为Moonshine的模型完全是从头开始训练的,基于团队自己的前沿研究成果。 其次,Moonshine提供了丰富的模型选择,从**仅26MB的微型模型**到高性能版本,覆盖了从资源受限的物联网设备到高性能服务器的各种部署场景。这种灵活性使得开发者可以根据具体需求选择最合适的模型,在性能和资源消耗之间找到最佳平衡点。 技术架构方面,Moonshine Voice专为实时流式应用优化,能够在用户说话的同时进行处理,实现**低延迟响应**。所有计算都在设备端完成,无需云端传输,这不仅提高了速度,还确保了用户隐私和数据安全。 ## 行业影响 Moonshine Voice的发布对语音识别行业可能产生深远影响。首先,它打破了Whisper在开源语音识别领域的垄断地位,为开发者提供了更多选择。这种竞争将推动整个行业的技术进步和创新加速。 其次,Moonshine的跨平台兼容性值得关注。该库支持**Python、iOS、Android、macOS、Linux、Windows、树莓派、物联网设备和可穿戴设备**,几乎覆盖了所有主流平台。这种广泛的兼容性降低了开发门槛,使更多开发者能够轻松集成语音功能到他们的应用中。 在功能层面,Moonshine提供了完整的解决方案,包括: - **实时转录**:支持麦克风输入和实时文本输出 - **说话人识别**:能够区分不同说话者的语音 - **意图识别**:通过语义匹配识别自然语言命令 这些高级API使得即使没有语音识别专业知识的开发者,也能快速构建功能丰富的语音应用。 ## 总结与展望 Moonshine Voice的发布标志着开源语音识别领域进入了新的发展阶段。虽然来自小型团队,但其技术实力不容小觑——在准确率上挑战行业标杆,在部署灵活性上提供更多选择,在隐私保护上坚持设备端计算原则。 展望未来,Moonshine的发展将面临多重挑战和机遇。一方面,作为初创公司,需要持续投入研发以保持技术领先;另一方面,其开源模式有助于建立开发者社区,加速生态建设。随着多语言支持的不断完善——目前包括**英语、西班牙语、普通话、日语、韩语、越南语、乌克兰语和阿拉伯语**,Moonshine有望在全球范围内获得更广泛的应用。 对于开发者而言,现在正是探索Moonshine Voice的好时机。无论是构建实时语音助手、智能家居控制,还是开发跨平台的语音应用,这个开源工具包都提供了强大的技术基础。随着AI技术的不断演进,像Moonshine这样的创新项目,将继续推动整个行业向着更加开放、高效和隐私友好的方向发展。
美国国防部与AI公司Anthropic之间的对峙正进入关键时刻。五角大楼要求Anthropic在周五前放宽其AI模型的防护限制,否则将面临被列为“供应链风险”或依据《国防生产法》强制执行的后果。这场争议不仅关乎一家公司的商业决策,更触及了政府权力边界、科技伦理与国家安全之间的复杂平衡。 ## 事件背景 Anthropic作为一家以安全为导向的AI公司,长期以来明确表示其技术不得用于**大规模监控美国公民**或**全自主武器系统**。这一立场源于公司对AI伦理的坚定承诺,也是其区别于其他AI厂商的核心价值观。然而,五角大楼认为,军事技术的使用应由**美国法律和宪法限制**来规范,而非私营承包商的使用政策。这种理念冲突在近期会议上激化,国防部长皮特·赫格斯直接向Anthropic CEO达里奥·阿莫代下达最后通牒。 ## 核心内容 五角大楼给出的两个选项极具威慑力:一是将Anthropic列为**“供应链风险”**,这一标签通常只用于外国对手;二是援引**《国防生产法》**,强制公司为军方定制AI模型。该法案赋予总统在国防需要时命令企业优先或扩大生产的权力,曾在COVID-19疫情期间用于强制通用汽车、3M等公司生产呼吸机和口罩。 - **Anthropic的坚守**:公司拒绝在监控和自主武器问题上妥协,坚持其AI防护原则 - **政府的立场**:军方认为技术使用应受法律而非企业政策约束 - **法律工具的应用**:若动用《国防生产法》解决AI防护争议,将是该法现代应用的重大扩展 ## 行业影响 这场争端凸显了AI行业面临的深层挑战。美国创新基金会高级研究员、前特朗普政府AI政策高级顾问迪恩·鲍尔指出,此举反映了**行政分支不稳定性**的扩大趋势。他表示:“这基本上等于政府说,‘如果你在政治上与我们意见不合,我们就试图让你倒闭。’” 对AI行业而言,此事件可能产生多重影响: - **投资者信心**:国防科技领域的供应商依赖性和政府干预风险将重新评估 - **企业自主权**:科技公司在国家安全需求与伦理原则之间的平衡空间受到挤压 - **监管先例**:政府如何定义和行使对AI技术的控制权将形成重要判例 ## 总结与展望 Anthropic与五角大楼的对峙不仅是商业合同纠纷,更是**AI治理范式**的早期测试。随着AI技术日益融入国家安全体系,政府与科技公司之间的权力动态正在重塑。这场争议的结果将影响未来AI公司在国防领域的参与方式,也可能催生更明确的法规框架来界定技术伦理与国家利益的边界。在AI加速发展的时代,如何平衡创新自主、伦理责任与国家安全,将成为全球科技政策的核心议题。
近日,OpenAI与美国政府及身份验证软件公司Persona合作开发的身份监控系统引发广泛关注。这一事件不仅揭示了AI技术在身份识别领域的深度应用,也引发了关于隐私保护与国家安全之间平衡的激烈讨论。随着Discord等平台宣布与Persona切断合作,这一话题迅速成为科技圈的热点。 ## 事件背景 身份验证技术一直是数字安全领域的关键环节,而AI的介入使其效率和准确性大幅提升。Persona作为一家专注于身份验证的软件公司,此前已与多家科技平台合作,提供用户身份核验服务。然而,当OpenAI与美国政府加入这一合作,共同构建身份监控系统时,事件的复杂性骤然升级。这标志着AI技术从单纯的工具性应用,转向了可能涉及大规模数据收集和监控的领域,引发了公众对隐私泄露的担忧。 ## 核心内容 根据相关资讯,这一合作旨在利用**OpenAI的先进AI模型**和**Persona的身份验证技术**,结合美国政府的监管需求,打造一个高效的身份监控系统。系统可能涉及以下核心功能: - **实时身份识别**:通过AI分析用户数据,快速验证身份信息。 - **行为模式监控**:追踪用户在线活动,识别异常或可疑行为。 - **数据整合分析**:将多平台数据聚合,形成全面的用户画像。 然而,这一合作也带来了显著争议。Discord等平台已宣布**切断与Persona的合作关系**,部分原因是担心用户隐私受到侵犯。在Hacker News等社区,相关讨论已积累数百条评论,焦点集中在监控过度、数据滥用风险以及AI伦理问题上。 ## 行业影响 这一事件对AI行业产生了深远影响。首先,它凸显了**AI技术在监控领域的应用潜力**,可能推动更多政府和企业探索类似合作。其次,隐私保护问题被推向前台,促使科技公司重新评估数据使用政策。例如,Discord的退出行动可能引发连锁反应,其他平台或效仿以维护用户信任。 从行业趋势看,AI与身份验证的结合本是创新方向,但监控元素的加入改变了其性质。未来,监管框架可能需要调整,以平衡技术创新与个人权利。同时,这也为竞争对手提供了机会,那些强调隐私保护的AI解决方案可能获得更多市场青睐。 ## 总结与展望 OpenAI、美国政府与Persona的合作,是AI技术发展中的一个重要节点。它展示了AI在提升安全效率方面的价值,但也暴露了隐私风险的严峻挑战。展望未来,行业需在以下方面加强努力: - **透明化操作**:公开系统工作原理和数据使用范围,减少公众疑虑。 - **伦理规范制定**:建立AI监控的伦理准则,防止滥用。 - **技术优化**:开发更注重隐私保护的AI模型,如差分隐私技术。 总体而言,这一事件提醒我们,AI的进步必须伴随责任与监管。只有通过多方协作,才能确保技术造福社会,而非成为监控工具。
六年前,麻省理工学院(MIT)推出的《计算机科学教育的缺失学期》课程在技术社区引发热烈讨论,填补了传统CS教育中工具技能教学的空白。如今,这门经典课程在2026年迎来全面修订,不仅更新了核心内容,更将AI赋能工具和工作流深度融入教学,为新一代开发者提供更贴近实战的技能培训。 ## 课程背景 《计算机科学教育的缺失学期》最初于2020年推出,旨在解决计算机科学教育中一个长期被忽视的问题:**工具熟练度**。传统CS课程专注于算法、操作系统、机器学习等高级主题,却很少系统教授学生如何高效使用命令行、文本编辑器、版本控制系统等日常开发工具。学生们在学习和职业生涯中会花费数百甚至数千小时使用这些工具,但往往只能靠自己摸索,效率低下。 该课程一经推出,就在Hacker News等技术社区获得广泛关注和讨论,成为自学编程者和在校学生的重要学习资源。六年后,课程团队重返MIT,基于技术生态的变化和AI工具的兴起,对课程内容进行了全面修订和升级。 ## 核心内容更新 2026版课程保留了原有的核心框架,涵盖**命令行环境、开发工具、调试分析、版本控制、代码打包**等基础技能模块,同时进行了重要更新: - **深度融入AI工具**:课程没有设置单独的AI讲座,而是将最新的AI工具和技术直接整合到每个主题中。例如在“代理式编程”讲座中,会探讨如何利用AI辅助工具提升编码效率;在开发环境配置中,会介绍AI增强的代码补全和调试工具。 - **强调AI工具的正确使用**:课程特别关注如何**恰当使用AI工具并了解其局限性**,避免过度依赖或误用。讲师们认为,当开发者对AI工具的优缺点有清晰认识时,这些工具能为CS从业者带来显著效益。 - **更新实战案例**:所有讲座都根据2026年的技术栈进行了更新,确保学生学到的是当前行业最实用的技能和工作流。 课程为期9天,从1月12日持续到1月23日,每天一个主题,内容紧凑实用。所有讲座视频都已在YouTube上公开,并提供了Discord社区供学习者讨论交流。 ## 行业影响与意义 这门课程的修订反映了AI时代软件开发教育的演进方向。随着**AI增强工具**在工作流中的普及,开发者不仅需要掌握传统工具技能,还要学会如何与AI协作,提升整体生产力。课程将AI工具教学融入每个环节的做法,体现了“AI作为跨功能使能技术”的理念,避免了将AI孤立为独立模块,而是强调其在具体开发场景中的应用。 对于教育机构而言,这门课程提供了一个重要参考:如何在保持CS核心理论教学的同时,及时纳入前沿工具和实践技能。对于自学者和在职开发者,这门课程提供了系统提升工具熟练度的路径,特别是在AI工具快速发展的背景下,帮助开发者建立正确的工作方法和思维模式。 ## 总结与展望 《计算机科学教育的缺失学期》2026版的回归,不仅是一次课程内容的更新,更是对AI时代开发者技能需求的积极响应。它延续了“填补教育空白”的初衷,同时与时俱进地融入了**AI赋能工具**的教学,使课程更加贴合现代软件开发的现实需求。 随着AI技术在开发领域的深入应用,类似的工具技能课程将变得越来越重要。MIT课程团队将课程资源开源共享的做法,也体现了技术教育的开放精神,让全球的学习者都能受益。未来,我们期待看到更多教育机构关注工具技能和AI协作能力的培养,为软件行业输送更多既懂理论又擅实践的复合型人才。

关于教育的讨论常被框定为传统方式与 AI 方式的对立,但 AI 教育技术往往只是放大了传统学校的同样问题。 ## 反对量化 作为一群部分依靠在线资源在家上学的家长,我们与一位教育科技创业者会面。我们的孩子每天已经花时间在数学应用、阅读应用和 Zoom 课程上。一位家长提议:“我想要一个仪表盘来追踪孩子学到了什么,他们在不同领域的能力水平。” “我完全不想要那个,”我丈夫 Jeremy 反驳道。尽管我们接受了屏幕的使用,但我们不想量化我们的孩子。我们对她的目标更加全面。外人可能以为我们会更关心量化,因为 Jeremy 和我都从事数据和机器学习工作,经常使用 AI。但我个人和研究都深知过度强调指标的危害。并非所有重要的事情都能或应该被量化。 我们更关心她是否能完全沉浸在喜欢的活动中。她会花数小时躺在客厅地毯上,放不下一本激动人心的小说;她会在调试代码时无法抽身;她在数字艺术、纸艺和陶艺时全神贯注。我们一家人会就科学和历史进行有趣的讨论,她与各种朋友和导师建立了深厚的关系。 ## 分解成细碎技能 在美国最流行的语言艺术课程中,3 到 6 年级学生全年不读一部长篇小说。因为阅读不再关乎悬念故事、迷人角色或沉浸其中的虚拟世界。相反,阅读被简化为一系列离散任务:解码单词、总结、推理、识别主旨。这些技能可以通过短篇段落独立测试,脱离阅读真实书籍的上下文。这些短篇段落可以编入“基础读本”,对教科书公司更有利可图。 越来越少的孩子在课余时间独立阅读。从 2012 年到 2022 年,几乎每天为乐趣而阅读的 9 岁儿童比例从 53% 下降到 39%;13 岁儿童的比例从 27% 下降到 14%。 ## AI 教育的问题 许多 AI 教育工具同样将学习分解为可量化的模块,追求效率和数据,却忽视了阅读的深层意义——沉浸、好奇和乐趣。真正的教育不应只是数据点的集合,而应培养终身学习者和思考者。
Often debates about education are framed as non-tech versus AI approaches, but too often, AI ed tech just magnifies the same failures of traditional school.

“氛围编程”(Vibe Coding)——大规模生成复杂AI代码,且往往不打算由人类阅读——正对科技行业施下魔咒。高管推动裁员,声称AI可以胜任工作;经理施压员工达到AI代码占比指标;开发者焦虑自己落后;学生怀疑是否还值得学习计算机科学。然而,AI公司从业者发现,氛围编程的结果远非早期爱好者所承诺的那样。知名开发者Armin Ronacher将沉迷于Claude编码的经历称为“代理精神错乱”(agent psychosis):他连续两个月疯狂提示,构建了大量工具,却几乎未实际使用,或它们并未如预期般工作。这种成瘾性可能与赌博类似,是正常“心流”(flow)状态下的阴暗面。心理学家米哈里·契克森米哈伊定义的心流强调技能与挑战的匹配,而氛围编程创造了一种虚假的挑战感:AI瞬间生成代码,用户持续获得“能力超强”的错觉,但代码往往充满隐藏错误、难以维护。本文深入剖析氛围编程的诱惑与危害,并探讨如何避免陷入这种“精神错乱”的陷阱。
Vibe coding is the creation of large quantities of highly complex AI-generated code, often with the intention that the code will not be read by humans. It has cast quite a spell on the tech industry. Executives push lay-offs claiming AI can handle the work. Managers pressure employees to meet quotas of how much of their code must be AI-generated or risk poor performance reviews. Software developers worry that everyone around them is a “10x developer” and that they’ve fallen behind. College stude

## 当大模型遇上古老精读:一场认知升级的实验 精读(Close Reading)是人类最古老的深度阅读技术之一。它要求读者对文本的语言、结构和内容进行细致分析,不仅要“读进去”,更要“读出来”——与更广阔的背景知识建立联系。正如《精益创业》作者Eric Ries所言,精读是“文明最古老、最强大的技术之一,用于传达事物的整体理解”。 如今,这项古老技艺正被大语言模型(LLM)赋予全新可能。在最近一期fast.ai课程《How to Solve It With Code》中,Jeremy Howard和Johno Whitaker演示了如何借助LLM实现“读一段、问一段”的互动式精读。 ### 两个典型实验:书籍与论文 **实验一:Eric Ries新书《Incorruptible》的精读** Jeremy在阅读Ries未出版书稿时,将LLM作为“私人阅读助手”。当读到3M前CEO转任波音后推行成本削减政策、间接导致737 MAX危机的章节时,他立即向LLM追问:“这位CEO为何能同时获得‘年度CEO’称号却酿成安全灾难?”LLM不仅提供了详细背景,还关联了波音公司文化变迁的深层脉络。 **实验二:Yann LeCun前沿论文LeJEPA的解析** Johno Whitaker则展示了处理高密度学术论文的方法。他利用LLM逐段解释数学公式、关联代码实现,甚至生成了可视化交互界面,帮助理解论文中的核心概念。 ### 精读+LLM的三大核心优势 1. **个性化追问**:读者可以随时打断阅读,提出“这个术语什么意思”“与前文如何关联”等问题,LLM能提供即时、准确的解答。 2. **知识延伸**:当读者对某个细节产生兴趣时,LLM能快速展开相关背景,形成“阅读—提问—探索”的正向循环。 3. **降低门槛**:对于艰深的学术内容,LLM可充当“翻译器”,将抽象概念转化为直观理解。 ### 对AI行业的启示 这项实验揭示了一个重要趋势:**LLM的价值不仅在于生成内容,更在于作为认知增强工具**。传统精读依赖读者自身的知识储备和联想能力,而LLM可以实时补充外部知识、连接多元信息,使深度阅读的效率大幅提升。 当然,这种阅读方式也面临挑战:如何确保LLM解释的准确性?如何避免过度依赖而削弱独立思考?这些都需要在实践中不断平衡。 ### 小结 精读与LLM的结合,不是用机器替代人类思考,而是为深度阅读提供一种“脚手架”。当读者既能沉浸于文本本身,又能随时借助AI拓展认知边界时,古老的精读艺术或许将在数字时代焕发新的生机。
Close reading is a technique for careful analysis of a piece of writing, paying close attention to the exact language, structure, and content of the text. As Eric Ries described it ,“ close reading is one of our civilization’s oldest and most powerful technologies for trying to communicate the gestalt of a thing, the overall holistic understanding of it more than just what can be communicated in language because language is so limited. ” It was (and in some cases still is) practiced by many anci

## 当“无聊”被美化,我们忽略了什么? 一直以来,社交媒体、育儿文章甚至政策提案中,都不乏对“孩子无聊是好事”的赞美。人们认为无聊能激发创造力,让孩子学会自处。然而,这种观点是否站得住脚?当我们把“无聊”与“无结构的自由玩耍”混为一谈时,可能正在忽视儿童的自主权与真实需求。 ### 无结构玩耍 ≠ 无聊 玩耍是童年的基石。孩子需要无结构的自由时间来探索兴趣:用纸巾盒给玩偶搭房子、手绘迷宫、发明小游戏……这些活动充满主动性和乐趣,**绝非无聊**。真正的无聊,是缺乏兴趣、重复乏味带来的厌倦感,它不会催生创造力,反而会扼杀好奇心。 ### 警惕“学校式无聊”的破坏力 以作者女儿的经历为例:她在家时创意无限,但进入学校后却变得被动、失去好奇心,甚至对原本热爱的钢琴和象棋也产生抵触——因为学校的环境让她习惯了“不费力就能答对”,而无法容忍练习中的错误。**这种慢性无聊改变了她的认知模式**。直到回归 homeschooling,她的好奇心、创造力和韧性才迅速恢复。 ### “倦怠”与“忙碌”并非对立 职场研究早已证实:**慢性无聊(boreout)与过劳(burnout)同样有害**。前者源于长期缺乏刺激和挑战,导致压力、脱离感甚至离职倾向。孩子亦然——被迫听太简单或太难懂的课、完成重复作业、读乏味的书,这些都不是“有益的磨炼”,而是精神消耗。 ### 尊重孩子的自主性 我们不应将“无聊”浪漫化。**真正的成长来自有意义的挑战和自主探索**,而非忍受枯燥。与其告诉孩子“无聊是好事”,不如为他们提供丰富的环境、适度的自由,并倾听他们的真实感受。毕竟,我们不会对成年人说“职场无聊有益健康”,那为何要这样对待孩子?
Chronic boredom is harmful to adults, causing stress, disengagement, and poor well-being. Academic researchers have shown that boredom in the workplace can be just as damaging as burnout. But search for information about childhood boredom and you’ll find the opposite message: articles describing boredom for kids as “fantastic”, “important”, and full of benefits.

An overview of the features of the Solveit platform, which is designed to make exploration and iterative development easier and faster.


A text and code version of Karpathy’s famous tokenizer video.

An email sent to all fast.ai forum users.
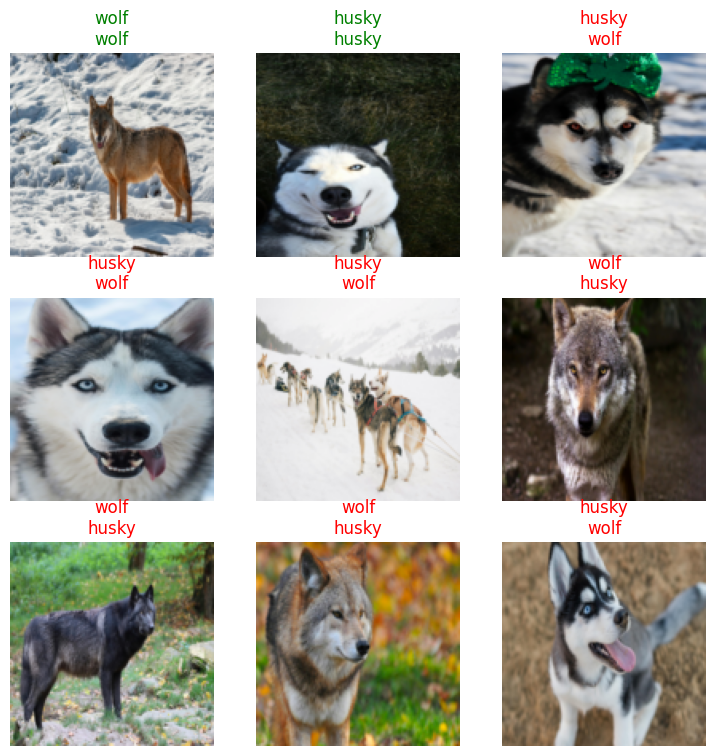
## 从“雪地里的狼”到可逆数据管道的诞生 如果你训练过机器学习模型,一定有过这样的体验:模型表现不佳,你想看看它到底“看”到了什么,却不得不手动编写逆变换函数,才能把归一化、裁剪、增强后的数据还原成肉眼可读的图片。这种痛苦让许多开发者干脆跳过数据可视化,仅凭抽象的数字调试模型。 fastai 团队早已意识到了这个问题。在 fastai 的 vision 模块中,`show_batch()` 和 `show_results()` 只需一行代码就能展示经过变换后的训练数据或预测结果。例如,加载一个“哈士奇 vs 狼”的分类数据集,经过 `RandomResizedCrop` 和 `Normalize` 变换后,直接调用 `show_batch()` 就能看到模型实际“看到”的图像。更关键的是,通过 `Interpretation.from_learner` 和 `plot_top_losses`,开发者可以快速定位模型最失败的样本。 **一个经典的案例是:模型并非在识别“狼”,而是在识别“雪”。** 训练数据中,狼的图片几乎都带有雪地背景,而哈士奇则多在森林中。模型学会了根据背景判断类别。如果没有轻松的可视化能力,这种严重的偏差可能被忽略。 ## fasttransform:让变换既可逆又可扩展 这一能力的核心正是 `fastcore` 库中隐藏已久的 **Transform** 类。它通过**多重分派(multiple dispatch)**机制,让数据变换操作既支持正向应用,也支持反向还原,并且可以轻松组合和扩展。 今天,fastai 团队正式将其独立为一个新库 **fasttransform**。这意味着它的应用范围不再局限于机器学习:任何需要数据管道的场景——图像处理、文本清洗、时间序列预处理——都可以从中受益。 **核心设计理念**: - **可逆性**:每个变换都自带 `inverse` 方法,无需手动编写逆函数。 - **组合性**:多个变换可以串联成管道,管道本身也是可逆的。 - **扩展性**:通过多重分派,用户可以轻松为自定义数据类型添加变换。 ## 为什么“可逆”如此重要? 在机器学习实践中,数据变换是不可或缺的环节。但传统做法中,变换通常是单向的,一旦应用就难以还原。这导致: - 调试困难:无法直观检查模型输入。 - 可解释性差:难以展示模型“看到”的原始数据。 - 重复工作:每个项目都要重新编写逆函数。 fasttransform 的出现,有望改变这一现状。它不仅让可视化变得简单,还为更高级的可解释性工具(如 LIME、Grad-CAM)提供了基础——这些工具同样需要将模型关注的区域映射回原始图像空间。 ## 展望:超越机器学习的通用工具 虽然 fasttransform 源于 fastai,但其设计足够通用。团队期待它能在以下领域发挥作用: - **数据工程**:ETL 管道的可逆验证。 - **图像处理**:无损编辑与撤销。 - **科研实验**:记录并回放数据变换流程。 fasttransform 的发布,意味着“数据可视化”和“调试体验”将不再是机器学习项目的附属品,而成为核心基础设施。对于任何希望深入理解模型行为的开发者来说,这无疑是一个值得关注的新工具。
The post A conversation with Kevin Scott: What’s next in AI appeared first on The AI Blog .
The post From Hot Wheels to handling content: How brands are using Microsoft AI to be more productive and imaginative appeared first on The AI Blog .
The post Microsoft open sources its ‘farm of the future’ toolkit appeared first on The AI Blog .