
在AI客服与知识管理日益融合的今天,一款名为 **Smart FAQs** 的产品悄然登上了Product Hunt的推荐榜单。它主打“更聪明的AI问答”——不仅基于企业自有内容,还能结合客户上下文,提供精准、个性化的答案。 ## 核心能力:内容+上下文 Smart FAQs 的定位非常清晰:它并非通用的聊天机器人,而是专注于让企业用 **自己的知识库**(如文档、FAQ页面、帮助中心文章)来训练AI模型。同时,它能捕捉 **客户上下文**,比如用户的历史问题、当前会话状态、甚至身份标签,从而让回答更具针对性。 这解决了传统FAQ系统的两个痛点:一是通用AI模型对企业特定知识覆盖不足,容易产生“幻觉”;二是问答缺乏个性化,所有用户得到相同的答案。 ## 落地场景与价值 对于SaaS企业、电商平台或任何需要大规模客户支持的团队,Smart FAQs 可以显著提升 **首次回复解决率** 和 **客户满意度**。例如,当客户询问“如何重置密码”时,系统不仅能给出标准步骤,还能根据客户等级或设备类型微调指引。 从产品形态看,它可能提供无代码集成、API接入或直接嵌入网页的Widget,降低部署门槛。 ## 行业趋势:从通用到专精 2024年以来,AI问答领域呈现明显分化:一方面是大模型巨头争抢通用场景,另一方面是垂直工具深耕细分需求。Smart FAQs 属于后者,它强调“自有内容”和“上下文”,本质上是在 **知识检索增强生成(RAG)** 框架下做了产品化封装。 不过,该产品尚未披露底层模型来源、上下文窗口大小、以及是否支持多模态内容。对于企业用户而言,数据隐私与模型可定制性将是关键考量。 ## 小结 Smart FAQs 提供了一个务实的方向:不追求全能,而是聚焦“更聪明地回答企业专属问题”。它适合那些已经拥有结构化知识库、希望提升客服效率且对答案准确性有高要求的团队。后续值得关注其与主流CRM、帮助台工具的集成深度,以及定价策略是否匹配中小企业预算。
## 一句话概括 **MarkUp** 是一款利用 AI 视觉提示直接编辑网站的工具,用户只需在网页截图上圈选、标记或输入文字指令,AI 即可自动生成对应的 HTML/CSS 修改,无需手动编写代码。 ## 核心功能与使用场景 传统网站编辑往往需要开发者定位代码、修改样式或调整布局,过程繁琐且依赖技术背景。MarkUp 改变了这一流程:用户对网页截图进行视觉标注——比如圈出一个按钮并输入“改成蓝色圆角”,或高亮一段文字并写“字体加粗、字号 18px”——AI 便会理解意图,直接输出可应用的代码变更。 这种方式大幅降低了前端修改的门槛,尤其适合: - **产品经理和设计师**:快速验证交互方案,无需等待开发排期。 - **营销与运营人员**:临时调整落地页文案、CTA 按钮样式。 - **独立开发者**:加速原型迭代,减少重复劳动。 ## 背后的技术逻辑 MarkUp 的核心能力在于**视觉语言模型(VLM)**与**代码生成模型**的结合。AI 不仅识别截图中的元素(按钮、文本框、图片),还能理解用户通过视觉标记(箭头、框选、颜色标注)传达的修改意图,并将其映射为具体的 DOM 操作和 CSS 规则。 这与传统的“截图→描述需求→AI 生成代码”流程不同:MarkUp 直接在可视化界面上完成“所见即所得”的交互,反馈更直观,沟通成本更低。 ## 行业背景与意义 随着 GPT-4V、Claude 3 等多模态模型能力提升,“视觉理解+代码生成”已成为 AI 编程工具的新方向。此前,类似产品多聚焦于从设计稿(如 Figma)生成代码,或从自然语言描述生成整页。MarkUp 则切入了一个更细分的场景——**对已有网页进行局部修改**,这在日常迭代中需求频率更高。 对于企业而言,MarkUp 可能意味着: - 减少开发资源的低效占用。 - 缩短 A/B 测试和页面优化的周期。 - 让非技术角色也能参与前端微调。 ## 局限性提示 目前 MarkUp 仍处于早期阶段,其可靠性高度依赖于截图的清晰度、标注的精确度以及目标网站的 DOM 复杂度。对于动态内容(如 JavaScript 渲染的组件)或高度定制化的框架(如 React 状态管理),AI 的生成结果可能需要人工校验。此外,安全性方面——AI 直接修改生产环境代码的风险——也是企业级采用前需要评估的要素。 ## 小结 MarkUp 代表了“AI 辅助前端开发”从“生成”走向“编辑”的演进方向,通过视觉提示降低了修改成本,让网站迭代更贴近“指哪打哪”的直觉。对于追求效率和低代码协作的团队,这是一个值得关注的工具。
在硬件产品开发中,从概念到量产往往涉及数百个决策节点,而每个节点的失误都可能导致成本超支或上市延迟。**Sutra** 正是为应对这一挑战而生的决策智能平台,它通过数据驱动的方式帮助硬件团队更科学地做决策。 ## 核心价值:将直觉转化为数据 传统硬件开发依赖经验判断,但复杂供应链和多变需求让直觉越来越不可靠。Sutra 的核心思路是 **整合项目数据、市场信息与工程参数**,通过算法模型给出决策建议。例如,当团队面临“选择A供应商还是B供应商”时,Sutra 能综合成本、交期、质量历史等维度,给出量化评分,并提示潜在风险。 ## 适用场景与功能 Sutra 主要服务于 **硬件产品经理、项目经理和供应链负责人**。其功能覆盖了产品开发的关键环节: - **需求优先级排序**:基于市场数据和工程可行性,自动评估各功能模块的投入产出比。 - **供应链风险评估**:实时监控供应商表现,预警断供或质量波动。 - **成本优化模拟**:输入物料清单和工艺参数,快速生成不同方案的成本对比。 - **里程碑追踪**:将决策点与项目时间线关联,自动标记延迟节点并建议补救措施。 ## 行业背景:硬件决策的数字化缺口 与软件行业相比,硬件领域的数字化工具长期滞后。软件团队有 Jira、Asana 等成熟工具管理任务,但硬件决策往往散落在 Excel 表格和邮件中。Sutra 的出现填补了这一空白,它并非简单替代传统项目管理软件,而是 **聚焦于“决策”本身**——提供的是分析能力而非单纯的记录功能。 ## 潜在挑战 尽管 Sutra 的理念颇具吸引力,但硬件团队的数据收集和标准化程度参差不齐。如果企业缺乏历史数据或数据质量不高,Sutra 的模型精度可能会打折扣。此外,团队习惯的改变也需要时间——从“拍脑袋”到“看数据”的转变并非一蹴而就。 ## 小结 Sutra 为硬件行业带来了一股“数据化决策”的新风。它瞄准的是一个细分的刚需场景,且产品设计紧扣硬件开发的实际痛点。对于正在寻求数字化转型的硬件团队而言,Sutra 值得关注。不过,其实际效果仍有待更多企业案例验证。
Transition 是一款面向跑步爱好者的 AI 教练应用,旨在通过数据驱动的个性化训练方案,帮助用户提升训练效率、优化比赛表现。该应用结合了运动科学算法与用户个人数据(如心率、配速、恢复状态等),动态调整训练计划,避免过度训练并降低受伤风险。 与传统的固定训练计划不同,Transition 能够根据用户的实时反馈和长期进步曲线,智能调整训练强度和休息安排。例如,当系统检测到用户疲劳累积或状态下滑时,会自动降低次日训练负荷;反之,若用户恢复良好,则会适当增加强度以刺激进步。 在比赛策略方面,Transition 提供基于历史数据和赛道条件的配速建议,帮助用户在比赛中合理分配体能。同时,应用内置了心理训练模块,通过正念引导和可视化练习,提升跑者的心理韧性。 Transition 的界面设计简洁直观,专注于核心训练数据展示,避免信息过载。用户可连接主流可穿戴设备(如 Garmin、Apple Watch 等)同步数据,实现无缝体验。 从行业背景来看,AI 在运动科技领域的应用正快速扩展。Transition 的差异化在于其“教练”定位——不仅提供数据,更提供决策建议。这反映了 AI 健身应用从“记录工具”向“智能伙伴”演进的趋势。对于追求个性化训练的严肃跑者,Transition 提供了一个有吸引力的选择。
随着企业纷纷将 AI 智能体投入生产,监控与调试这些自主系统成为新的挑战。**Tracea** 应运而生,定位为“AI 智能体的 Datadog”,提供追踪(traces)、根因分析(RCA)与团队记忆(team memory)三大核心能力,帮助开发团队洞察智能体行为、快速定位故障并积累协作知识。 ### 为何需要 AI 智能体专用监控? 传统 APM(应用性能监控)工具如 Datadog 擅长追踪常规 API 调用与微服务,但 AI 智能体具有独特的行为模式:多步推理、工具调用、上下文记忆以及非确定性输出。当智能体给出错误答案或执行异常操作时,开发者往往难以复现问题。Tracea 通过分布式追踪技术,记录智能体每一步决策与外部交互,形成可回溯的“思维链”,让调试从“黑盒”变为“白盒”。 ### 核心功能拆解 - **Tracing(追踪)**:自动捕获智能体从接收指令到最终响应的完整执行路径,包括 LLM 调用、工具使用、数据检索等环节。每个 span 携带时间戳、输入输出及元数据,支持跨会话关联。 - **Root Cause Analysis(根因分析)**:当智能体行为异常时,Tracea 自动对比正常基线,识别引发偏差的关键步骤。例如,若智能体因某个工具返回错误格式数据而中断,RCA 引擎会高亮该工具调用,并推荐修复方向。 - **Team Memory(团队记忆)**:这是一个独特的“知识复用”层。团队在调试过程中标记的见解、修复策略与最佳实践,会被结构化存储,供后续智能体或开发者检索。例如,某个智能体频繁误解“截止日期”格式,团队记忆可注入提示词模板,避免同类错误复发。 ### 适用场景与定位 Tracea 并非要取代 Datadog,而是填补其在 AI 智能体领域的空白。对于构建客服机器人、代码助手、自动化运维智能体的团队,Tracea 提供开箱即用的 SDK(支持 Python/TypeScript),几分钟即可集成。其免费层支持每月 10 万次追踪,适合中小团队试用。 ### 行业视角 当前,AI 可观测性赛道正快速升温。除了 Tracea,类似产品如 LangSmith、Weights & Biases Prompts 也提供追踪能力,但 Tracea 的独特卖点在于“团队记忆”——将调试经验转化为可复用的资产。这尤其适合多智能体协作场景,例如一个智能体从团队记忆中学习到“当用户问价格时,需先查询最新汇率”,从而提升整体准确性。 ### 小结 Tracea 的出现标志着 AI 运维从“监控指标”迈向“理解行为”。对于正在将 AI 智能体推向生产环境的团队,它提供了一套轻量级但功能完整的工具箱。随着智能体复杂度的提升,可观测性将成为 AI 工程化的关键基础设施,而 Tracea 的差异化路径——聚焦于知识沉淀——或许能为其赢得一席之地。
## 什么是 SuperIsland? **SuperIsland** 是一款专为 macOS 设计的桌面增强工具,其核心功能是将 iPhone 上备受好评的**动态岛(Dynamic Island)**交互体验移植到 Mac 上。通过 SuperIsland,用户可以在 Mac 的菜单栏区域获得一个可交互的“动态岛”,用于显示系统状态、应用通知、音乐播放控制等实时信息,并支持通过扩展(Extensions)来增加更多功能。 ## 核心功能与亮点 - **动态岛体验**:SuperIsland 在 Mac 屏幕顶部创建了一个类似 iPhone 动态岛的交互区域,能够动态显示后台活动、通知和快捷操作。 - **扩展支持**:用户可以通过安装扩展来扩展动态岛的功能,例如显示天气、日历事件、系统性能监控等,增强了工具的灵活性和实用性。 - **系统集成**:深度集成 macOS,支持原生通知、音乐控制(如 Spotify、Apple Music)、音量调节、电池状态等,无需切换应用即可快速操作。 - **自定义选项**:提供丰富的自定义设置,包括外观样式、显示内容、交互行为等,满足不同用户的个性化需求。 ## 适用场景与价值 对于 Mac 用户而言,SuperIsland 解决了在多任务处理时频繁切换应用的痛点。它能够将关键信息集中在一个易于触及的区域,提升操作效率。尤其是对于需要同时监控多个应用状态的专业用户(如开发者、设计师),SuperIsland 可以作为一个轻量级的“信息中心”,减少干扰的同时保持对重要动态的掌控。 ## 行业背景与对比 在 macOS 生态中,类似的概念并不新鲜。此前已有如 **Bartender**(菜单栏管理工具)和 **iStat Menus**(系统监控工具)等产品,但 SuperIsland 的创新之处在于将动态岛的交互逻辑与扩展机制结合,更接近 iPhone 的灵动体验。此外,随着 Apple 在 iOS 16 中引入动态岛,用户对这种交互方式的接受度日益提高,SuperIsland 恰好填补了 Mac 端这一体验的空白。 ## 总结与展望 SuperIsland 是一款富有创意的 macOS 工具,它巧妙地将移动端的交互范式迁移到桌面,并通过扩展生态赋予其更多可能性。对于追求高效与新奇体验的 Mac 用户来说,它值得一试。未来,随着更多第三方扩展的加入,SuperIsland 有望成为 macOS 菜单栏的“超级中心”。
## 一句话总结 DevPass 是 LLM Gateway 推出的一项订阅服务,旨在以三种固定价格提供对多种编码模型的统一访问权限,简化开发者的 AI 工具使用流程。 ## 核心亮点 - **统一接入**:通过单一 API 密钥,即可调用多个主流编码模型,无需单独注册和付费。 - **三种定价**:提供三档固定月费方案,覆盖不同使用需求,从个人开发者到团队均可选择。 - **成本可控**:固定价格模式避免了按量计费带来的费用波动,让预算规划更简单。 ## 背景与意义 随着 AI 编码助手(如 GitHub Copilot、Codeium、Amazon CodeWhisperer 等)的普及,开发者常常需要在多个工具之间切换,每个工具都有自己的定价和 API。DevPass 试图解决这一碎片化问题,通过聚合服务降低管理成本。 这种“模型聚合”模式在 AI 领域并不新鲜,但专门针对编码场景、并以固定订阅价提供的方式尚属少见。它类似于“编码模型界的 Netflix”——付一份钱,看多个内容。 ## 适用场景 - 希望尝试不同模型以找到最佳编码辅助的开发者。 - 需要为团队统一管理 AI 工具费用的技术负责人。 - 对成本敏感、希望避免按 token 计费不确定性的个人开发者。 ## 潜在局限 目前尚未公布支持的模型列表、API 速率限制以及服务质量(如延迟、准确性)等细节。开发者需要关注实际可用模型是否满足自身需求,以及服务稳定性是否可靠。 ## 小结 DevPass 通过简化的定价和统一的接入点,降低了开发者使用多模型的门槛。如果后续能覆盖主流模型并保持良好性能,它有望成为开发者工具箱中的便捷选项。
在快节奏的工作环境中,信息碎片化是效率的头号杀手。我们常常在开会时记下语音备忘、在浏览网页时截取关键信息、在聊天记录里翻找待办事项——这些零散的输入最终需要手动整理成任务列表,而这个过程本身就消耗了大量精力。 **GetThis** 正是为了解决这一痛点而生。它是一款轻量级任务转化工具,核心能力简单直接:将语音、文本或截图一键转化为结构化的待办任务。无需复杂的操作界面,用户只需通过任意一种方式输入内容,GetThis 就会自动识别并提取其中的任务要素,生成可管理、可追踪的 to-do 条目。 ### 从输入到执行,缩短“认知摩擦” 传统任务管理工具往往要求用户先打开应用、点击新建、填写标题、设置优先级……每一步都是操作成本。GetThis 则试图消除这些中间环节: - **语音输入**:对着麦克风说“下午三点和张总开会,准备季度报告”,任务自动生成,时间、人物、事项被精准解析。 - **文本粘贴**:从邮件、文档或消息中复制一段文字,GetThis 能智能识别其中的待办意图,比如“需要确认预算”会变成一个任务项。 - **截图识别**:截取屏幕上的会议记录或手写笔记,利用 OCR 技术提取文字并转化为任务,尤其适合处理白板照片或纸质笔记。 这种“所见即所得”的转化方式,本质上是在降低用户从信息捕获到行动执行之间的认知摩擦——你不需要思考“这个信息应该怎么归类”,只管输入,剩下的交给工具。 ### 与 AI 工作流无缝衔接 作为一款产品,GetThis 的定位并非取代现有任务管理工具,而是作为“输入层”进行补充。它支持与主流待办应用(如 Todoist、Notion、TickTick 等)同步,也能通过 API 接入自动化工作流。例如,用户可以将语音任务直接推送到项目的看板中,或触发后续的提醒和日程安排。 从行业趋势来看,AI 正在重塑“人机协作”的边界。过去我们适应工具的逻辑,现在工具开始理解人的意图。GetThis 所代表的“多模态输入 + 智能解析”模式,正是这一趋势的缩影。类似的产品如 **Mem.ai** 和 **Otter.ai** 也在探索从笔记到任务的自然转化,但 GetThis 更聚焦于“任务”这一单一输出格式,意图更明确,转化路径更短。 ### 适用场景与潜在局限 对于经常需要处理碎片信息的职场人士、自由职业者和学生,GetThis 能显著提升信息转化效率。尤其是在移动场景下,语音输入的便捷性使其成为驾驶、行走或会议中的理想工具。 不过,目前这类工具普遍面临的挑战是语义理解的准确性。当输入内容包含歧义、多任务或复杂上下文时,AI 的解析可能不够精确,需要用户二次调整。此外,隐私问题也不容忽视——语音和截图数据的上传与处理需要明确的安全保障。 ### 小结 GetThis 切入了一个小而具体的场景:让任务创建变得像呼吸一样自然。它不追求大而全,而是用极简的方式解决一个普遍存在的效率痛点。在 AI 能力日益成熟的今天,这类“单点突破”的工具往往能更快落地,也更容易被用户接受。如果你经常被信息淹没,不妨试试把任务“丢”给 GetThis。

在AI工具层出不穷的今天,许多用户每天都在重复执行类似的提示词操作——比如翻译文档、生成报告摘要、整理会议记录。这些任务虽然可以用ChatGPT或Claude完成,但每次都要重新输入指令、调整参数,效率并不理想。 **Hachigo** 正是为了解决这一痛点而生。它允许用户将常用的AI工作流封装成独立的“微应用”,无需编程知识即可创建。例如,你可以创建一个“周报生成器”应用,只需输入本周工作要点,即可自动输出格式规范的周报;或者创建一个“邮件润色助手”,粘贴草稿后一键获得专业版本。 ### 核心能力与使用场景 Hachigo 的核心逻辑是“模板化+自动化”。用户先通过自然语言定义任务的目标、输入格式和输出要求,然后Hachigo会将其固化为一个可复用的应用界面。此后,每次使用时只需填写输入框,点击运行,AI便会按照预设流程处理。 适用场景非常广泛: - **内容创作**:批量生成社交媒体文案、SEO文章摘要 - **数据分析**:将原始数据粘贴后自动生成可视化报告 - **编程辅助**:代码审查、注释生成、错误解释 - **教育学习**:生成练习题、知识点总结、错题分析 ### 与同类工具的差异 市面上已有不少AI工作流工具(如Zapier的AI功能、Make.com的模板),但Hachigo更强调“轻量级”和“面向个人”。它不需要复杂的触发器或多步骤连接,而是聚焦于单一任务的深度定制。用户创建的每个应用都相当于一个“AI技能包”,可以分享给团队成员使用。 ### 行业背景与价值 随着大语言模型能力的提升,企业开始关注如何将AI融入日常流程。Gartner预测,到2026年,超过80%的企业将使用AI增强的自动化工具。Hachigo这类工具降低了AI应用的门槛,让非技术用户也能构建自己的AI助手,从而释放重复劳动的时间。 ### 小结 Hachigo 的定位清晰:将AI从“对话式工具”转变为“任务式应用”。对于经常与AI打交道的知识工作者来说,它可能成为提升效率的新利器。目前产品处于早期阶段,具体定价和模型支持细节尚待披露,但其理念已经切中了真实需求。
## 一句话总结 Basedash MCP 服务器让用户能在任何 AI 工具中直接查询和获取数据洞察,无需切换应用或编写复杂 SQL。 ## 核心功能 Basedash 推出的 MCP(Model Context Protocol)服务器,本质上是一个**数据连接器**,旨在将数据查询能力嵌入到用户日常使用的 AI 工具中。无论是 ChatGPT、Claude、Gemini 还是其他大语言模型,用户只需在对话中提出数据问题,MCP 服务器便会自动连接到后端的数据库,执行查询并返回结果。 - **无缝集成**:支持多种主流 AI 工具,用户无需离开当前界面即可完成数据操作。 - **自然语言查询**:用日常语言提问,系统自动转换为 SQL 或 API 调用。 - **实时数据**:直接连接生产数据库,确保每次查询结果都是最新状态。 ## 适用场景 这一能力对于**非技术用户**尤其有价值。以往,业务人员想要获取特定数据报表,往往需要等待数据团队排期;现在,他们可以在与 AI 助手的日常对话中直接获得答案。例如: - 市场人员询问“上周各渠道转化率对比”,AI 助手即时返回表格。 - 产品经理要求“列出最近 30 天活跃用户最多的功能”,无需提工单即可获得清单。 ## 行业背景 MCP 是 Anthropic 提出的开放协议,旨在标准化 AI 模型与外部数据源及工具的交互方式。Basedash 选择在这一协议上构建,意味着其兼容性不仅限于当前主流模型,未来也能适配更多遵循该协议的 AI 服务。 当前,数据与 AI 的融合正从“大模型训练”转向“实时推理与调用”。Basedash MCP 服务器的定位正是**让数据成为 AI 的实时记忆**,而非仅限于训练时的静态知识。 ## 小结 Basedash MCP 服务器并非一个独立产品,而是一个能力层——它让数据查询变得像“对 AI 说话”一样简单。对于已经依赖 AI 工具完成日常工作的团队来说,这可能是打通数据孤岛的关键一步。

## 从零开始的重构:Neo by Amp CLI 的进化之路 在开发者工具领域,命令行界面(CLI)始终是效率的核心。近日,**Amp 团队**宣布其 CLI 工具 **Neo** 已从底层彻底重建,这一消息迅速引发了技术社区的关注。作为一款专为现代开发者设计的工具,Neo 的全面重构并非简单的版本迭代,而是对开发体验、性能和可扩展性的重新思考。 ### 为何选择“从零开始”? 传统 CLI 工具往往受限于早期架构设计,随着功能堆叠,代码复杂度飙升,响应速度下降,甚至出现命令冲突。Amp 团队意识到,修补旧代码已无法满足云原生、微服务架构下的高效开发需求。因此,他们决定**抛弃历史包袱,用现代化技术栈重写整个 CLI**。这种“破而后立”的策略,在业界并不罕见——例如,Docker 曾重构其 CLI 以支持更灵活的插件系统,而 Neo 的此次升级也意在类似方向。 ### 核心亮点:速度、简洁与模块化 根据官方透露的信息,Neo 的改进集中在三个维度: - **性能飞跃**:通过采用 Rust 或 Go 等编译型语言替代解释型语言(具体技术栈未公开),启动时间缩短至毫秒级,命令执行效率提升数倍。这对于频繁切换项目的开发者而言,意味着更少的等待和更流畅的交互。 - **命令直觉化**:重新设计了命令语法,减少嵌套层级,并引入智能补全。例如,`neo deploy` 直接关联云部署流程,而无需冗长的参数链。 - **插件生态重构**:新架构支持热插拔插件,允许开发者按需加载功能模块,避免“大而全”导致的内存浪费。这类似于 VS Code 的扩展机制,但更贴近 CLI 场景。 ### 对开发者社区的意义 Neo 的重构并非孤立事件。它反映了当前 AI 和 DevOps 工具链的一个趋势:**CLI 正在从“执行脚本”进化为“开发工作台”**。随着 GitHub Copilot 等 AI 编码助手的普及,CLI 也需要更智能的交互——例如,通过自然语言解析命令意图。虽然 Neo 尚未明确集成 AI,但其模块化设计为未来接入 AI 能力预留了接口。 ### 小结 Neo by Amp 的全面重构,标志着开发者工具领域的一次重要迭代。对于追求极致效率的团队来说,这或许正是他们等待的“瑞士军刀”。目前,Neo 已开放早期预览,感兴趣的开发者可通过 Amp 官网申请体验。 > 提示:本文信息基于产品发布摘要,具体功能细节以官方文档为准。
OpenAI 悄然更新了 ChatGPT 的默认模型,推出 **GPT‑5.5 Instant**,为用户带来更快速、更智能的对话体验。这一升级标志着 ChatGPT 在个性化和响应质量上又迈出了一步,无需用户手动切换即可享受最新模型的加持。 ## 升级亮点 GPT‑5.5 Instant 作为新的默认模型,在多个维度实现了显著提升: - **更智能的回答**:模型在理解复杂上下文、处理多轮对话以及生成准确信息方面表现更优。据早期用户反馈,逻辑推理和事实准确性均有改善。 - **个性化增强**:能够更好地适应用户的沟通风格和偏好,从语气到内容深度都更加贴合个人需求。 - **响应速度优化**:尽管模型能力更强,但推理延迟并未显著增加,部分场景下甚至更快。 ## 对用户的影响 对于日常使用者而言,这一变化几乎是“无感”的——无需任何操作即可享受升级。但背后意义重大:OpenAI 正将最新研究成果直接部署到用户端,缩短了技术迭代与用户体验之间的距离。 > 一位开发者评论道:“默认模型升级意味着 OpenAI 对 GPT‑5.5 Instant 的稳定性充满信心,这是模型成熟的重要标志。” ## 行业背景 当前大模型竞争已进入“精细化”阶段,各厂商不再单纯追求参数量或基准分数,而是更注重实际使用中的流畅度和个性化能力。GPT‑5.5 Instant 的发布,正是这一趋势的体现: - 与 Anthropic Claude 的“个性定制”功能对标 - 与 Google Gemini 的实时推理能力竞争 - 巩固 ChatGPT 在消费级市场的领先地位 ## 小结 GPT‑5.5 Instant 的推出,不仅是技术升级,更是产品策略的调整——将“更强”与“更贴心”作为默认体验,降低用户选择成本。对于 AI 行业而言,这提醒我们:下一代模型的竞争,正在从“能力有多强”转向“体验有多好”。
对于关注早期创业生态的人来说,Y Combinator(YC)无疑是一座金矿。但海量的初创公司信息、融资动态和团队背景,往往散落在不同的角落,难以系统化利用。**ExploreYC** 正是为解决这一痛点而生——它将自己定位为“YC 创业生态的数据层”,旨在为用户提供结构化的、可查询的 YC 初创公司数据库。 ## 核心功能:不止于名录 ExploreYC 并非简单的公司列表。它通过聚合公开数据,为每家 YC 投资的公司构建了丰富的“数据画像”,包括: - **基本信息**:公司名称、简介、创始人、成立时间。 - **融资历史**:轮次、金额、领投方。 - **产品分类与标签**:便于按领域(如 AI、SaaS、生物科技)筛选。 - **团队背景**:创始人的过往经历与教育信息。 用户可以通过关键词搜索、筛选和排序,快速找到符合特定条件的公司,例如“2023 年夏季批次中,由斯坦福校友创立的 AI 初创公司”。这种结构化查询能力,对于投资人、创业者、研究者乃至希望寻找合作伙伴的从业者,都具有实际价值。 ## 价值定位:从信息到洞察 在 AI 行业,数据和信息是决策的基础。YC 每年孵化数百家公司,但公开信息往往分散在 Crunchbase、PitchBook、LinkedIn 以及 YC 自己的目录中。ExploreYC 试图通过一个统一入口,降低信息整合的成本。它的价值体现在几个层面: - **效率提升**:避免在多个平台间来回切换,节省调研时间。 - **趋势发现**:通过标签和分类,可以观察 YC 投资方向的变化,例如 AI 相关公司的比例是否在上升。 - **竞争分析**:针对特定赛道,快速了解所有相关 YC 公司,分析其差异化定位。 当然,作为第三方数据层,ExploreYC 的数据完整性依赖于公开信息的可及性。对于未公开披露融资细节的公司,其画像可能不如预期详尽。但总体而言,它填补了 YC 生态中“结构化数据”的空白。 ## 行业背景与展望 当前,AI 创业热潮持续升温,YC 作为顶级孵化器,其投资组合往往被视为行业风向标。ExploreYC 的出现,反映了市场对“精细化数据工具”的渴求——不仅仅是“有哪些公司”,更是“它们之间有何关联”“哪些趋势正在形成”。类似的产品如 Crunchbase 和 PitchBook 偏向泛投融资市场,而 ExploreYC 聚焦 YC 生态,显得更加垂直和精准。 对于 AI 从业者而言,ExploreYC 可以成为日常研究工具的一部分。例如,追踪 YC 中 AI 公司的融资节奏,分析其技术路线(如大模型、AI Agent、垂直应用),甚至发现潜在的合作或投资机会。随着数据量的积累,ExploreYC 未来可能加入更多分析功能,如趋势图表、对比报告等,进一步提升其作为“数据层”的价值。 ## 小结 ExploreYC 是一个专注于 YC 创业生态的数据产品,通过结构化聚合公开信息,帮助用户高效地检索和分析 YC 初创公司。它适合投资人、创业者、研究者和科技爱好者使用。虽然数据覆盖度受限于公开来源,但其垂直定位和查询能力使其在工具型产品中独具特色。如果你关注 YC 生态,不妨一试。
在快节奏的办公环境中,会议记录往往是令人头疼的环节。既要专注讨论,又怕遗漏关键信息,传统的手动笔记方式常常顾此失彼。**Askmeety** 的出现,为 Mac 用户提供了一种全新的解决方案:它能够自动生成高质量会议笔记,让你完全无需动手记录。 ### 核心亮点:100% 本地化运行 与许多依赖云端处理的 AI 工具不同,Askmeety 完全运行在你的 Mac 上。这意味着所有会议音频和转录数据都保留在本地,无需上传至第三方服务器,**隐私安全得到最大程度保障**。对于注重数据合规的企业用户或个人开发者而言,这一特性极具吸引力。 ### 如何工作? Askmeety 能够集成到常见的视频会议工具中(如 Zoom、Teams、Google Meet 等),实时捕捉对话内容。通过先进的语音识别和自然语言处理技术,它不仅能将语音转为文字,还能自动提取**行动项、决策点、关键讨论**等结构化信息。最终生成一份清晰、可搜索的会议纪要,以 Markdown 或纯文本格式保存。 ### 使用场景:从日常同步到深度复盘 - **周会同步**:自动生成待办事项,团队成员无需当场记录,会后直接分发。 - **客户会议**:准确记录客户反馈和承诺,避免后续争议。 - **头脑风暴**:完整保留创意过程,便于后续整理和归档。 ### 与竞品的差异 市面上已有不少 AI 会议笔记工具(如 Otter.ai、Fireflies.ai),但多数采用云端处理,且需要联网。Askmeety 的**本地化运行**是其最大的差异化优势,特别适合对数据隐私有严格要求的用户。此外,它专为 Mac 优化,与 macOS 的集成度更高,启动和运行更流畅。 ### 适用人群 - **职场白领**:需要频繁开会,希望提升效率。 - **自由职业者**:管理多个客户项目,需要清晰记录。 - **隐私敏感用户**:不愿将会议数据上传至云端。 ### 小结 Askmeety 以“本地、智能、无感”为核心理念,解决了会议记录中的核心痛点。如果你正在寻找一款既能保护隐私又能大幅提升会议效率的工具,它值得一试。目前该产品已在 Product Hunt 上架,Mac 用户可以免费下载体验。
## 一句话总结 Phrony 是一个让开发者能够快速部署 AI 代理(agent)而无需操心运维的平台,旨在降低 AI 应用落地的技术门槛和运营成本。 ## 核心价值:从“造轮子”到“专注业务” 在当前的 AI 热潮中,许多团队在构建智能代理时,往往被底层基础设施的复杂性所困扰:模型选择、推理优化、弹性伸缩、日志监控、安全防护……这些“隐形工作”占据了大量开发资源。Phrony 的定位正是要消除这一痛点——它提供了一套开箱即用的托管环境,让开发者只需专注于代理的逻辑设计,其余一切(包括服务器、API 管理、自动扩展等)都由平台接管。 ## 产品亮点 - **零运维部署**:一键部署 AI 代理,平台自动处理负载均衡、故障恢复等运维任务。 - **灵活的模型支持**:兼容主流大语言模型(如 GPT、Claude 等),并支持自定义模型接入。 - **内置监控与日志**:提供实时性能监控、调用追踪和错误告警,方便调试与优化。 - **安全与合规**:内置数据加密、访问控制和审计日志,满足企业级安全需求。 ## 适用场景 Phrony 特别适合以下团队: - **初创公司**:资源有限,希望快速验证 AI 代理的商业价值。 - **企业内部工具开发**:需要快速构建客服、自动化流程等内部 AI 应用。 - **AI 咨询与集成商**:为客户部署定制代理,但不想维护多套基础设施。 ## 行业背景 随着 Agentic AI(自主代理型 AI)成为 2025 年的热门趋势,从 OpenAI 的 GPTs 到各类开源框架,开发者对“代理即服务”的需求激增。然而,部署环境的复杂性仍是主要障碍。Phrony 的出现,类似于当年 Heroku 简化 Web 应用部署一样,试图将 AI 代理的部署体验推向“一键化”。 ## 小结 Phrony 精准切中了 AI 工程化过程中的运维痛点,其产品定位清晰、功能实用。对于想要快速进入 AI 代理领域的团队来说,这或许是一个值得关注的选择。
FlowMarket 是一个创新的 AI 平台,它构建了一个由 AI 智能体组成的社交网络,专门用于自动发现和生成 B2B 商业机会。该平台通过模拟人类社交网络的互动模式,让不同的 AI 智能体相互协作、交换信息,从而为企业用户精准匹配潜在客户和合作伙伴。 ### 核心机制:AI 智能体社交网络 与传统的 B2B 销售线索生成工具不同,FlowMarket 不依赖简单的关键词搜索或数据库筛选。它创建了一个由大量 AI 智能体构成的“社交圈”,每个智能体都代表一个特定的商业实体或行业角色。这些智能体能够自主地“交流”,模拟真实的商业社交场景,例如: - 一个代表制造业的 AI 智能体可以与代表物流的智能体互动,发现供应链优化机会。 - 一个代表 SaaS 公司的智能体能够与代表金融行业的智能体对话,挖掘企业级软件需求。 通过这种动态互动,平台能够生成更具上下文相关性的商机,而不仅仅是静态的线索列表。 ### 对 B2B 销售的影响 对于销售和市场营销团队而言,FlowMarket 提供了一种全新的获客方式: 1. **自动化商机发现**:减少人工调研和冷启动时间,AI 持续在后台运行,主动推送高质量商机。 2. **高相关性匹配**:基于智能体间的深度对话,商机匹配度更高,转化率有望提升。 3. **规模化扩展**:传统社交销售依赖个人人脉,而 FlowMarket 可以无限扩展智能体网络,覆盖更多行业和地域。 ### 行业背景与定位 当前,AI 在销售领域的应用主要集中在对话式 AI(如聊天机器人)和预测性分析上。FlowMarket 另辟蹊径,将“社交网络”与“多智能体系统”结合,本质上是一种**生成式 B2B 销售线索引擎**。这与近期流行的 AI Agent 概念(如 AutoGPT、BabyAGI)一脉相承,但更聚焦于商业应用场景。 ### 潜在挑战 尽管概念新颖,但 FlowMarket 也面临一些现实问题: - **数据准确性**:AI 智能体之间的对话是否会产生错误或过时的信息,从而误导商机判断? - **用户信任**:企业是否愿意接受由 AI 自动生成的商机,而非人工验证过的线索? - **竞争壁垒**:随着更多公司进入 AI Agent 领域,FlowMarket 需要快速积累行业数据和用户反馈,形成网络效应。 ### 小结 FlowMarket 代表了 AI 在 B2B 领域的一种前沿尝试——将智能体协作与社交网络理念融合,以实现商机的自动化生成。对于正在探索 AI 驱动的销售自动化的企业来说,这是一个值得关注的新工具。不过,其实际效果仍有待市场验证。
## 快速了解 Google Pomelli 目录 Google 推出的 **Pomelli 目录** 工具,旨在解决电商与品牌营销中一个长期存在的痛点:产品目录与营销素材之间的割裂。传统上,品牌需要将结构化的产品数据(如名称、价格、描述、图片)人工转化为社交媒体帖子、广告创意、邮件模板等多样化的营销资产,过程繁琐且重复。Pomelli 目录通过 AI 自动化这一流程,让用户只需上传标准产品目录,即可批量生成风格统一、适配不同渠道的品牌化营销素材。 ### 核心能力与价值 - **智能转换**:工具能够解析产品目录中的关键信息,并自动匹配预设的品牌模板(如配色、字体、Logo 位置),生成视觉一致的图片、文案或视频片段。 - **多渠道适配**:输出素材可直接用于 **Google Ads**、**社交媒体**(如 Instagram、Facebook)、**邮件营销** 或 **电商平台**,减少设计师重复调整尺寸和格式的工作量。 - **规模化生产**:对于拥有数百甚至数千 SKU 的品牌,Pomelli 目录能实现“一次输入,多次输出”,大幅缩短营销活动准备周期。 ### 对 AI 营销工具行业的启示 Pomelli 目录并非孤例,它反映了 **生成式 AI 在垂直场景落地** 的趋势。类似工具如 Canva 的“批量创建”功能、Adobe Firefly 的模板生成,都试图降低内容生产的边际成本。但 Google 的优势在于其与 **购物广告**、**YouTube 购物** 等自有生态的深度集成——生成的素材可直接用于 Google 广告系统,形成从数据到投放的闭环。 不过,该工具的局限性也值得关注:它依赖用户提供高质量的原始产品数据,且对创意自由度有所限制(需遵循预设模板)。对于追求高度定制化或艺术性设计的品牌,可能仍需人工介入。 ### 适用场景与未来展望 最适合使用 Pomelli 目录的场景包括:**快消品电商**、**季节性促销**(如黑五、双11)、**DTC 品牌** 的日常社交运营。随着多模态 AI 的进步,未来版本可能支持从产品图片直接生成 3D 展示或互动式广告,进一步模糊“目录”与“素材”的边界。 总的来说,Pomelli 目录是 Google 在 **AI 驱动营销自动化** 领域的一次务实尝试,尤其适合需要快速、低成本扩张内容矩阵的中小品牌。
在信息过载的时代,如何高效记忆关键知识成为许多人关注的焦点。**Memory Tags** 正是为此而生的一款 AI 工具,它能够将扫描的文字内容快速转化为记忆卡片(flashcards),帮助用户通过间隔重复(spaced repetition)等科学方法巩固记忆。 ### 核心功能:从文本到卡片,一步到位 Memory Tags 的使用流程非常简洁:用户只需扫描或输入任意文本,AI 便会自动解析并生成对应的问答式记忆卡片。例如,扫描一段医学术语,工具会自动提取关键概念与定义,形成“问题-答案”对。这种自动化流程大幅节省了手动制作卡片的时间,尤其适合学生、语言学习者以及需要持续更新知识的职场人士。 ### 背后的技术逻辑 该工具的核心依赖于自然语言处理(NLP)技术,通过语义分析识别文本中的实体、定义和关系。相比传统的手动制作方式,AI 能够更快速地处理长篇内容,并保持卡片的一致性和准确性。不过,对于高度专业或语境复杂的文本,AI 的提取精度可能仍需人工校对。 ### 适用场景与潜在价值 - **备考复习**:学生可将教材、讲义扫描生成卡片,结合间隔重复算法提升长期记忆效果。 - **语言学习**:扫描外文文章,自动提取生词、短语及例句,构建个人词汇库。 - **知识管理**:职场人士可快速整理会议记录、行业报告中的关键点,形成可复用的知识卡片。 Memory Tags 的定位是“轻量化记忆助手”,它不追求取代完整的笔记系统,而是专注于记忆环节的效率提升。对于习惯使用 Anki、Quizlet 等工具的用户而言,它可能成为一个便捷的输入前端。 ### 行业背景与竞争 记忆卡片类工具市场竞争激烈,既有 Anki 这样的开源老将,也有 Quizlet、RemNote 等集成更多功能的平台。Memory Tags 的优势在于**极低的输入门槛**——无需手动编写卡片,仅靠扫描即可完成。但这也意味着它在卡片样式、复习算法定制方面可能不如专业工具灵活。 ### 小结 Memory Tags 是一个典型的 AI 提效工具,它精准切入“记忆卡片制作”这一痛点,利用 NLP 技术简化了用户的工作流。对于追求快速记忆核心信息、不愿花费时间手动整理的用户来说,这是一个值得尝试的选择。不过,其实际效果高度依赖文本质量和 AI 解析的准确性,建议用户结合自身需求进行体验。
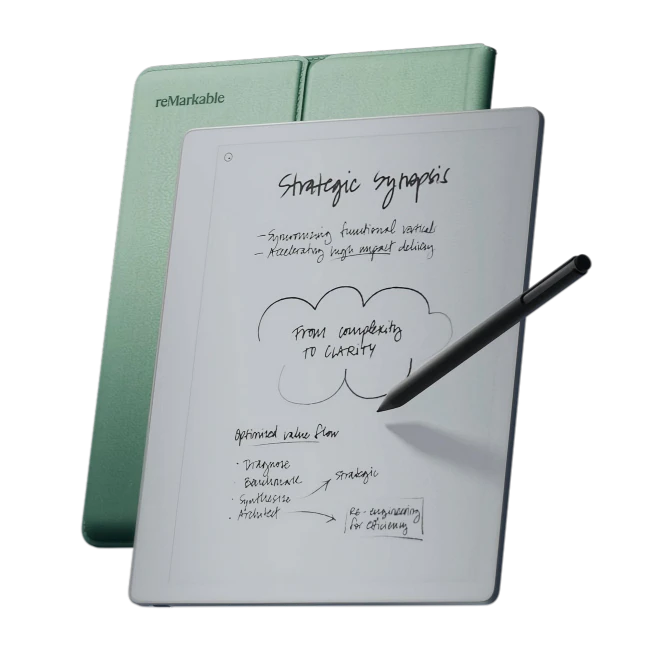
近日,知名电子纸设备品牌 reMarkable 发布了其新一代产品 Paper Pure,作为 reMarkable 2 的正式继任者。与市面上追求多功能、大屏幕或彩色显示的潮流不同,Paper Pure 选择了一条“回归基础”的路径:专注于提供无干扰的书写和阅读体验。 ## 核心升级:更快的响应与更清晰的显示 Paper Pure 在硬件上进行了针对性优化。其电子墨水屏幕的刷新率相比前代提升了约 30%,使得手写笔迹延迟更低,书写感觉更接近真实纸张。同时,屏幕分辨率也有所提高,文字和图形的边缘更加锐利,阅读体验更佳。设备依然保持了 reMarkable 标志性的极简设计,机身轻薄,电池续航长达数周,适合长时间专注使用。 ## 软件生态:简化而非堆砌 在软件方面,reMarkable 延续了其一贯的克制哲学。Paper Pure 的操作系统仍基于 Linux,界面简洁,主要功能围绕笔记、文档阅读和手写转换展开。新系统加入了更智能的手写识别和笔记整理功能,但并未引入应用商店或浏览器等容易分散注意力的元素。reMarkable 强调,他们的目标是帮助用户“减少屏幕时间,增加思考时间”。 ## 行业视角:电子纸市场的差异化竞争 当前电子纸设备市场正变得日益拥挤。以 Kindle Scribe、Kobo Elipsa 为代表的大屏阅读器融合了笔记功能,而 Boox 等品牌则提供基于 Android 的开放系统,支持安装各类应用。reMarkable Paper Pure 的“反潮流”策略,实际上是在强化其作为“专注工具”的品牌定位。对于追求极简主义、希望摆脱数字干扰的知识工作者、学生和创意人士而言,Paper Pure 提供了一个高度专业化的选择。 ## 小结 reMarkable Paper Pure 并非一款适合所有人的设备,它明确地服务于那些重视书写和阅读纯粹性的用户。通过精简功能、优化核心体验,reMarkable 在差异化道路上又前进了一步。如果你正在寻找一款能让你远离通知、沉浸于思考的电子纸设备,Paper Pure 值得关注。
Lingo.dev v1 是一款专注于本地化工程的平台,旨在帮助开发团队实现高质量、一致性翻译。在全球化产品快速迭代的今天,传统翻译流程往往面临术语不统一、上下文缺失、版本管理混乱等痛点。Lingo.dev 通过将本地化嵌入开发工作流,提供自动化、可复用的翻译管理方案。 ## 核心能力与亮点 - **上下文感知翻译**:开发者可定义翻译上下文(如字符串用途、字符长度限制),确保翻译准确贴合 UI 场景。 - **术语库管理**:支持创建自定义术语库,保证品牌名称、技术术语等在全部语言中保持一致。 - **版本控制集成**:与 Git 等版本控制系统深度整合,翻译随代码变更同步更新,避免版本错位。 - **自动化工作流**:通过 CI/CD 管道自动提取待翻译字符串、触发翻译任务、并合并回代码库。 ## 适用场景 Lingo.dev 特别适合以下团队: - **多语言 SaaS 产品**:需要频繁更新多语言内容,且要求翻译质量稳定。 - **移动应用开发**:支持 iOS、Android 等平台的本地化文件格式。 - **国际化电商平台**:产品描述、用户界面等大量字符串需精准本地化。 ## 行业背景与价值 随着 AI 翻译工具的普及,翻译效率已大幅提升,但一致性仍是难题。Lingo.dev 从工程角度切入,通过结构化管理和自动化流程,将翻译质量从“人工校对”转向“系统保障”。对于追求全球化扩张的创业公司,这能显著降低本地化维护成本,加速多语言版本上线。 ## 小结 Lingo.dev v1 定位清晰,聚焦开发者体验与翻译一致性。它并非替代人工翻译,而是为团队提供一套工程化工具,让本地化成为开发流程的自然延伸。如果你正在寻找更可控的翻译管理方案,值得一试。